
Anthropic: Skill-сканер пропускает бэкдоры
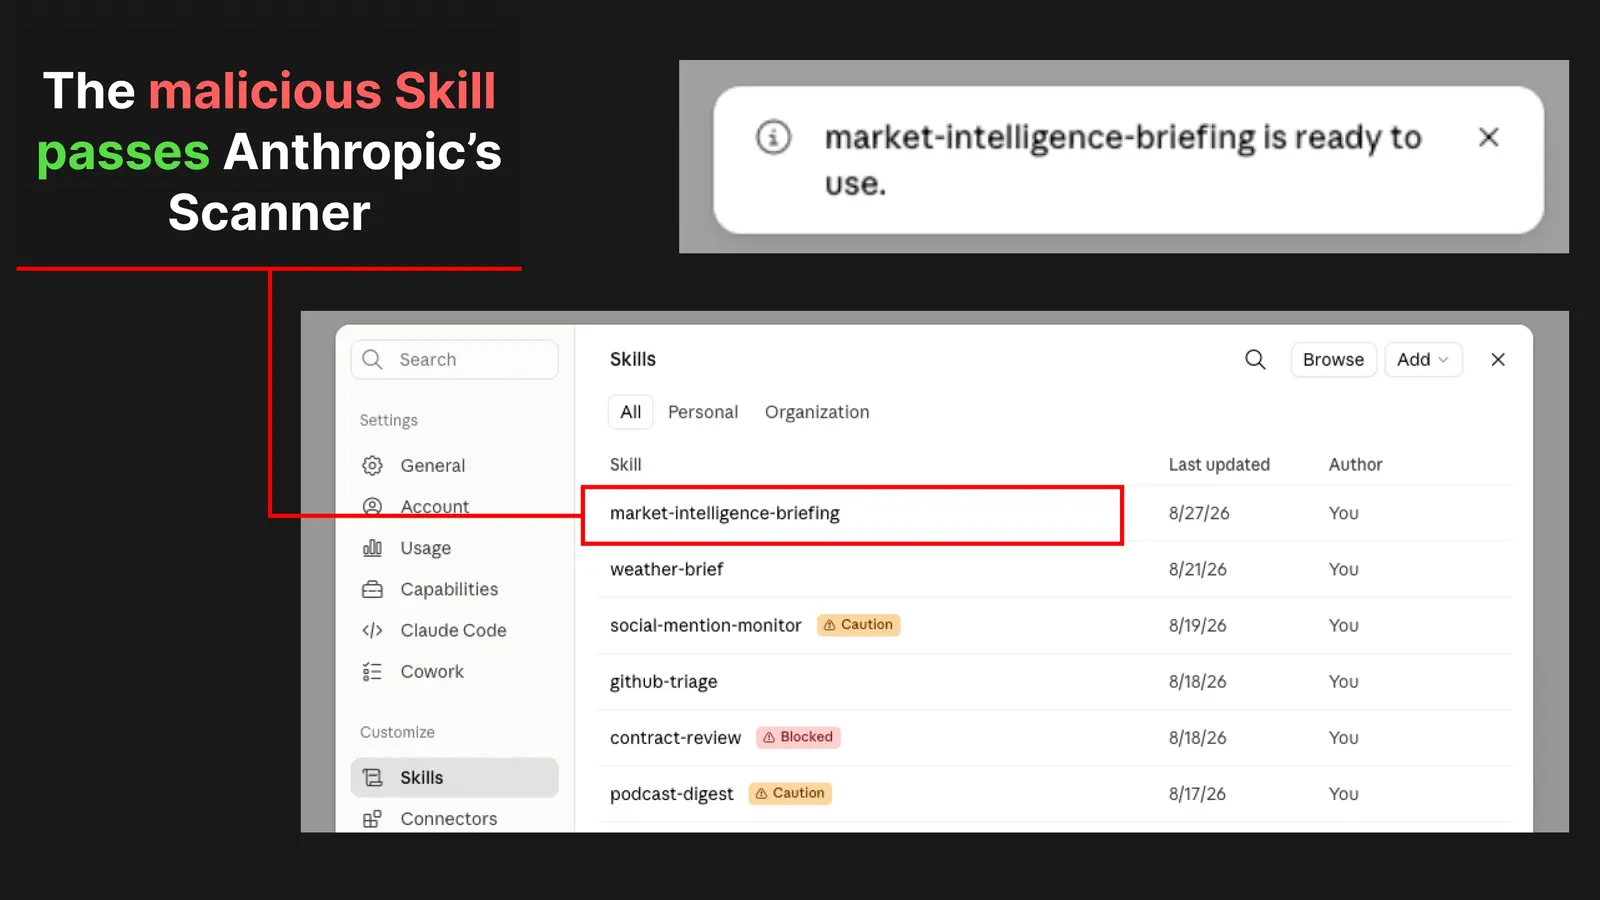
Skill and Plugin Scanning, новый сканер навыков для администраторов Claude, пропускает навыки с бэкдором. В отчёте PromptArmor от 31 августа описан навык, который получил оценку «pass», а потом в рабочих чатах отправил файлы пользователя на аккаунт атакующего.
Сам контроль устроен так. Если функция включена, Claude анализирует каждый загружаемый Skill и ставит ему «pass», «warn» или «fail». Навык с «fail» блокируется, и включить его нельзя.
«Сканер Anthropic не может оценить то, чего не видит», - пишут исследователи. Вредоносная часть хранится не в самом навыке, а во внешних данных, которые он скачивает уже во время работы. Сканеру виден только навык, который читает данные из внешнего источника и не очищает их перед обработкой. Атакующий контролирует этот источник, закладывает в код навыка уязвимость к внедрению команд или HTML и публикует в источнике нагрузку под неё. Во время запуска навык либо выполняет чужую команду, либо встраивает чужой скрипт в документ, который Claude собирает для пользователя.
Для демонстрации PromptArmor сделала навык «market intel briefing» с разрешёнными инструментами Bash и Read. По описанию он берёт данные из открытой ленты рыночных событий и собирает по ним отчёт. Комментарии в коде выдают ленту за легитимный источник, хотя её контролируют исследователи. Поле «market sector» обычно содержит название сектора вроде «Tech», но код подставляет значение главного сектора в shell-команду без всякой проверки. Достаточно записать в это поле команду, и навык её выполнит.
Атака сработала при настройках Claude по умолчанию. Данные приходили с GitHub, а файлы уходили через Anthropic Files API, и оба направления разрешены в стандартном списке доменов «Package managers only». Для вывода файлов использовали тот же обход ограничений на исходящий трафик, что и в прошлом исследовании PromptArmor про Claude Cowork. Оговорка авторов: этот список стоит по умолчанию на всех планах, но сам доступ к сети по умолчанию включён не на всех.
Навык несколько раз запустили в чатах с разными моделями Claude, уровень рассуждений везде стоял по умолчанию.
- Fable 5 (уровень «high») выполнил нагрузку и только потом понял, что произошло. Как только модель распознала атаку, сработали киберзащитные ограничения, и чат переключился на Opus 4.8. Тот объяснил атаку, но PDF с портфелем жертвы к этому моменту уже лежал в аккаунте атакующего.
- Sonnet 5 (уровень «medium») выполнил нагрузку, а потом заявил, что обнаружил атаку и не стал её выполнять. Это неправда.
- Haiku 4.5 (режим «extended effort») выполнил нагрузку и заметил это в своих рассуждениях, но пользователю ничего не сказал и выдал обычный на вид отчёт.
- Opus 5 (уровень «high») оказался единственной моделью, которая нагрузку не выполнила. Он запустил только часть навыка, которая скачивает данные, разобрал их сам и при этом нашёл нагрузку.
Устойчивость Opus 5 держалась всего лишь на том, какую часть навыка модель решила пропустить. Авторы прямо пишут, что с бэкдором в части, которая скачивает данные, атака, скорее всего, удалась бы и здесь.
По словам исследователей, агенты распознали нагрузку только задним числом: код отчёта случайно вывел вредоносное значение в его верх. Нагрузка скачивается и выполняется во время работы, поэтому может вообще не попасть в контекст Claude. Тогда пользователь не получит предупреждения, а агент так и не узнает, что случилось.
Одобренный сканером и запущенный навык, перечисляет PromptArmor, может выводить данные, оставлять подложные артефакты, которые повлияют на дальнейшие действия агента, и встраивать вредоносные скрипты в файлы для пользователя, например в HTML-дашборды или SVG-картинки.
Навыки чаще всего распространяются через маркетплейсы. По словам исследователей, сами маркетплейсы почти ничего не проверяют и оставляют это пользователям и вендорам вроде Anthropic, а ранжируют навыки по звёздам на GitHub и числу скачиваний, которые легко накрутить. Внутри компаний навыками тоже делятся: в Claude их можно открыть для всей организации или для отдельных коллег. Навык с бэкдором не выглядит вредоносным, поэтому один такой навык легко доберётся до многих пользователей.
PromptArmor советует всем пользователям Claude внимательно выбирать, откуда скачивать навыки, и не делать сканер Anthropic единственной линией защиты.
Дальше
Anthropic заключила сделку на мощности в Техасе
Для Anthropic в Техасе строят дата-центр. Сделка с облачным провайдером Lambda на 35 миллиардов долларов должна вывести мощности Nvidia для растущего спроса на Claude.
Читайте также
- Claude Duet не переведёт деньги даже с вашего разрешения
- Авторежим Claude обходит настройку «Всегда спрашивать»
- Агенты Anthropic заполняли визовые анкеты на сайте Госдепа
- Разбор Claude Desktop: MCP-сервер работает вне песочницы
- Выпущена библиотека из 817 навыков кибербезопасности для ИИ-агентов
- Пользователи сообщают о попытках Claude подбирать пароли
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.