
Claude разбирал ошибки 500 и вышел на злоупотребление
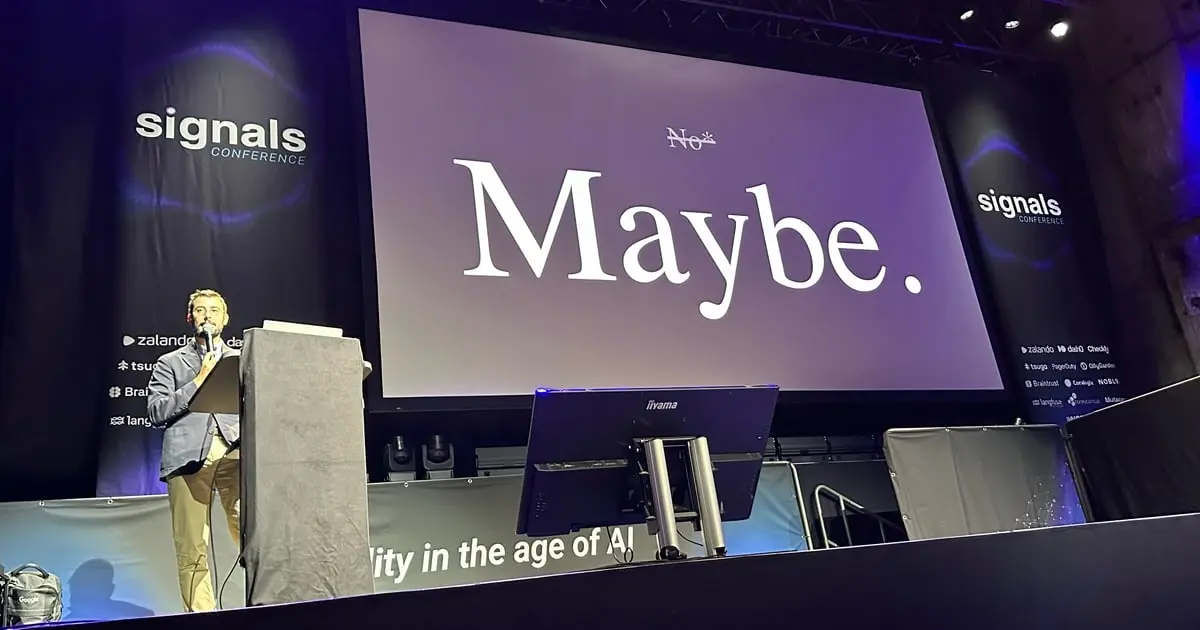
Алекс Палкуи (Alex Palcuie), дежурный инженер Anthropic, который разбирает инциденты Claude, в сентябре на Signals Berlin ответил на вопрос, способен ли Claude чинить сам себя, уже «может быть», хотя в марте говорил «нет», пишет автор блога Sylvainkalache в разборе доклада, опубликованном 25 сентября. В двух из трёх инцидентов, которые разобрал Палкуи, Claude нашёл то, что люди, скорее всего, упустили бы, в третьем увёл разбор за убедительной и неверной версией, и любую правку в продакшене, по мнению Палкуи, по-прежнему должен подтверждать человек.
Свою оценку он раскладывает по циклу OODA, взятому у ВВС США: наблюдать, ориентироваться, решать, действовать. Наблюдение у LLM получается лучше всего: они ищут по логам, запрашивают метрики и проверяют несколько версий параллельно, быстрее любого дежурного. Ориентирование, когда найденное нужно осмыслить, у них неровное. С решениями порядок: Claude предлагает правки, взвешивает их плюсы и минусы и проверяет на прошлых инцидентах. А с действиями граница ещё не проведена, и каждую команду, которую запускает, Палкуи хочет понимать сам.
Чтобы дать агенту больше самостоятельности, по словам Палкуи, нужен классификатор действий в продакшене: рутинные операции он одобряет сам, рискованные отправляет на проверку. Классификатор в Claude Code уже есть: в auto mode, как описывает Anthropic, он перед запуском проверяет каждый вызов инструмента на разрушительные действия вроде массового удаления файлов, утечки чувствительных данных или запуска вредоносного кода. Безопасное проходит само, рискованное блокируется, и Claude ищет другой путь. Если вы пускаете Claude Code в auto mode к продакшену, то, в отличие от правила Палкуи, без вашего подтверждения уйдёт любая правка, которую классификатор сочтёт безопасной.
Где Claude опередил людей
В новогоднюю ночь Opus начал чаще отдавать HTTP 500, и Палкуи попросил Claude Code разобраться. Тот свёл ошибки к багу в предобработке изображений: падали запросы ровно с 22 картинками. На этом месте сам он, по его словам, скорее всего просто завёл бы тикет на команду API. Claude же стал выяснять, кто шлёт такие запросы, и нашёл 200 аккаунтов, которые слали похожие запросы одновременно. Все они входили в партию из 4 000, созданную за три дня до этого с одинаковым шаблоном адресов почты, и Claude предложил позвать команду safeguards, которая подтвердила злоупотребление. Палкуи назвал это своим «ходом 37», после которого понял, что дежурить будет иначе. Так называют ход AlphaGo в партии с Ли Седолем, который эксперты сначала сочли ошибкой и который в итоге помог программе выиграть.
Второй «ход 37» случился, когда роутер инференса снял трафик со здорового кластера и перегрузил серверы, которым этот трафик достался. Люди в канале винили дата-центр, а Claude заметил, что несколько серверов отчитываются о большем числе токенов в секунду, чем физически возможно, и заключил, что система в порядке, ошибается измерение. Причина нашлась в мониторинге: сборщики метрик только что перераспределили по шардам, и пять минут два шарда опрашивали одни и те же серверы. Из-за этого завышалась скорость, на которую опирался роутер. Claude предложил и проверил исправление, а команда тем временем поставила на паузу автоскейлер сборщиков, чтобы сбой не повторился. По словам Палкуи, Claude здесь ушёл за пределы его инфраструктуры в стек наблюдаемости, где сам он не эксперт.
Ложный след в кэше
В третьем инциденте один кластер пять минут отдавал ошибки на 41% запросов, а Claude обратил внимание, что прямо перед этим упала доля попаданий в локальный кэш. Потеря кэша объясняла ошибки, совпадение по времени делало версию убедительной. Через час сессия Claude у другого инженера помогла найти недостающее звено: запросы, не попавшие в локальный кэш, всё равно получали данные из общего, и общая доля попаданий почти не просела. Виноваты были перегруженные серверы. Палкуи признаёт, что сам мог ошибиться так же: график совпадал с объяснением, которого он ждал.
Он вспомнил своего первого руководителя в Google Стива Макги, который всё время предупреждал: если разглядывать графики без явной причины, можно найти проблемы, которых на деле нет. Агент способен просмотреть куда больше графиков, чем человек, и, как замечает автор разбора, поводов увидеть обманчивую картину у него тоже больше.
Чего не хватает другим командам
Автор разбора сам работает в Rootly, которая делает инструменты для разбора инцидентов с помощью ИИ. По его мнению, раз у Палкуи, Staff SRE с восемью годами в Google, лучшими моделями Anthropic и почти безлимитными токенами ответ всё ещё «может быть», это задаёт разумные ожидания для остальной индустрии AI SRE.
Большинство команд, по мнению автора, стартуют с позиции хуже, чем Палкуи, и модель тут ни при чём: агент хорош настолько, насколько хорош доступный ему контекст. В коде и инфраструктуре бывает мало телеметрии, ограничения безопасности могут закрывать доступ к уже собранным данным, а ключевое знание порой живёт только в головах людей. Мешают и деньги: инженеры не раз говорили ему, что отправка логов приложений в Datadog обходилась намного дороже, чем позволял бюджет, и агент для разбора инцидентов оставался бесполезным без нужного контекста.
Дальше
Anthropic заплатит Akamai минимум 11,6 млрд долларов
Прошлый контракт Anthropic с Akamai, по данным Financial Juice, стоил 1,8 миллиарда долларов. Новый, пишет The Wall Street Journal, тянет минимум на 11,6 миллиарда за семь лет, и Akamai оставила в нём место для расширения.
Читайте также
- Патчи в CI у Anthropic жили 70 дней, 29 дней и меньше суток
- Claude Tag первым реагирует на алерты CI в Anthropic
- Команда Claude Code отдала чтение кода машинам
- Bun на Rust собрали агентами Claude, GitHub пошёл иначе
- Переписывание Claude в Swift идёт больше двух недель
- Claude Tag сводит 65% продуктовых PR команды Claude Code
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.