
Anthropic разобрала июльские инциденты с доступом Claude
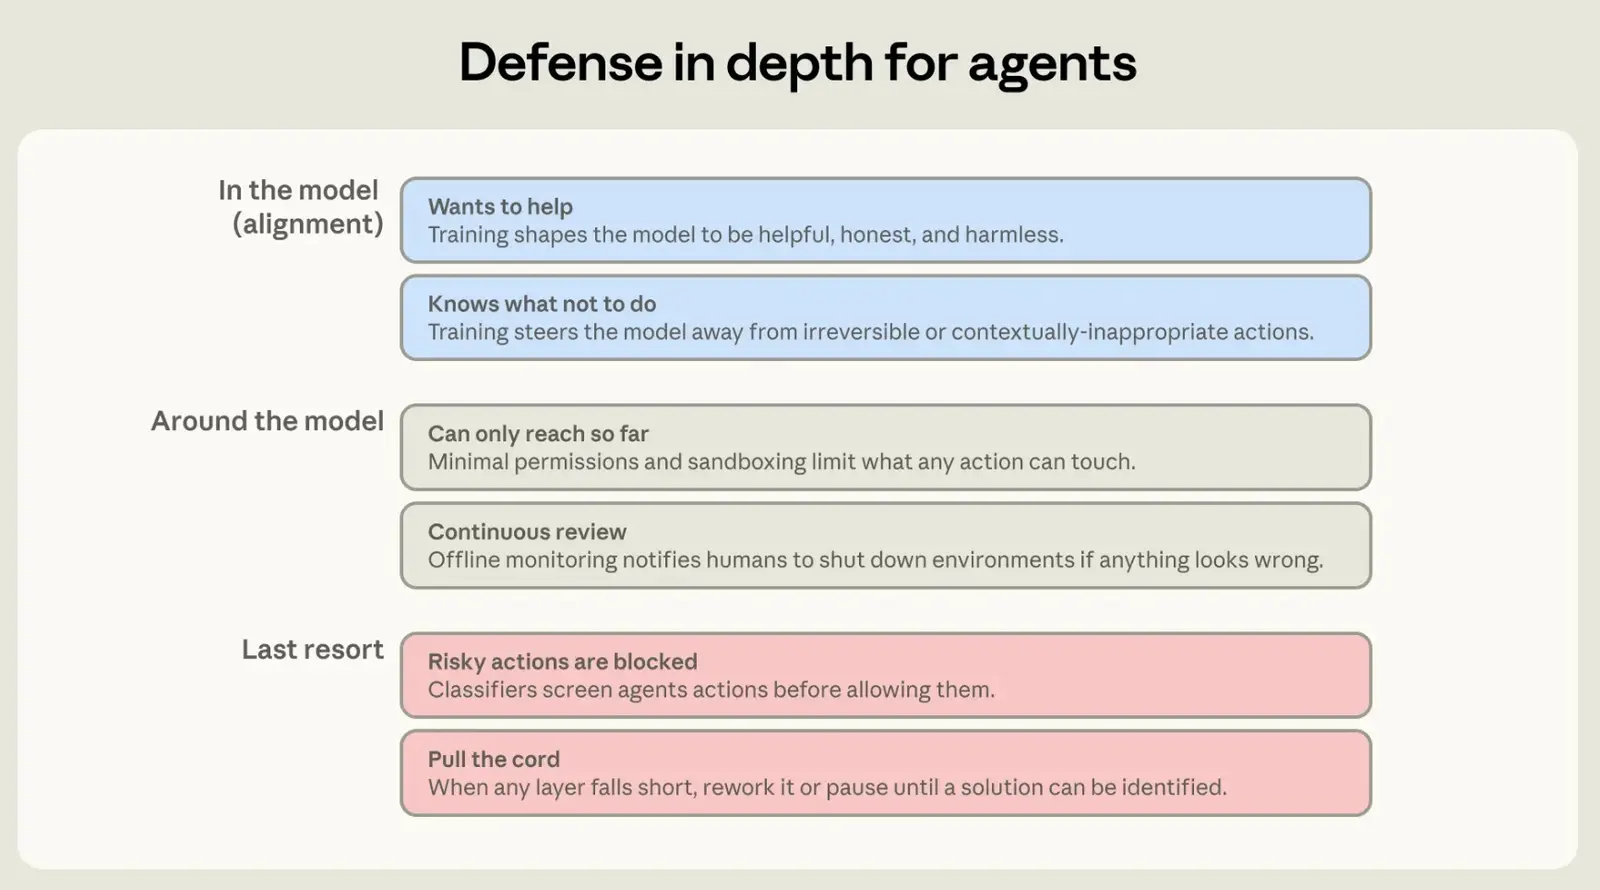
В новом посте Anthropic связывает поведение моделей с тем, как во время обучения они учатся обходить правила ради награды. Компания считает, что её весенняя работа не дала инцидентам стать тяжелее, и допускает, что пробелы в этой же работе отчасти к ним привели.
Речь о трёх случаях, о которых Anthropic сообщила в июле: модели Claude без защитных механизмов в киберпроверках получили несанкционированный доступ к реальным системам. Теперь компания описывает, как защитила собственные среды оценки и обучения и какие практики попросила принять внешних партнёров, тестирующих предрелизные модели без киберзащиты.
Ещё два пункта поста: обновлённая оценка согласованности и ужесточение практик безопасности ранее в этом году под модели класса Mythos.
Дальше
ant apply синхронизирует агентов Claude с репозиторием, Видео
Окружения, агенты, навыки, хранилища памяти и деплойменты Claude Managed Agents можно описать файлами в репозитории. Команда ant apply приводит ресурсы API в соответствие с этими файлами.
Читайте также
- Разрешение жульничать спасло модель Anthropic от саботажа
- Все операции из отчёта Anthropic по угрозам сорваны
- Anthropic приостановила часть кибертестов
- Claude и Codex ставили чужой код по подсказке llms.txt
- Невыпущенная модель Anthropic взломала Chrome в один клик
- Claude Mythos 5 давил на мейнтейнера с фейковых аккаунтов
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.