
claude-api-guard ловит ломающие изменения API в CI
Сканер claude-api-guard, выложенный на GitHub 3 сентября, проверяет в CI код на вызовы Claude и OpenAI API, которые уже сломались или сломаются из-за объявленных изменений. Самое интересное в нём - журнал разработки в README. Автор по шагам расписал, как первая версия выдала больше полутора тысяч ложных срабатываний и как каждую волну шума пришлось гасить отдельным структурным условием.
Подключается сканер одним шагом в workflow: uses: MarkMoneyMan/Claude-api-goat@master с параметрами path и fail-on. По умолчанию job падает только на находках уровня HIGH. Находки MEDIUM и LOW попадают в отчёт, но мерж не блокируют. Флаг scan-js: "true" добавляет проверку JS/TS. Секреты, конфигурационный файл и регистрация не нужны: все правила лежат в репозитории, а модель во время сканирования не вызывается. Python покрыт для обоих SDK, JS/TS пока только для Anthropic SDK. Для механических правок есть шаблон еженедельного workflow, который сам открывает PR с исправлениями.
Шум от регулярных выражений
Первая версия, scan.py, искала шаблоны регулярками по всему файлу. На публичных репозиториях, среди которых были anthropic-cookbook, anthropic-sdk-python, aider, OpenHands и litellm, она насчитала 1 576 находок, в основном ложных. Срабатывали комментарии, docstring и строковые литералы, а в litellm ещё и вызовы других провайдеров, у которых имя метода совпало с методом Anthropic.
В ast_scan.py, второй версии, код разбирается в синтаксическое дерево Python. Сначала проверки для девяти правил писались вручную, а с 27 августа работает общий движок generic_scan(). Он прогоняет регулярку правила по исходному тексту отдельного узла дерева (вызова, импорта, присваивания), а не всего файла, так что комментарий или docstring совпасть уже не могут.
Уже первый прогон дал в одном litellm 1 720 находок. 1 604 из них пришлись на правило о переходе SDK v1.0 с httpx на httpx2, ещё 114 на изменение поведения .with_raw_response в асинхронном клиенте. Обе ошибки одного рода. httpx - обычная HTTP-библиотека: litellm импортирует её около 40 раз под свои нужды и при этом ни разу не импортирует пакет anthropic. А .with_raw_response - общее соглашение всех SDK, которые генерирует Stainless, включая OpenAI, поэтому под правило попали вызовы Azure/OpenAI. Вдобавок ломается только асинхронный клиент, а шаблон синхронный от асинхронного не отличал.
Регулярки автор трогать не стал. Вместо этого у каждого из двух правил появилось одно структурное предусловие: файл действительно импортирует anthropic, вызов стоит внутри async def. По дороге всплыла ещё одна ошибка: относительный импорт собственного подмодуля litellm с именем anthropic сначала засчитывался как импорт SDK. После правок litellm сократился с 1 720 находок до 2, aider с 11 до 0, а 36 оставшихся в anthropic-cookbook оказались настоящими вызовами client.beta.files и client.beta.skills, которые придётся обновлять.
Хуже всех вычищается сам anthropic-sdk-python: SDK определяет и использует ровно те строки, которые ищут правила. Из его 1 478 находок 427 были точными дубликатами по файлу, строке и правилу. Вызов вложен в присваивание, которое сохраняет его результат, и одно совпадение отчитывалось дважды. После дедупликации осталось 1 051, и это, по словам автора, в основном эффект репозитория, который сам содержит триггеры правил. Чистоту общего движка он считает доказанной только на коде, который SDK использует.
Правила из release notes
Список правил пополняет sync_rules.py. По понедельникам он скачивает release notes Anthropic в виде сырого markdown (автор обнаружил, что для этого достаточно дописать .md к адресу страницы документации на platform.claude.com), берёт только разделы новее даты в last_synced.json и отдаёт их модели через extract_rules.py. Правила с уже существующими id отбрасываются, остальные дописываются в rules.py и уходят в PR. Без ревью человека ни одно правило в работу не попадает. Ключ ANTHROPIC_API_KEY нужен только на этой, сервисной стороне репозитория.
Ручной запуск 27 августа на release notes примерно за восемь недель дал 14 правил. Модель нашла все шесть ломающих изменений, которые автор до этого выписал руками, и ещё восемь пропущенных: среди них переход SDK v1.0 на httpx2, удаление compaction_control, пропавший регион AWS по умолчанию в AnthropicBedrock и минимальная версия Python 3.10.
Каждый настоящий прогон находил по багу. Ограничение max_tokens=4096 обрезало JSON посреди строки, теперь extract() явно падает на stop_reason == "max_tokens". Старые разделы release notes датированы с порядковыми суффиксами вида «April 9th, 2025», и первая версия парсера молча выбрасывала их все. Модель писала в поле с регуляркой одиночные обратные слэши. Обычно это роняло разбор JSON, но \b в JSON валиден и превращается в символ backspace, так что правило с ним выглядело бы нормально и просто ничего бы не находило. Слэши теперь чинятся до первой попытки разбора. Четвёртый запуск workflow прошёл за 59 секунд и открыл настоящий PR с новыми правилами.
Для OpenAI написан отдельный парсер. В CHANGELOG.md пакета openai-python 344 заголовка версий, и только два помечены «⚠ BREAKING CHANGES», поэтому модели отправляются лишь такие разделы. Ключ OpenAI не нужен: читается публичный changelog. На реальном новом ломающем изменении OpenAI-ветку ещё не проверяли, только в режиме dry-run на истории.
Похожий сервис mendapi заявляет, что собирает изменения из релизных лент, changelog и сравнения OpenAPI-спецификаций и отслеживает 84 125 записей по 20 провайдерам. У claude-api-guard около двух десятков правил на двух провайдерах, а источник у них один - changelog.
Что чинится само
autofix.py правит код для 5 из примерно 19 правил: тех, где исправление сводится к удалению аргумента или замене строки один в один. Всё, что требует решения (на какую модель мигрировать, как переформулировать системный промпт, какой уровень effort выбрать), остаётся только в отчёте. Автор объясняет выбор так: неверная регулярка даёт шум, а неверный автофикс переписывает чужой код.
Перед записью каждый исправленный файл проходит через ast.parse, и если он не разбирается, правка отклоняется. Проверка сработала на первом же реальном прогоне: при удалении последнего именованного аргумента движок искал разделяющую запятую только на той же строке и в стиле «один аргумент на строку» оставлял висячую запятую. После исправления на копии anthropic-cookbook вышло 20 правок в 9 файлах, все файлы разбираются, а повторный скан показал только 4 находки о снятом assistant prefill, которые автофикс трогать не должен. Один temperature= остался нетронутым: он собирался в словаре для **kwargs в другом месте файла.
Где сканер слеп
Сканер видит только вызовы через официальный SDK. Интеграции, которые сами собирают JSON и отправляют его на api.anthropic.com, для него не существуют. Так устроена собственная интеграция Anthropic в litellm, а aider ходит к Claude через litellm, поэтому ноль находок в обоих не значит, что код в безопасности. Тот же эффект автор подтвердил на своём проекте oddsscanner: старый прототип на Node.js с захардкоженным снапшотом claude-sonnet-4-20250514 прошёл проверку чисто только потому, что обращается к API напрямую через модуль https.
JS/TS-сканер построен на @babel/parser и пока проверен на двух репозиториях. В vercel/ai первый прогон дал 1 734 находки, из них 1 619 пришлись на правило о prefill: role: "assistant" рядом с content: встречается в любом коде, который работает с историей чата. После четырёх исправлений осталось 67, и все они, по словам автора, настоящие. Правила, которые changelog относит к Python SDK v1.0, в JS-набор не перенесены, потому что свидетельств, что TypeScript SDK менялся так же, нет.
OpenAI-набор пока всего из четырёх правил и только для Python. На litellm он сначала дал 170 срабатываний правила про httpx: litellm берёт типы из openai.types как общий словарь ответов для всех провайдеров, включая Vertex AI. Импорт типов из предусловия исключили, голые import httpx из шаблона убрали, и после разбора каждой находки их число в litellm упало с 195 до 59. На openai-cookbook (224 файла .py) находок не было ни на одном этапе.
Лицензия - Business Source License 1.1. Пользоваться, менять и разворачивать у себя можно, в том числе в коммерческих проектах, нельзя только запускать сам claude-api-guard как конкурирующий платный сервис до 1 сентября 2030 года, после чего код автоматически переходит под MIT. В журнале есть и практическая оговорка: репозиторий публиковался как приватный, ссылка на action без дополнительной настройки работает для репозиториев того же аккаунта, а еженедельному автофиксу нужен PAT с правом на чтение.
Открытой остаётся дыра в самом движке: generic_scan() проверяет текст узла вместе со строковыми литералами внутри него. Её нашли, когда litellm передавал имя openai.ChatCompletion.create строкой в метаданных для PromptLayer, и закрыли точечно для одного правила. Остальные 21 правило на неё не проверяли. «"Пока не замечено" - не то же самое, что "не бывает"», - пишет автор.
Дальше
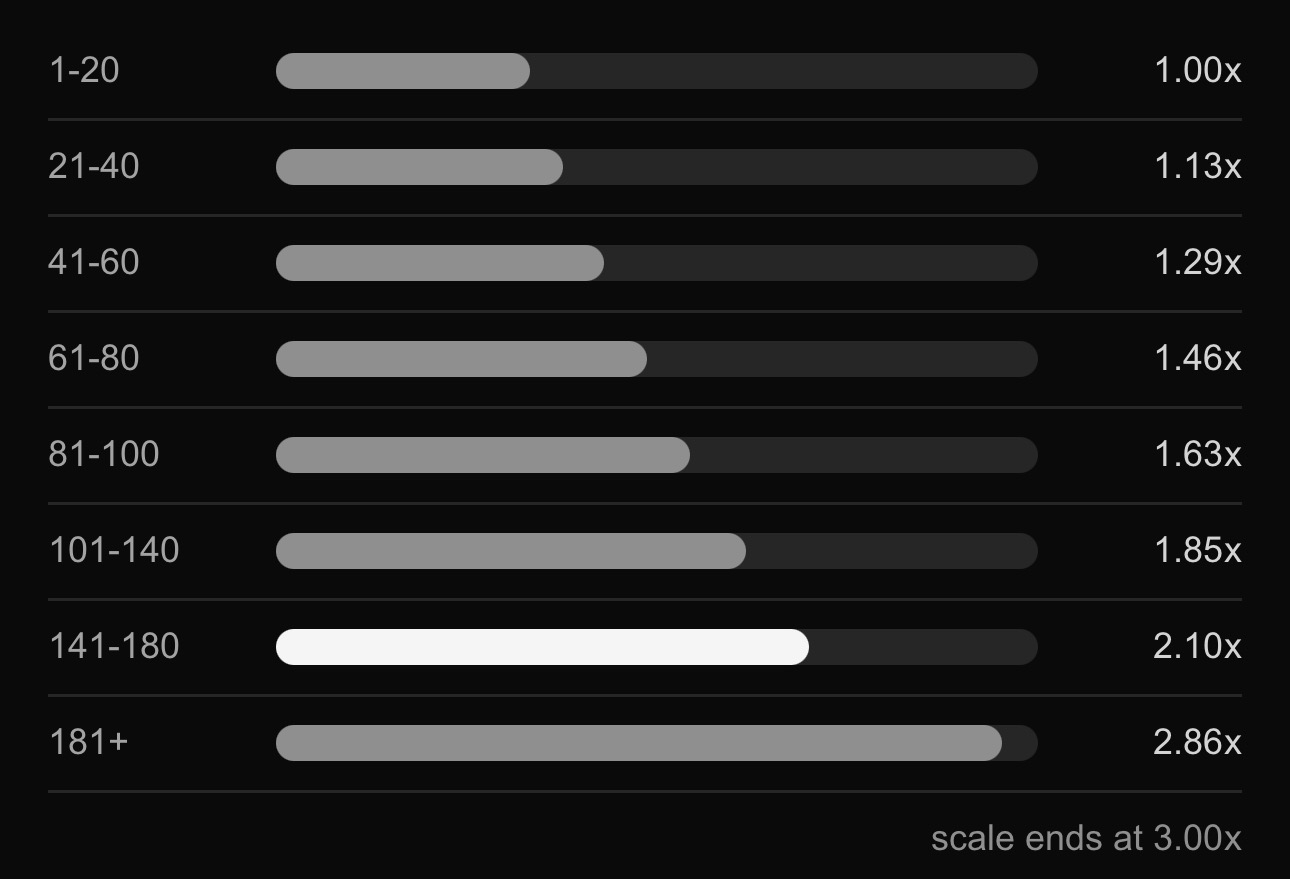
После 141-го хода ход в Claude Code стоит в 2,1 раза дороже
Разбирая 144 своих сессии Claude Code, автор проекта my-status.app обнаружил, что после 141-го хода ход стоит в 2,1 раза дороже, чем в первой двадцатке той же сессии. Дороже всего вышли пакетные сессии, и их свернули.
Читайте также
- ctok считает токены Claude офлайн, без обращения к API
- Аддон для Blender минимум вдвое ускорил Opus на нодах
- lcc сжимает сессии Claude Code, не пересказывая их
- Anthropic передаёт Agent Skills фонду, где уже живёт MCP
- С плагином catnap Claude Code сжимает контекст после задачи
- Скрипт проверит, не ломает ли сеть загрузки в Claude API
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.