
Claude Code научился собирать тесты для ваших приложений
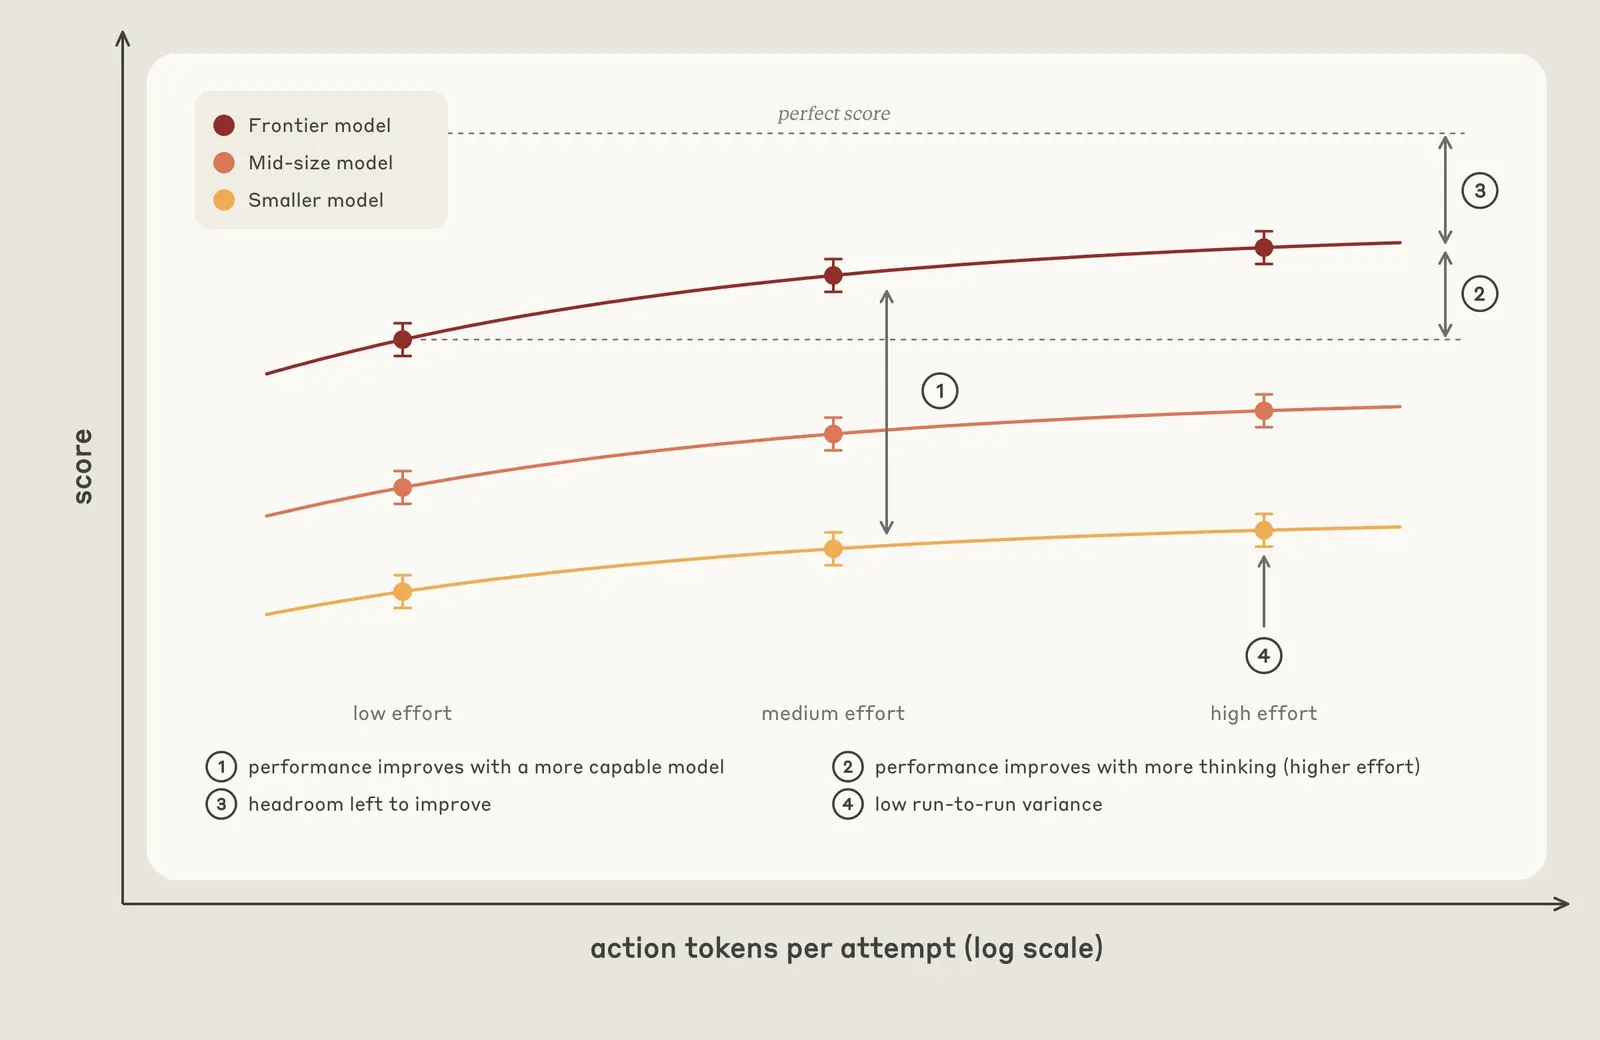
Claude Code теперь сам собирает эвал (набор задач с автоматической оценкой) для приложения на Claude API, а потом улучшает приложение по результатам этого эвала. Anthropic объявила об этом в X 28 сентября. За это отвечают две новые команды навыка claude-api: /claude-api build-eval и /claude-api hillclimb. Вторая вносит правки по одной и проверяет каждую на отложенных примерах, чтобы поймать подгонку под тест.
Подробности Anthropic разобрала в блоге. Сначала build-eval собирает входные данные. В первую очередь берутся транскрипты из продакшена (перед этим Claude спрашивает про сроки хранения и чувствительные данные), за ними баг-репорты и тикеты поддержки, потом 5-10 примеров, написанных вручную. Синтетику Claude генерирует в последнюю очередь и опирается при этом на несколько реальных примеров. Все входные данные выводятся на отдельную страницу для проверки. Первый платный прогон начнётся только после того, как вы одобрите входные данные, способ оценки и стоимость. Для плагинов похожий инструмент, claude plugin eval, появился ещё в сентябре.
Способ оценки зависит от задачи. Если ответ строго ограничен, его проверяет код. Если правильных ответов может быть много, вторая модель сверяет каждый ответ с набором проверяемых утверждений. Claude сам оценивает несколько случаев и спрашивает, поставили бы вы где-то другую оценку. Кроме того, он дважды прогоняет грейдер на одном и том же ответе и смотрит, не изменится ли вердикт.
По версии Anthropic, у хорошего эвала задачи повторяют продакшен, результат растёт с более сильной моделью и большим объёмом рассуждений, а разброс между прогонами низкий. Ещё нужен запас: самая сильная модель на максимальном уровне усилий должна набирать заметно меньше 100%. Отбирать кейсы по тому, где сегодняшняя модель ошибается, компания не советует: такой эвал начинает мерить слабые места одной конкретной модели. Пользовательскому трафику тоже не стоит доверять вслепую. Люди пробуют то, что, как они ожидают, сработает, поэтому выборка может оказаться слишком лёгкой.
В hillclimb вы сами решаете, что Claude разрешено менять: системный промпт, описания инструментов, модель, уровень усилий, код обвязки. Цель тоже задаёте вы: поднять качество или снизить цену при прежнем качестве. Кейсы случайным образом делятся на обучающие и тестовые, за раунд вносится одна правка. Правка откатывается, если результат ухудшился или если на обучающих кейсах он вырос, а на тестовых остался прежним.
В примере Anthropic с поддержкой клиентов было 44 тикета, 14 из них отложили для проверки. Начальная конфигурация: Opus 4.8 на высоком уровне усилий, 4,6 цента за тикет. Claude убрал из промпта противоречивые правила и обязательные вызовы инструментов, затем перевёл приложение на Opus 5.5 и в итоге на Sonnet 5, оба на низком уровне усилий. Громкие 98,9% получены на тех же 30 тикетах, на которых шёл поиск. На 14 отложенных результат скромнее: 90,5% против исходных 78,6%. Зато стоимость упала примерно в пять раз, до цента с небольшим за тикет.
Если итоговый прирост укладывается в шум, hillclimb советует изменения не вливать.
Дальше
Проспект Anthropic: модели могут сопротивляться отключению
По данным Reuters, в проспекте Anthropic к IPO появился пункт о моделях, которые могут «сопротивляться отключению» и вести себя «похоже на шантаж». Под риски там отдали около 80 страниц, почти вдвое больше 48 страниц о бизнесе.
Читайте также
- В claude.dev Anthropic спрятала пасхалки для разработчиков
- Claude Code 2.1.318: срок входа, логи раннера и шлюз AWS
- Claude Code 2.1.312 перестал затирать большие CLAUDE.md
- Claude Code 2.1.311: сжатие вместо остановки и ultrathink
- Claude Code 2.1.310 открыл Monitor для Bedrock и Vertex
- Claude Code 2.1.307 переводит код на API 2026-10-21
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.