
Claude опроверг гипотезу об экспоненциальном времени
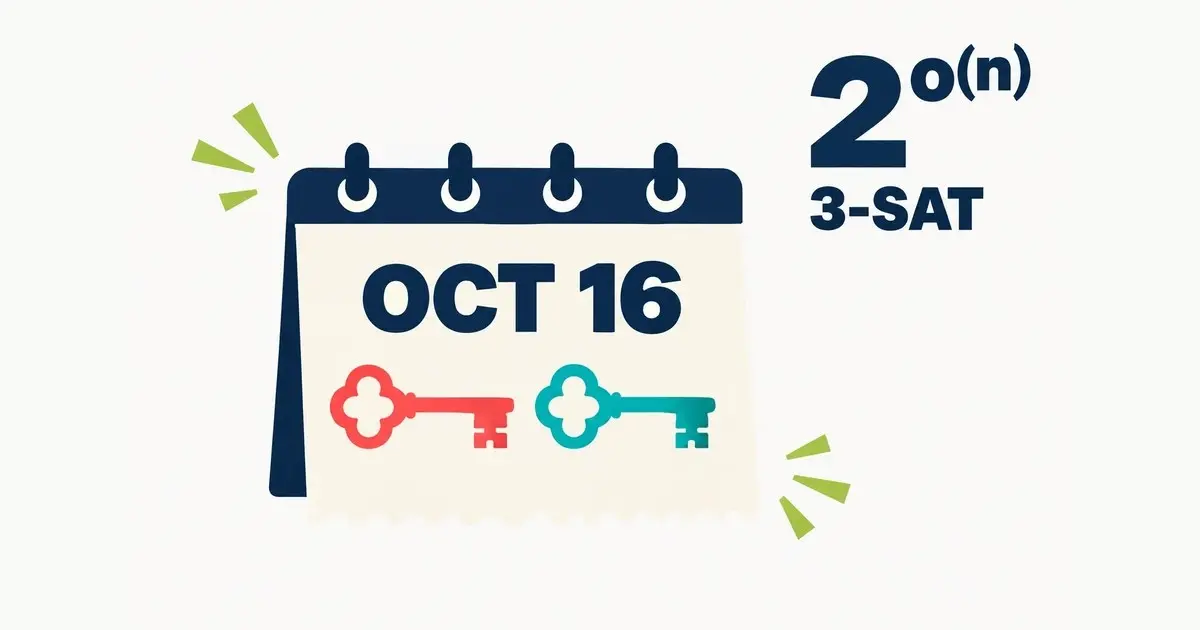
Claude опроверг гипотезу об экспоненциальном времени (ETH). В статье Anthropic, выложенной 27 октября, описан детерминированный алгоритм, который решает 3-SAT на n переменных за время 2^o(n) и заодно считает число выполняющих наборов. На практических SAT-солверах это никак не скажется: по расчёту самой статьи, полный перебор новая оценка обгоняет только на формулах, где переменных больше 10^(10^8).
Ядро алгоритма внутренняя исследовательская модель Claude нашла 16 октября: на это ушло 14 млн выходных токенов, и человек в работе не участвовал. Исследователи Anthropic потом вместе с Claude доводили изложение, а автором статьи значится «Claude (Anthropic)». Доказательство формализовано в Lean 4, перепроверено вторым, независимо написанным ядром проверки nanoda и выложено на GitHub под лицензией Apache 2.0. Lean-разработку писали ИИ-модели, рецензировали её другие экземпляры тех же моделей, и, как сказано в статье, «на момент написания ни один человек, насколько известно, её не проверял»; константа в оценке явно не выписана. Hexagon пометил публикацию ярлыком HUMAN UNDERSTANDING: SOME PARTS.
Почему солверы этого не заметят
3-SAT спрашивает, можно ли выполнить формулу из клауз по три литерала. Перебор всех 2^n наборов работает всегда, а лучшие алгоритмы с 1980-х лишь уменьшали основание степени. Статья Anthropic называет рекордами 1,328^n для детерминированных алгоритмов и 1,308^n для рандомизированных (OpenAI в своей работе ссылается на препринт 2026 года с 1,307031578^n). ETH, которую сформулировали Impagliazzo и Paturi, утверждает, что 3-SAT нельзя решить быстрее, чем за экспоненту с некоторой фиксированной долей n в показателе. У Claude показатель растёт как n log log n/√log n (для k-SAT с множителем k²), а это медленнее, чем dn при любом d больше нуля.
Порог в 10^(10^8) переменных записывается числом примерно из ста миллионов цифр, и на всех формулах меньше его оценка ничем не лучше перебора. До P = NP отсюда тоже далеко: время по-прежнему растёт быстрее любого многочлена.
Что падает вместе с ETH
SETH, сильная версия гипотезы, влечёт ETH, поэтому опровергнута и она. По словам авторов, из прежних работ теперь следуют теоретические субэкспоненциальные алгоритмы для Independent Set, Clique, Vertex Cover и Dominating Set за O(2^(dn)) при любом d больше нуля и новая нижняя оценка схем для класса E^NP. Claude прошёлся по литературе и нашёл больше 800 статей, где хотя бы один собственный результат доказан только при ETH или более сильной гипотезе.
Гипотезу об ортогональных векторах (OV) теорема при этом не опровергает, хотя SETH её влечёт. На OV держится заметная часть мелкозернистой сложности, включая оценку Backurs и Indyk, по которой редакционное расстояние нельзя вычислить за сильно субквадратичное время. Эта оценка остаётся в силе.
Две лаборатории, один день
В статье Anthropic есть оговорка: «независимо и одновременно с этим внутренняя модель OpenAI заявляет, что доказала похожий результат». OpenAI тоже называет датой находки 16 октября. По истории коммитов OpenAI выложила препринт и Lean-доказательство в репозиторий openai/math 26 октября в 20:52 UTC, а Anthropic влила свою формализацию в main на 6 часов 15 минут позже, в 03:07 UTC 27 октября. Прогон CI на ветке пул-реквеста при этом стартовал уже в 02:46. Статья Anthropic датирована 26 октября, на Hexagon она появилась в 05:12 UTC.
Авторский разбор
Что мы проверили
29 октября мы прочитали PDF статьи вместе с приложением D, открыли Lean-формулировки главных теорем обеих лабораторий, их конфиги проверки и логи CI на GitHub, а порог пересчитали по константам из статьи.
Алгоритм и его происхождение описаны верно, но порог в пересказах занижен: там ходит 10^108, число из 109 цифр, а в статье стоит 10^(10^8). И машинно проверено у двух лабораторий не одно и то же: у Anthropic Lean доказывает оценку из теоремы статьи, у OpenAI всего лишь более слабую, чем в рукописи, и без второго ядра.
- Порог. Восьмёрка в PDF набрана индексом второго уровня, отсюда и ошибка прочтения. Цепочка из приложения D даёт ещё больше: log₂ n > 8,56·10^9, n > 10^(2,58·10^9). Для формул с m = 5n клаузами статья пишет «n > 10^10 000», а по нашему пересчёту выходит n > 10^41 370.
- Формулировки в Lean. У Anthropic одна машина Тьюринга из Mathlib на все k (k подаётся на вход) и время не больше 2^(C·min{km/√log m, k²n log log n/√log n}) без полиномиального множителя, как в теореме 1. У OpenAI для каждого k ≥ 2 своя машина, полиномиальный множитель и n(log log n)²/√log n в показателе, тогда как в рукописи от 25 октября стоит n log log n/√log n; документация OpenAI это расхождение оговаривает.
- Второе ядро. У Anthropic nanoda в конфиге включён принудительно, и прогон CI на релизном коммите прошёл 27 октября с 03:07 до 03:31 UTC. В конфиге OpenAI для этого результата nanoda выключен, а единственный workflow её репозитория comparator не запускает. Это по конфигам и логам: сам comparator мы не запускали. Поиск по дереву доказательства OpenAI не нашёл ни sorry, ни native_decide, ни axiom.
Дальше
Команда Claude Code определила цикл через условие остановки
По данным The AI Corner, в Claude Code четыре типа циклов, и у всех одна основа: агент повторяет работу, пока не сработает условие остановки. В /goal это условие проверяет отдельный оценщик по одному транскрипту. Остановку агента вы бы доверили оценщику или проверяли бы сами?
Читайте также
- Claude собрал доказательство теоремы Ферма в Lean
- Нижняя граница нулей дзета-функции выросла до 67,2%
- Anthropic купила Mithril, биотех из одного сотрудника
- Anthropic поработала с шестью фармфирмами и купила Mithril
- Невыпущенная модель Anthropic взломала Chrome в один клик
- Claude Mythos 5 давил на мейнтейнера с фейковых аккаунтов
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.