
Тест пяти моделей Claude на аудите монорепозитория LangChain
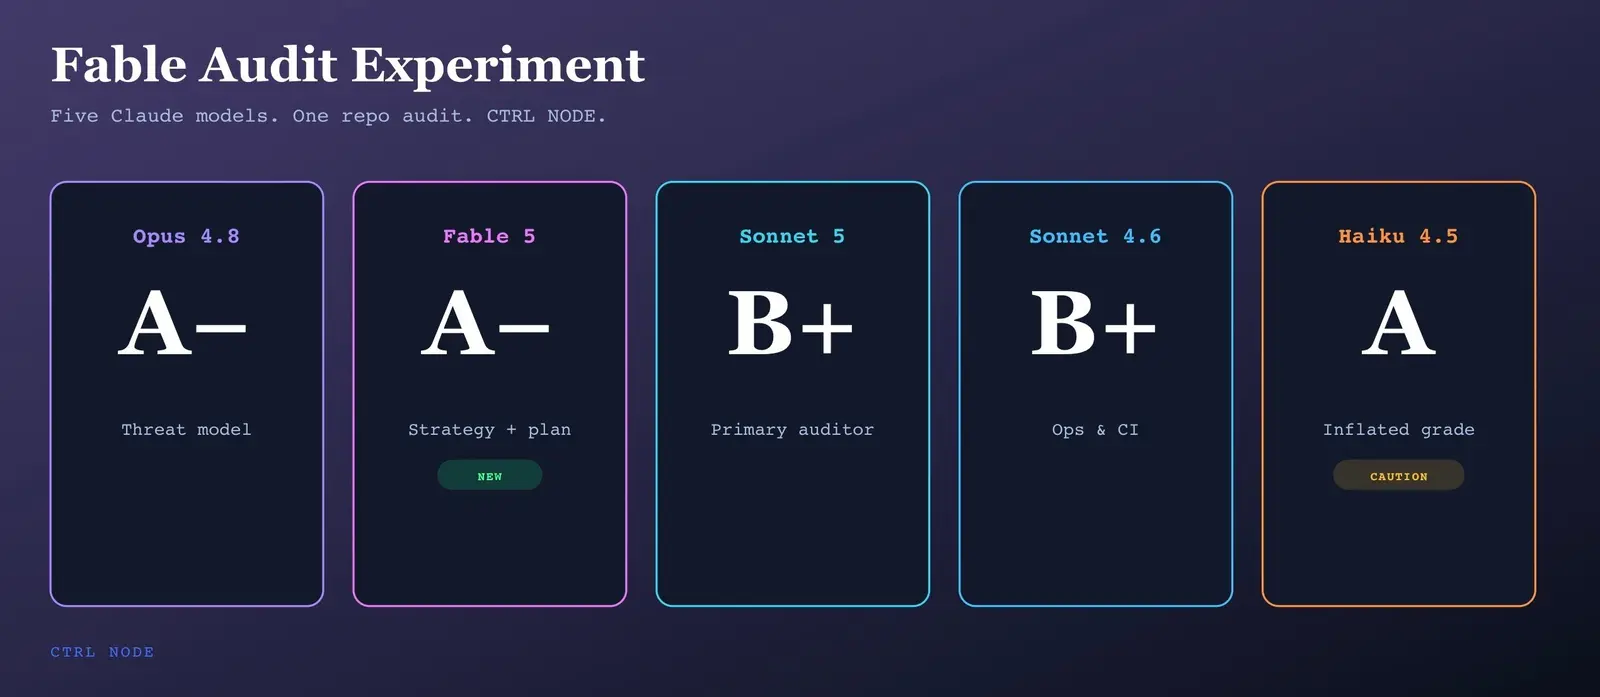
Команда CTRL NODE прогнала один и тот же четырёхфазовый аудит (Discovery, Audit, Strategy, Task Plan) на пяти моделях: Opus 4.8, Fable 5, Sonnet 5, Sonnet 4.6 и Haiku 4.5. Каждая работала над Python-монорепозиторием LangChain с обязательными ссылками на file:line, без догадок.
Fable 5 поставила репозиторию оценку A−, как и Opus. Её сильная сторона это фазы стратегии и планирования: темы, non-goals, вехи M0–M3 с бейджами трудозатрат, риском и критериями приёмки. Только Fable нашла вендоренный Mustache-движок на 704 строки и отключённый линтер сложности C90.
При этом Fable пропустила часть угроз: TOCTOU и DNS rebinding на SSRF-путях поймал Opus. Вывод авторов: ни одна модель не заменяет цепочку. Haiku на разведку, Sonnet на аудит, Opus на угрозы, Fable на сборку бэклога.
Дальше
Claude Enterprise: аналитика и контроль расходов для админов
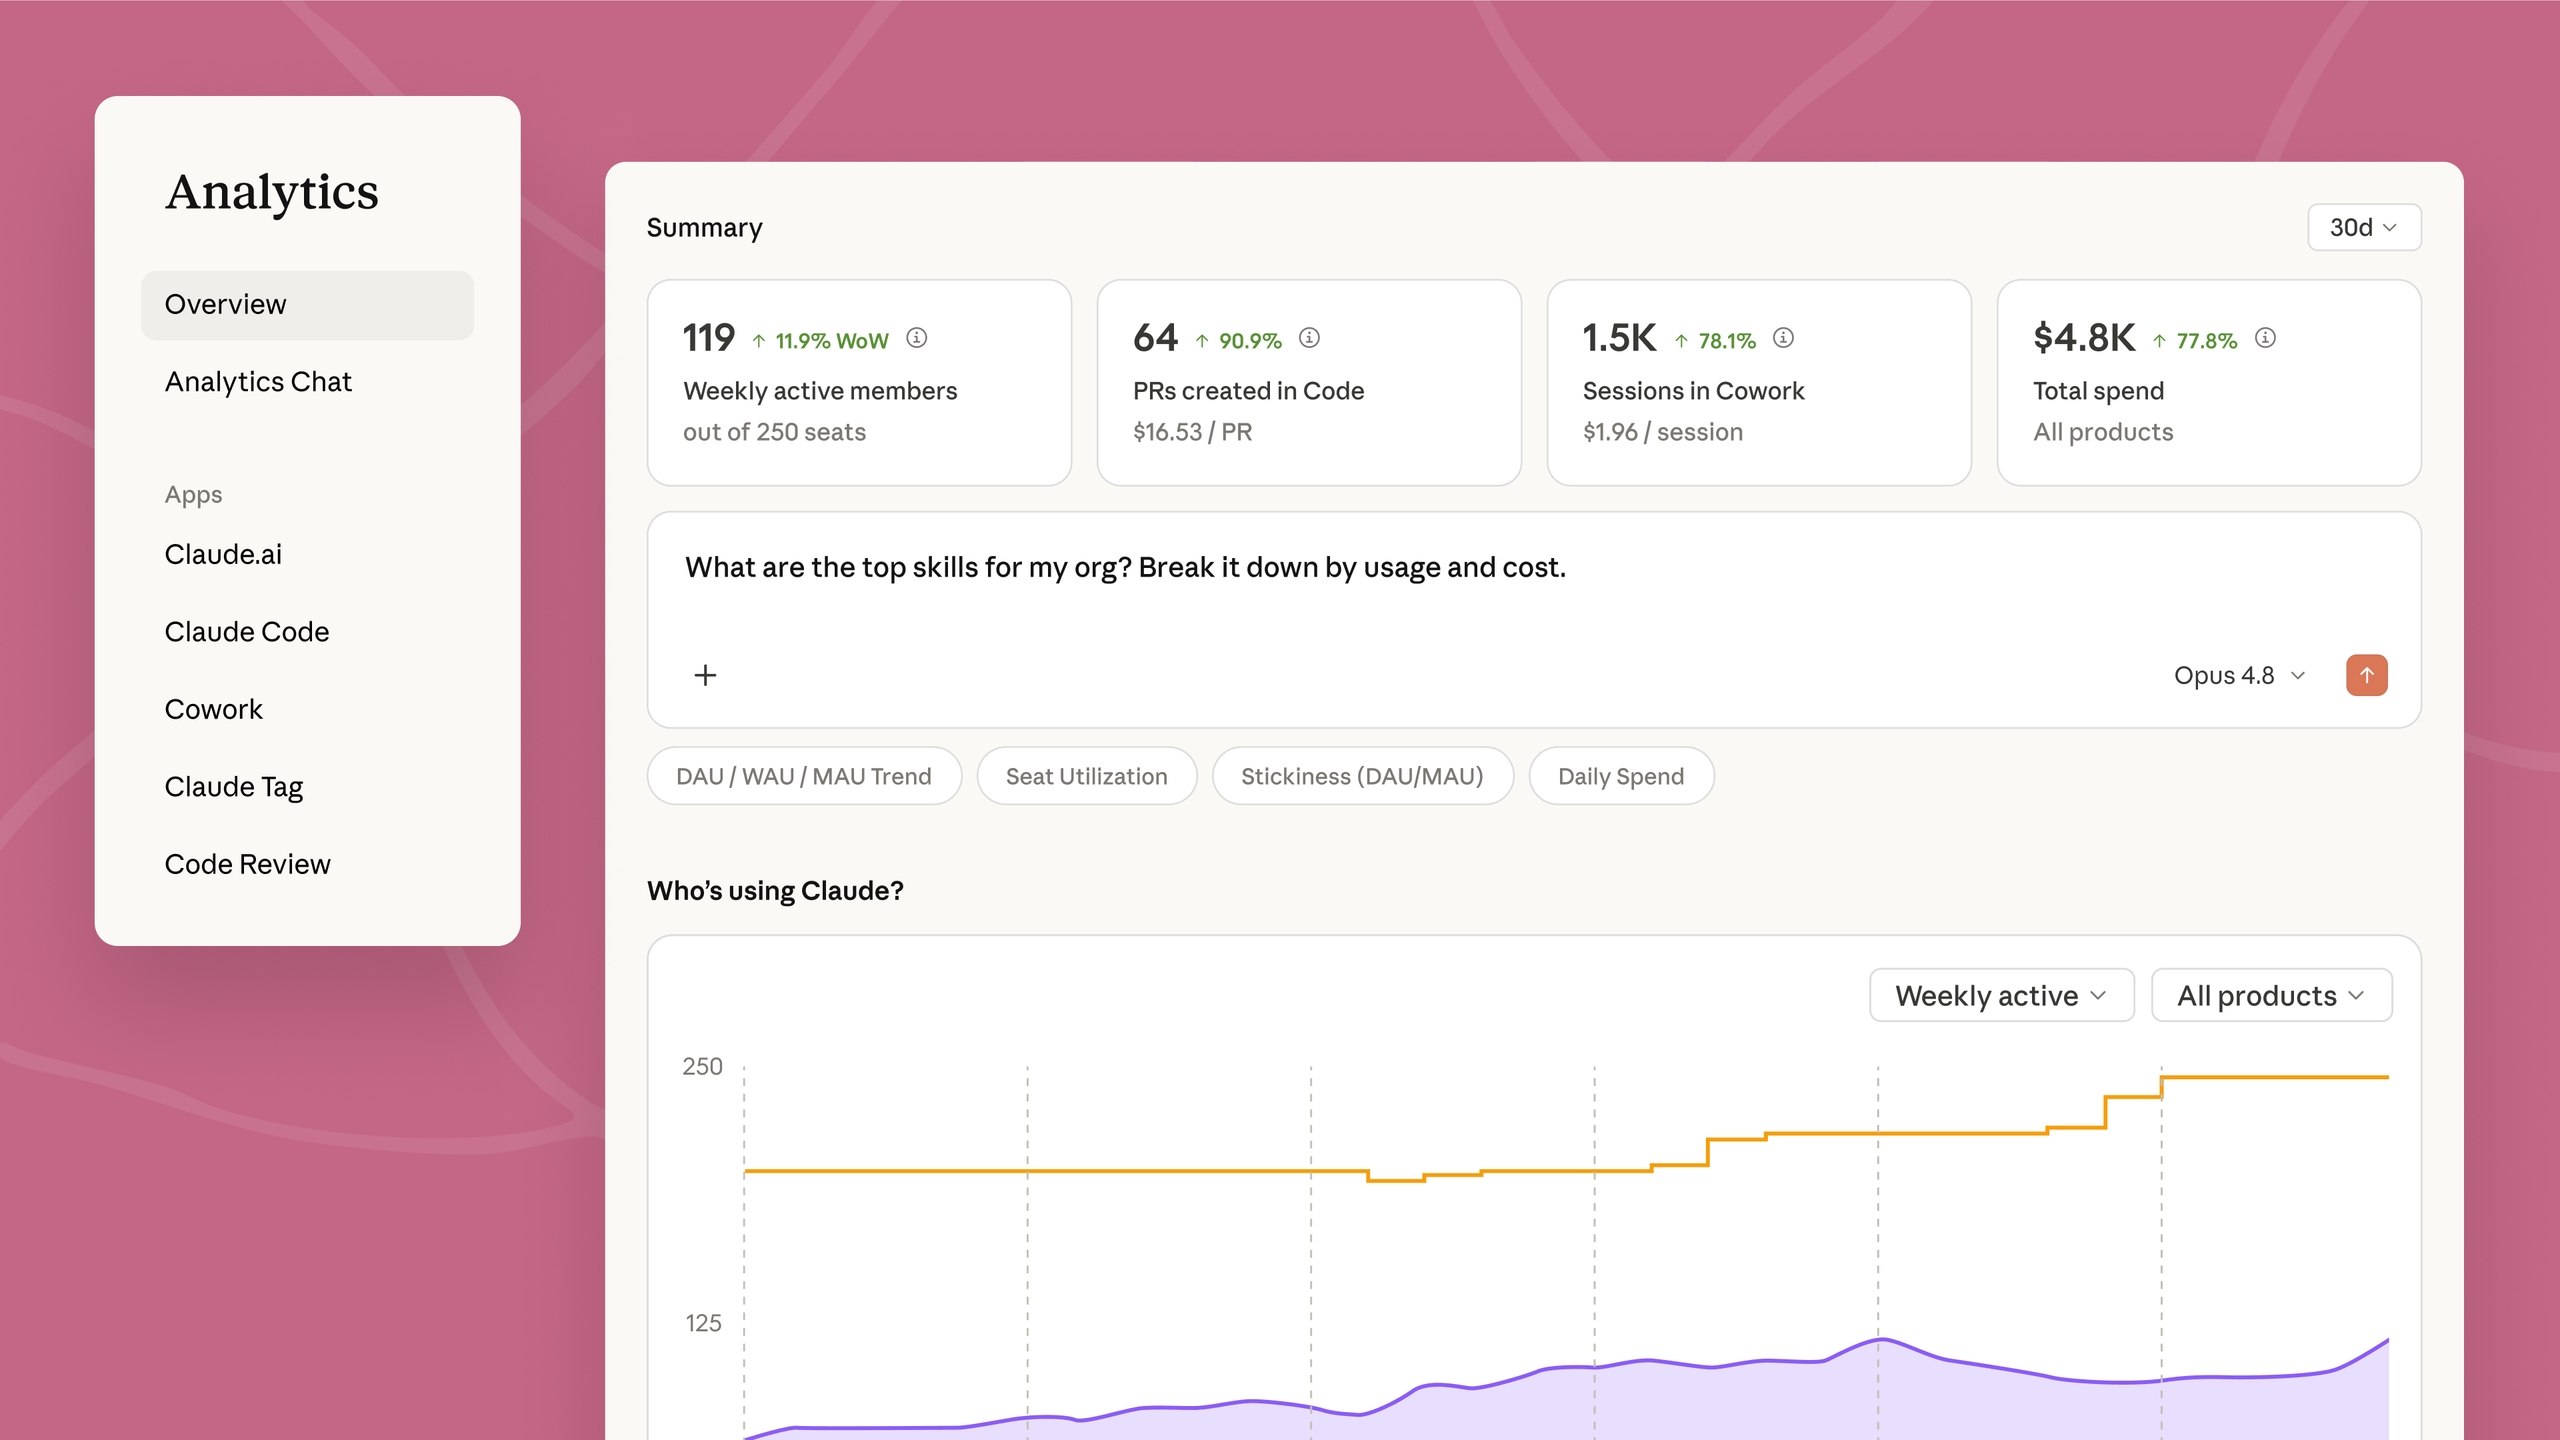
Claude Enterprise теперь считает стоимость Claude Code на коммит и оценивает годовую отдачу, а все формулы расчёта открыты и настраиваются вручную. Аналитика доступна через API с выгрузкой в Datadog и CloudZero, плюс оповещения о расходах при 75% и 90% лимита.
Читайте также
- Anthropic представила модели Claude Fable 5 и Mythos 5
- Haiku 5.5 печатает быстро, но молчит 415 секунд
- Sonnet 5.5 сэкономил CodeRabbit вдвое больше обещанного
- Sonnet 5.5 выдал 410 млн токенов ради третьего места
- Sonnet 5.5 обогнал Opus 5.5 в Terminal-Bench 4.0
- Ответ Opus 5.5 стоил в 3,4 раза больше, чем у GPT-6 Sol
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.