
Ответ Opus 5.5 стоил в 3,4 раза больше, чем у GPT-6 Sol
Claude Opus 5.5 и GPT-6 Sol вышли в один день, 22 сентября, и решили без единой ошибки все 49 задач одного детерминированного набора. Но в пересчёте на верный ответ Opus 5.5 оказался в 3,4 раза дороже. Anthropic при этом обещает, что на типичной нагрузке новая модель обходится на 40% дешевле Opus 5.
Обе цифры сходятся в разборе Aipricing. Его авторы предлагают сравнивать стоимость принятой задачи, а цену токена считать только отправной точкой. Их собственный прогон подтверждает оценку Anthropic относительно Opus 5, но и показывает, что дорогой прайс Opus 5.5 против Sol на коротких задачах не окупился.
Прайс-лист, о котором спорить не приходится
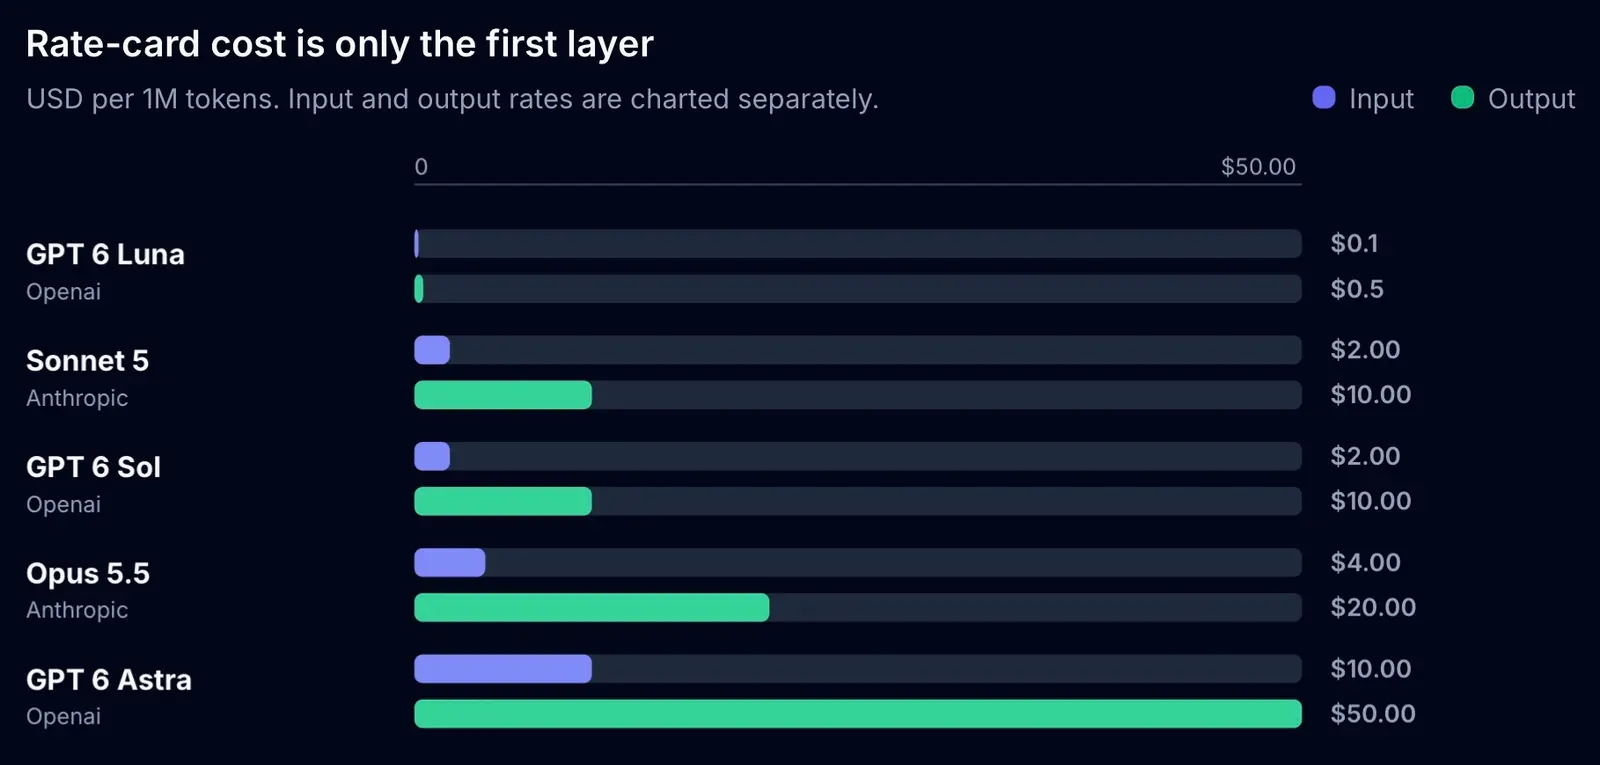
За миллион токенов в стандартном коротком контексте GPT-6 Sol берёт 2 доллара за вход, 0,20 за кешированный вход, 2,50 за запись в кеш и 10 за выход. У Claude Opus 5.5 вход стоит 4 доллара, чтение кеша 0,20, пятиминутная запись в кеш 5, выход 20. Часовая запись в кеш у Anthropic стоит отдельно, 8 долларов за миллион. При одинаковом объёме токенов Opus 5.5 вдвое дороже Sol на свежем входе, записи в кеш и выходе, а чтение кеша у обеих моделей стоит одинаково.
Есть и разница в устройстве тарифа. У Sol запрос длиннее 272 000 входных токенов идёт по повышенной ставке, а у Opus 5.5 одна стандартная ставка на весь контекст в 1 миллион токенов. Кроме того, DevX сообщает о быстром режиме Opus 5.5: 8 долларов за миллион входных и 40 за миллион выходных токенов, до 2,5 раза быстрее.
Предшественник стоил больше. У Opus 5, вышедшего в июле, было 5 долларов за вход, 25 за выход и 0,50 за чтение кеша. Отсюда объявленные Anthropic 20% снижения на входе и выходе и 60% на чтении кеша. Именно из чтения кеша, по словам компании, складывается большая часть счёта за агентную работу и код.
Что заявляет Anthropic
В анонсе Anthropic называет Opus 5.5 первой моделью семейства Claude 5.5. Компания говорит, что на большинстве задач модель держит уровень Claude Fable 5.1, а обслуживать её дешевле, чем Opus 5, и цены это отражают. При настройках по умолчанию на типичной нагрузке Opus 5.5 обходится на 40% дешевле Opus 5: к снижению ставок добавляется меньший расход токенов на задачу. Выход модель генерирует более чем на 30% быстрее предшественника, независимых замеров этой цифры нет.
«По умолчанию» здесь означает конкретную настройку. Согласно документации, адаптивное мышление у Opus 5.5 включено всегда и не отключается, глубину рассуждений задаёт параметр effort, а его значение по умолчанию medium.
Бенчмарки Anthropic публикует в собственной таблице. На Terminal-Bench 4.0 Opus 5.5 набирает 66,4% против 37,3% у GPT-6 Sol и 52,3% у Opus 5. На FrontierCode 54,4% против 47,5% у Sol и 48,0% у Opus 5. На CursorBench 57,8% против 41,7% у Sol и 46,6% у Opus 5. DevX отмечает, что независимого аудита у этих результатов нет. Авторы Aipricing добавляют, что настройки effort в таблице различаются от результата к результату, а свою обвязку и допущения по стоимости каждый вендор выбирает сам. Поэтому эти цифры годятся для шорт-листа, но нейтрального сравнения моделей не заменяют.
То же касается заявления, что Opus 5.5 с effort по умолчанию обходит GPT-6 Astra примерно за пятую часть стоимости. Оно относится к выбранным сравнениям на FrontierCode и GDPval и не означает, что любой запрос к Opus на 80% дешевле Astra. По ставкам разница меньше: стандартные цены входа и выхода у Opus 5.5 на 60% ниже, чем у Astra в коротком контексте. Всё, что сверх этого, должно набираться за счёт меньшего числа токенов, вызовов, повторов или сбоев.
Что показал прогон Aipricing
Набор из 49 коротких задач с машинной проверкой обе модели прошли полностью и без ошибок. Весь прогон стоил 0,05422 доллара на Opus 5.5 и 0,015922 доллара на Sol, что даёт те самые 3,4 раза на верный ответ. Opus израсходовал 5330 токенов промпта и 1645 токенов ответа, Sol 3426 и 907.
Opus 5.5 потратил больше токенов, чем Sol, и на входе, и на выходе: примерно в полтора раза больше промпта и почти вдвое больше ответа. Ставки вдвое выше умножились на больший объём. Авторы делают вывод только для своего случая: на таких задачах Opus не отыграл премию за счёт эффективности. Аппетит модели виден и на большем масштабе: в режиме максимальных усилий Opus 5.5 в сентябре выдал на индексе Artificial Analysis 260 миллионов токенов при медиане 92 миллиона.
Против Opus 5 картина другая. На том же наборе Opus 5 решил 48 задач из 49 за 0,09366 доллара. В пересчёте на верный ответ Opus 5.5 дешевле на 43%, и это близко к 40%, которые обещает Anthropic. На кодинг масштаба репозитория авторы этот результат не распространяют. Ранние тестировщики приводят свои цифры: по данным DevX, компания Rogo получила качество уровня Opus 5 при стоимости токенов на 60% ниже.
Почему счёт может перевернуться
Счёт агента не сводится к одному промпту, умноженному на ставку. Aipricing предлагает считать так: токены модели, плюс запись в кеш, плюс оплата инструментов, повторы, проваленные прогоны и время ревьюера. Если Sol на задачу нужно десять вызовов, а Opus пять, двукратная разница в цене может исчезнуть. Если вызовов поровну, преимущество обычно остаётся за Sol. А если дешёвый прогон выдаёт патч, который валит тесты или требует ручной правки инженером, экономия на токенах может уже ничего не значить.
На лишние циклы влияет и миграция. Opus 5.5 всегда работает с адаптивным мышлением и отклоняет запросы, которые пытаются его отключить. Принудительный выбор инструмента (forced tool choice) не поддерживается. Блоки мышления привязаны к модели и диалогу. Одну старую версию инструмента computer use API Anthropic и Google Cloud отклоняют. Текст о ходе работы между вызовами инструментов теперь тоже попадает в блоки мышления. Обвязка, которая обрабатывает это неправильно, будет повторять запросы, терять состояние рассуждений, молчать о прогрессе или проваливать раунды с инструментами, и каждая лишняя итерация увеличивает реальную стоимость задачи.
Подписка через OpenClaw и Hermes
В сборке OpenClaw, которую авторы проверили в день релиза, Opus 5.5 ещё не было в каталоге моделей Anthropic. OpenClaw умеет запускать Claude через официальный CLI командой claude -p, и по документации такой путь расходует лимиты Agent SDK подписки, под которой выполнен вход. Но раз модели нет в каталоге, а формат запросов изменился несовместимо, авторы советуют дождаться проверенного пути совместимости или осознанно проверить ручное переопределение.
У Hermes есть отдельный экспериментальный плагин Claude Subscription DirectSDK. В его каталоге от 22 сентября значится claude-opus-5-5[1m], нужны Hermes 0.21.4 или новее и Claude Code CLI с выполненным входом, а ходы Hermes идут через подписку. Собственный тест плагина показал тот же учёт, что у claude -p: примерно в 1,7 раза больше, чем в интерактивном TUI Claude Code. Зато Hermes на одинаковых задачах по коду отправлял примерно 0,6 от объёма токенов нативного Claude Code. Эти эффекты могут друг друга компенсировать, и итог покажет только парный тест на одной нагрузке.
Плагин легко спутать с прямым OAuth-подключением Hermes к Anthropic, но для того пути Hermes документирует другое поведение планов и дополнительного расхода. Прежде чем считать использование включённым в подписку, проверьте, какой провайдер выбран.
Как сравнивать на своих задачах
Авторы разбора делят выбор так. Sol подходит, когда важнее всего цена при равном объёме, предсказуемая экономика API и большой ежедневный поток. Opus 5.5 подходит там, где сложная разработка или аналитика дорожает в основном потому, что слабые прогоны блуждают, повторяются или требуют серьёзного ревью, и только если ваши собственные трассы показывают более высокую долю завершённых задач или меньше шагов. GPT-6 Luna или Claude Sonnet 5 они предлагают держать как дешёвый контроль: премиальная модель должна обойти их по стоимости принятого результата.
Для пилота нужны одинаковые набор задач, коммит репозитория, список инструментов, права, состояние кеша, effort и правило остановки. Записывать стоит число успешных задач, весь вход, чтение и запись кеша, выход, вызовы инструментов, время выполнения, повторы, сбои и минуты, которые ушли на ревью.
Дальше
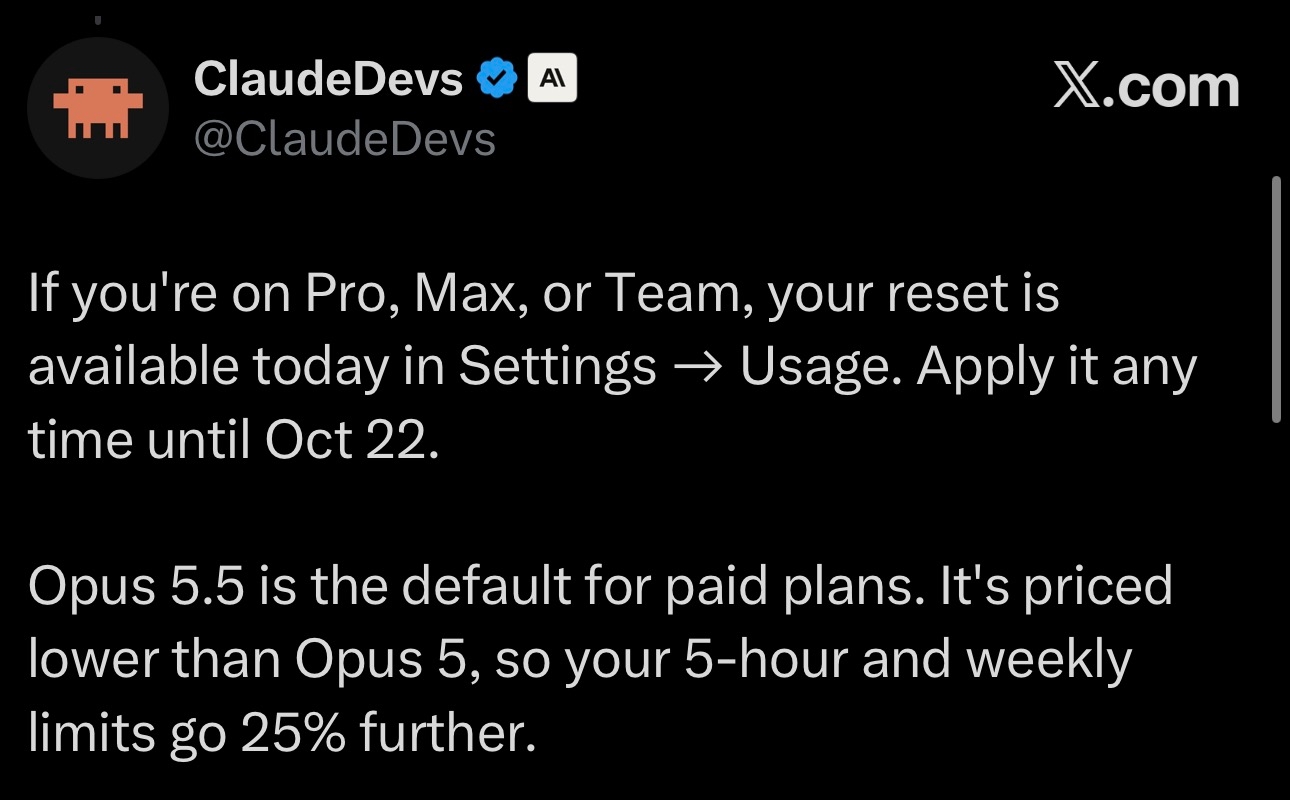
Сброс лимитов Claude можно придержать до 22 октября
Кто-то упёрся в лимит посреди сессии в Claude Code и идёт в Settings → Usage нажать Reset. Разовый сброс выдали Pro, Max и Team, и держать его в запасе можно до 22 октября.
Читайте также
- Opus 5.5 возглавил индекс, наговорив 260 млн токенов
- Fable 5.1 лидирует в индексе Artificial Analysis, но дороже
- Claude Sonnet 5: рост качества при более высокой цене за задачу
- Новые модели Claude тратят больше токенов, но дешевле за решённую задачу
- Кредиты Claude, купленные с 7 декабря, сгорят через год
- Модели Anthropic растут вдвое быстрее, по оценке METR
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.