
Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
Kimi 23 октября открыла доступ к K3.1 Pro и ставит её в один ряд с Claude Opus 5.5 и GPT-6 Astra. В таблице самой Kimi на 47 бенчмарков оценки обеих моделей есть в 42 тестах: K3.1 Pro обходит Opus 5.5 в 21 из них и в 21 уступает. Входные токены в API при этом стоят 2 доллара за миллион, у Opus 5.5 - 4 доллара.
По анонсу Kimi, K3.1 Pro открывает серию K3.1. Это дообученная Kimi K3: на пост-обучение потратили заметно больше вычислений, а контекст остался в 1 миллион токенов. Модель класса 3T с открытыми весами уже доступна в Kimi.ai, Kimi Work, Kimi Code и через Kimi API. Там же работает вариант Highspeed, который, по словам Kimi, в 2-3 раза быстрее основного. Полные веса компания обещает выложить до 4 ноября.
Архитектура у K3.1 Pro та же, что у K3. В карточке K3 указано 2,8 триллиона параметров, из которых на каждый токен работают 104 миллиарда: из 896 маршрутизируемых экспертов выбираются 16, плюс два общих. С прошлой моделью Kimi уже обещала веса после запуска в API: K3 появилась в API 16 июля, а веса на Hugging Face вышли 27 июля.
Прирост Kimi объясняет обучением с подкреплением, которое запускали совместно на сотнях прикладных доменов. Для этого переделали весь стек: RL-фреймворк, инференс на длинном контексте, песочницы, расписание прогонов и общую платформу для проверки качества сред. По словам компании, теперь каждая добавка вычислений на RL даёт стабильный и предсказуемый прирост.
Сорок семь строк
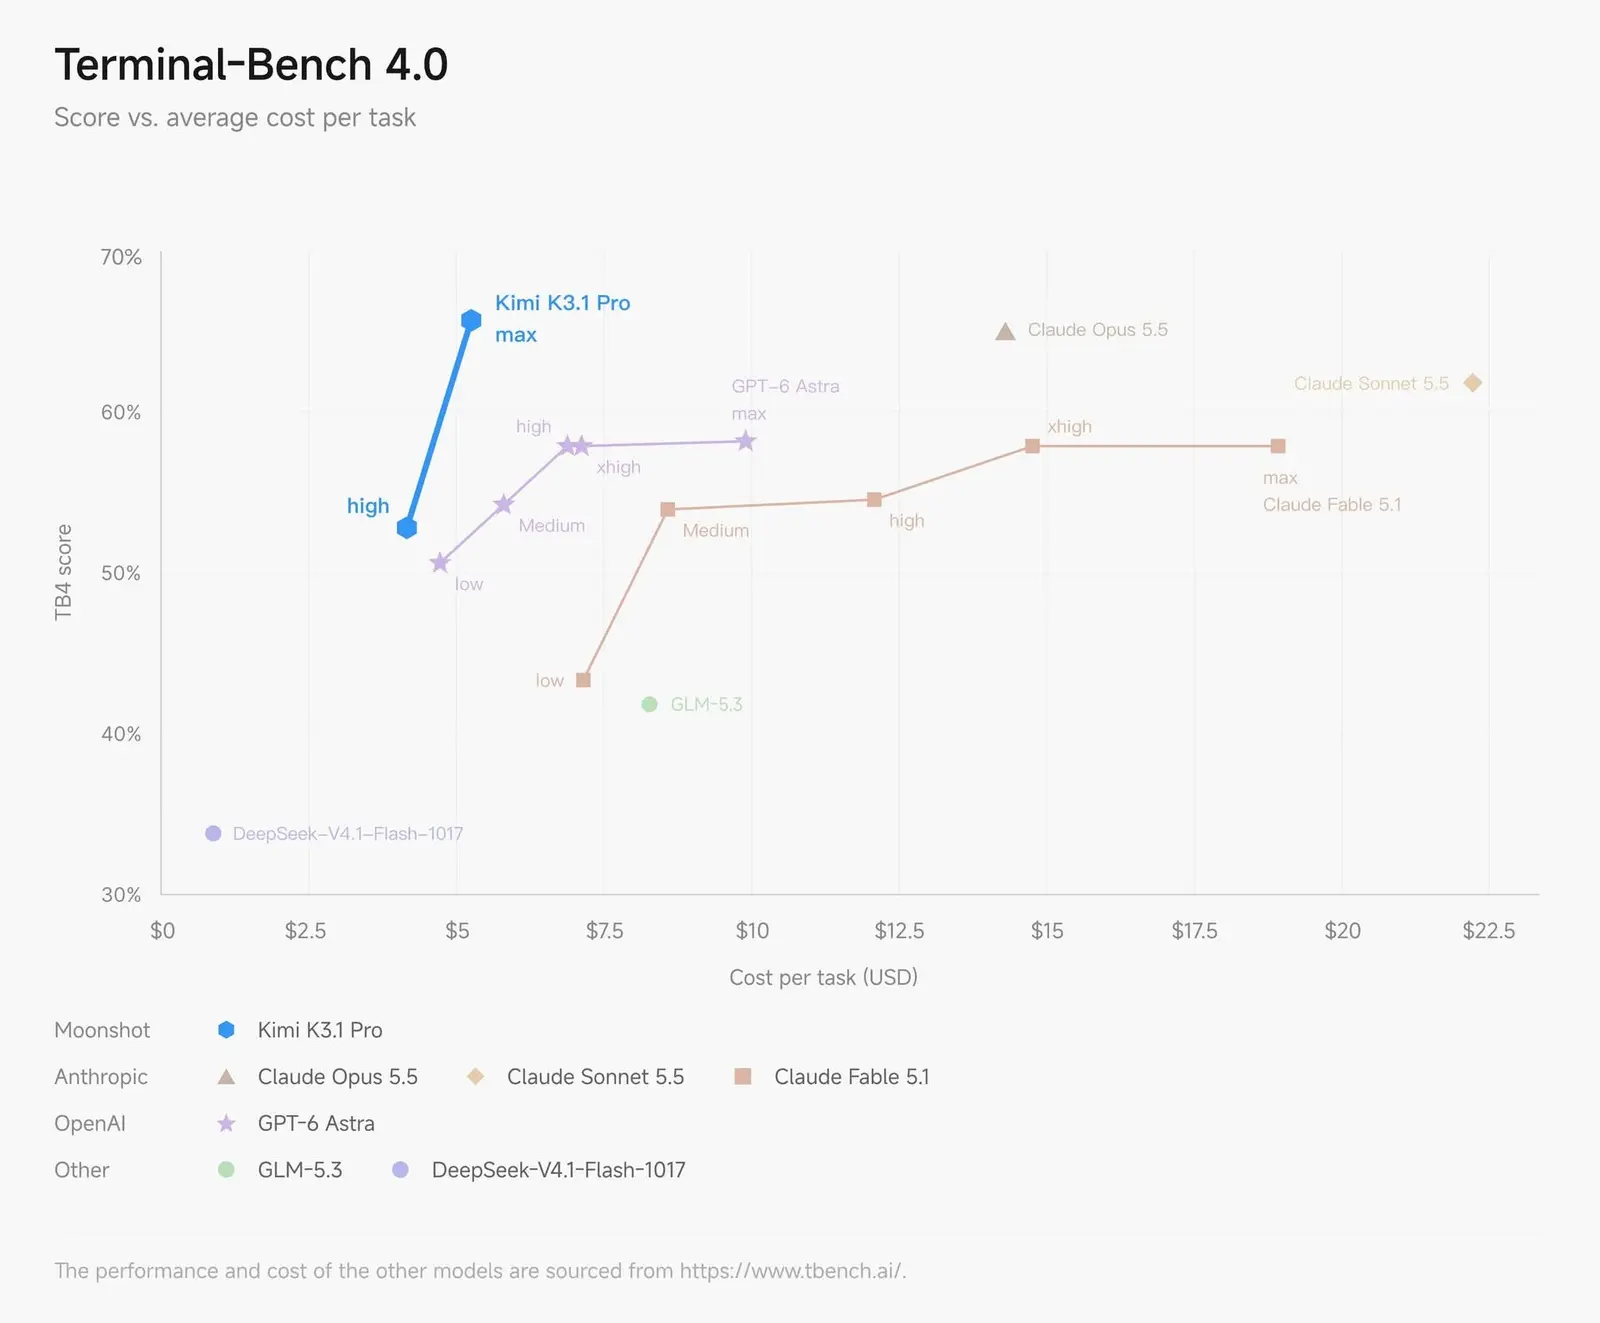
Главная цифра анонса - Terminal-Bench 4.0, где агенты решают задачи в терминале при ограниченных ресурсах. K3.1 Pro набрала там 65,7%, Claude Opus 5.5 - 66,4%, GPT-6 Astra - 58,2%. K3.1 Pro прогоняли в обвязке Claude Code, с максимальным уровнем рассуждений, temperature 1,0 и top-p 0,95. У конкурентов в таблице Kimi стоит пометка «(max, with fallback)».
Первое место или ничью среди шести моделей таблицы K3.1 Pro делит в 16 бенчмарках из 47. Почти все они агентные: 13 из 25 в этой группе. В программировании таких тестов 2 из 10, в рассуждениях и мультимодальных задачах 1 из 9, в кибербезопасности 0 из 3. Если сравнивать попарно, то против GPT-6 Astra счёт 23 на 19 в пользу K3.1 Pro, против Claude Fable 5.1 - 27 на 13.
Где K3.1 Pro близка к лидерам, это видно и по анонсу. В BenchCAD, где 3D-объект восстанавливают по нескольким рендерам через генерацию CAD-кода, у неё 92,7% с инструментами, у Opus 5.5 - 96,2%, у Astra - 95,9%. В OfficeQA Pro v2, где нужно анализировать реальные финансовые документы, Kimi заявляет лучший результат: 64,4. Во Frontier Finance у K3.1 Pro 58,6. Выше только Fable 5.1 с 60,8, у Opus 5.5 там 56,7, у Astra 45,0.
Где отрыв большой?
В программировании и рассуждениях разрыв заметнее. В ProgramBench у K3.1 Pro 31,5, у Opus 5.5 65,0, у Fable 5.1 53,5, у Astra 50,0. В HLE-Diamond 39,4 против 65,8 у Astra и 60,9 у Opus. В Terminal-Bench Science 0.1 38,1 против 68,1 у Astra и 63,3 у Opus.
Даже на собственном внутреннем Kimi Code Bench 3.0 Long-horizon, где проверяют многошаговую работу агента с инструментами, K3.1 Pro обходит предшественницу (61,2 против 55,95 у K3), но уступает GPT-6 Astra с её 66,5.
Длинные задачи Kimi показывает на примере. На открытой анатомической модели human-atlas (296 скелетных компонентов и 402 мышечных) K3.1 Pro собрала симулятор ходьбы человека с конвейером обучения и оценки. За 167 задач и 420 независимых проверок виртуальный человек научился шагать без остановки 11,2 секунды, а вначале падал за секунды. Когда подбор награды не исправил движения рук, модель прогнала пробные запуски динамики без обратной связи и нашла 36 ошибок в расчёте плеч моментов мышц плеча.
В финансах прирост к K3 считается по внутренним тестам Kimi. В финансовом моделировании это 7,2 пункта, в исследованиях с требованием проверяемых источников 11,6. В симуляции управления бизнесом результат примерно в 4,2 раза выше, чем у K3, но в абсолютных цифрах это 37,8. На стресс-тесте Kimi Hallu Bench Hard доля ложных утверждений упала с 23,4% у K3 до 8,3%. Доля ответов хотя бы с одной фактической ошибкой составила 42,4% от уровня предшественницы. Kimi оговаривает, что примеры в этом тесте специально подобраны под ошибки и о частоте ошибок в обычной работе ничего не говорят.
Взлом вычистили из данных
По мере пост-обучения навыки поиска уязвимостей у K3.1 Pro стабильно росли. В Kimi нашли источник: тексты по кибербезопасности были в общем корпусе промежуточного обучения, а соответствующие задачи - среди RL-сред. Для открытого релиза эти данные убрали на обоих этапах, а обычные задачи по коду оставили.
Эффект проверяли на внутреннем xdev-bench-hard. Это задачи по реальным недавно раскрытым уязвимостям в ядре Linux, Node.js, JavaScriptCore, Exim и VirGL: нужно написать эксплойт, добиться выполнения кода в песочнице и достать секретную строку. Чекпоинт без чистки решает 90,5% задач при pass@3, итоговая K3.1 Pro - 81,0%. Предшественницу она всё равно обходит. В открытых бенчмарках она уступает закрытым моделям: в ExploitBench у K3.1 Pro 74,7 против 100 у Astra, 91,0 у Opus 5.5 и 83,0 у Fable 5.1, в ExploitGym 20,7 против 42,4 у Astra и 34,5 у Opus.
Своё правило Kimi формулирует так: компания стремится «не выпускать открытые веса, которые сдвинули бы абсолютную границу кибервозможностей», а уровень этих навыков в открытых релизах собирается повышать постепенно.
Авторский разбор
Что мы проверили
24 октября мы сверили прайсы Kimi, Anthropic и OpenAI и разобрали таблицу бенчмарков из разметки блога Kimi. Ещё мы открыли официальный лидерборд Terminal-Bench 4.0 и репозиторий весов K3 на Hugging Face.
Вдвое дешевле Opus 5.5 обходится только базовая K3.1 Pro. Highspeed стоит столько же, сколько Opus 5.5. Отставание от Opus в Terminal-Bench 4.0 держится на цифре, которую Kimi взяла из блога Anthropic. По лидерборду K3.1 Pro чуть выше Opus, в пределах погрешности. Открытые веса потребуют как минимум узла на B300 или двух узлов Hopper/B200.
| Модель | Вход, долл./1 млн | Выход, долл./1 млн | Кэш, долл./1 млн | Смесь 3:1, долл./1 млн |
|---|---|---|---|---|
| kimi-k3.1-pro | 2,00 | 10,00 | 0,20 | 4,00 |
| kimi-k3.1-pro-highspeed | 4,00 | 20,00 | 0,20 | 8,00 |
| Claude Opus 5.5 | 4,00 | 20,00 | 0,20 | 8,00 |
| GPT-6 Astra (Standard) | 10,00 | 50,00 | 1,00 | 20,00 |
- Сравниваем только прайсы. Сколько токенов уходит на задачу, мы не замеряли.
- На лидерборде Terminal-Bench 4.0 у Opus 5.5 (max, Claude Code) 64,8% ± 3,1%, у Sonnet 5.5 (max) 61,8% ± 2,9%, у GPT-6 Astra (max, Codex) 58,2% ± 2,8%. K3.1 Pro там нет. 66,4 для Opus Kimi взяла по своему правилу: максимум из блога вендора и лидерборда. По нашим прошлым записям, у Anthropic это результат на уровне xhigh, а в таблице Kimi он подписан «max». Это наш вывод из двух документов, со страницей Anthropic мы его не сверяли. Заявленные 65,7 у K3.1 Pro (интервал Kimi не приводит) на 0,9 пункта выше строки Opus на лидерборде, это меньше её погрешности.
- Веса K3 занимают 1,56 ТБ в 96 файлах safetensors. Формат MXFP4 с группой 32, а внимание, общие эксперты, плотный MLP, lm_head и визуальная часть хранятся в bf16. В среднем выходит 4,46 бита на параметр. В один узел 8×H200 (1,13 ТБ) это не помещается, в 8×B200 по 180 ГБ (1,44 ТБ) тоже, в 8×B300 (2,30 ТБ) помещается. Рецепт SGLang: B300 1×8, B200 и H200 2×8, H100 4×8. vLLM требует «не меньше 8x GB300». Для K3.1 Pro это пока по документации K3, до 4 ноября проверить нельзя.
Где включить
В Kimi Code модель выбирается командой /model. В API это kimi-k3.1-pro и kimi-k3.1-pro-highspeed, клиентам API доступен режим Zero Data Retention. Для Kimi Work нужна версия 3.1.0 или новее под Windows или Mac на Apple silicon. Мобильные приложения Kimi вышли для iOS, Android и HarmonyOS. В Kimi Enterprise на старте модель выключена по умолчанию, её включает администратор организации.
Дальше
Claude Codeразбор
Claude Code поддержал MCP Tasks и Elicitations, Видео
«Подтвердить возврат денег» или дописать недостающую деталь: с Elicitations плагин MCP спрашивает пользователя прямо посреди задачи. В Claude Code CLI это работает уже сегодня, а другие продукты Claude получат поддержку позже. Сколько MCP-серверов у вас сейчас подключено к Claude Code?
Читайте также
- Haiku 5.5 печатает быстро, но молчит 415 секунд
- Sonnet 5.5 выдал 410 млн токенов ради третьего места
- Sonnet 5.5 обогнал Opus 5.5 в Terminal-Bench 4.0
- Opus 5.5 возглавил индекс, наговорив 260 млн токенов
- Два верхних режима Claude Fable 5.1 дают 90% на ARC-AGI-2
- Пятичасовой таймаут объяснил разрыв в оценках Qwen 3.8-Max
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.