
Opus 5.5 возглавил индекс, наговорив 260 млн токенов
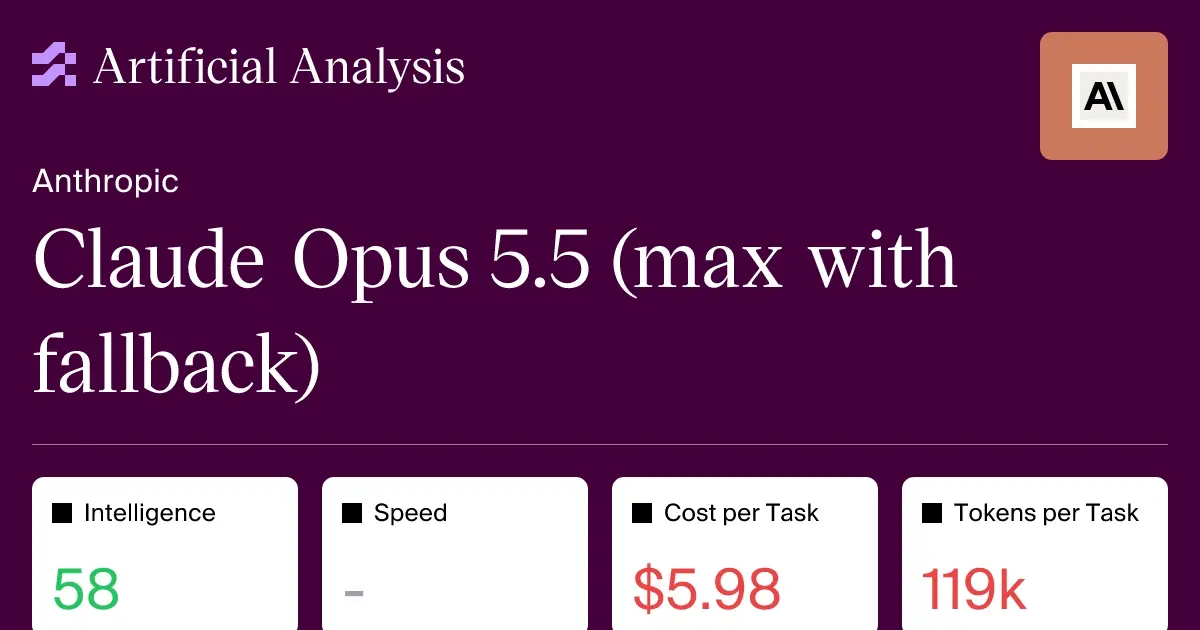
По замерам Artificial Analysis, Claude Opus 5.5 с максимальным уровнем рассуждений (max effort) набирает 58 баллов в Intelligence Index и стоит первым среди 206 моделей своего класса. Режим high отстаёт на четыре балла, а прогон всего индекса на нём обошёлся в 2 172,43 доллара против 8 708,20 доллара у max, то есть вчетверо дешевле.
Anthropic выпустила Opus 5.5 22 сентября. Artificial Analysis выложила обе конфигурации отдельными страницами, и полные названия у них длинные: «Adaptive Reasoning, Max Effort, Default Fallback» и «Adaptive Reasoning, High Effort, Default Fallback». Индекс версии 4.3.2 собирает 10 тестов: AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience и AA-LCR. Большая часть набора проверяет агентную работу: офисные задачи с документами, SaaS-процессы, работу в терминале.
Max против high
Класс у Artificial Analysis считается по цене. Проприетарные модели сравниваются с моделями того же ценового диапазона при смешанной цене 3:1 между входом и выходом, и Opus 5.5 попадает в верхнюю корзину, дороже 1 доллара за миллион токенов. Медиана индекса в этой корзине 25 баллов, так что обе конфигурации в лидерах: max на первом месте из 206, high на третьем из 212. Число моделей в классе на двух страницах разное.
Главная разница между режимами в объёме вывода. Чтобы пройти индекс, max выдал 260 миллионов токенов, high всего 53 миллиона. Медиана класса на этих страницах указана как 92 и 88 миллионов соответственно, и Artificial Analysis называет max очень многословным, а high довольно лаконичным. Получается, верхний режим тратит почти впятеро больше токенов ради четырёх баллов, и в счёте это видно сразу.
Средняя стоимость одной задачи индекса, взвешенная по весам тестов, у max составляет 5,98 доллара, у high 1,82 доллара. По этой метрике max стоит на 87-м месте из 206, high на 65-м из 212. Скорость вывода измерили только для high: 90,7 токена в секунду, 59-е место из 212 при средней по классу 71. Для max на странице стоит N/A.
Для тех, кто запускает агентов через API, разница переводится просто. Max оправдан там, где четыре балла индекса стоят втрое большей цены за задачу и ощутимо более длинных ответов. Для остального high даёт почти тот же уровень, и Artificial Analysis отмечает, что он ещё и быстрее среднего.
Цена и обещание Anthropic
Тарифы у обеих конфигураций одинаковые: 4 доллара за миллион входных токенов и 20 за миллион выходных. Artificial Analysis относит их к «несколько дорогим» для своего класса, где медиана 2 и 10 долларов. Скидка на попадание в кэш указана в 95%, а при смеси 7:2:1 (кэш, свежий вход, выход) миллион токенов обходится в 2,94 доллара.
У самой Anthropic цифры подаются относительно предшественника. Токены Opus 5.5 на 20% дешевле, чем у Opus 5, а чтение из кэша подешевело на 60%, до 0,20 доллара за миллион. Компания утверждает, что на типичных нагрузках модель обходится примерно на 40% дешевле Opus 5: токены дешевле, и на задачу их уходит меньше. Сама Anthropic называет 40% оценкой для типичных нагрузок. Замеры Artificial Analysis сходятся с этим тезисом только наполовину: по токенам режим high лаконичнее медианы, а max, наоборот, выдаёт почти втрое больше неё.
Fast mode, который Anthropic обещает до 2,5 раза быстрее, стоит 8 долларов за миллион входных и 40 за миллион выходных токенов. Инференс только на серверах в США стоит в 1,1 раза дороже базовой цены. В API модель называется claude-opus-5-5 и доступна на Claude Platform, в Amazon Web Services, Google Cloud и Microsoft Foundry. Artificial Analysis учитывает одного провайдера, цены взяты из API Anthropic. Из подписок модель открыта на Pro, Max, Team и Enterprise.
Контекстное окно у Opus 5.5 вмещает 1 миллион токенов. На вход модель принимает текст и картинки, отвечает текстом. Размер модели и число параметров Anthropic не раскрывает.
Где Fable 5.1
По словам Anthropic, в большинстве задач Opus 5.5 работает на уровне Claude Fable 5.1. Сопоставлять это с индексом нужно осторожно: состав индекса меняется, и в версии 4.3.2 тесты Terminal-Bench 4.0 и GDP.pdf отмечены как новые, поэтому сравнение со старыми замерами приблизительное. В начале сентября Fable 5.1 в режиме максимальных усилий набирал в индексе Artificial Analysis 66 баллов и стоял первым.
Дальше
Opus 5.5 у CodeRabbit поймал 11 новых багов, но упустил 9
11 багов, которые упустил боевой ревьюер CodeRabbit, нашёл Opus 5.5 в конфигурации Standard. Зато девять из тех, что ревьюер ловил, модель пропустила, и смена ревьюера меняет, какие ошибки проскакивают.
Читайте также
- Sonnet 5.5 выдал 410 млн токенов ради третьего места
- Ответ Opus 5.5 стоил в 3,4 раза больше, чем у GPT-6 Sol
- Opus 5.5 обошёл GPT-6 Astra в индексе v5: 58 против 57
- Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
- Партнёры Anthropic, по слухам, уже тестируют Fable 5.5
- Haiku 5.5 печатает быстро, но молчит 415 секунд
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.