
lcc сжимает сессии Claude Code, не пересказывая их
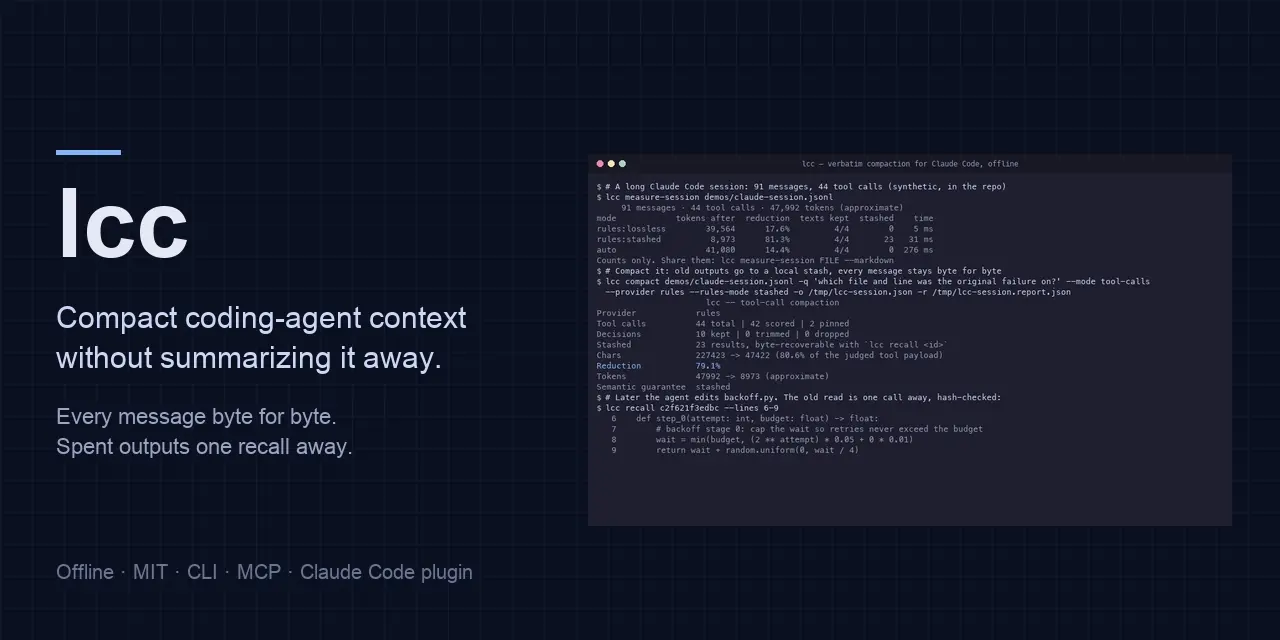
Автор открытой утилиты lcc (Local Context Compiler) 23 октября показал на Hacker News замену штатному /compact в Claude Code. Вместо резюме, которое пишет модель, lcc вырезает из сессии старые выводы инструментов, а всё остальное оставляет байт в байт. Главный довод автора - его собственный тест: резюме в стиле /compact сохранило 73% точных значений, полный контекст 98%.
Цифр в README проекта на GitHub заметно больше, чем обычно бывает у Show HN. Там есть лучший случай, медиана по всем длинным сессиям автора, предрегистрированный тест на реальных запросах и бенчмарк ранжировщика. И просьба прогнать тот же замер на своих сессиях.
Что уходит из контекста
Штатный /compact заменяет всю сессию одним резюме. Anthropic в курсе Claude Academy описывает сжатие так: оно пересказывает важные детали, выбрасывает ненужные результаты вызовов инструментов и при этом может потерять детали. Автор lcc формулирует ту же проблему конкретнее: резюме теряют точную ошибку, путь или строку, которые понадобятся агенту через два хода.
lcc поступает наоборот. Сообщения пользователя и ассистента остаются как были, а старые выводы инструментов уходят из контекста в локальное хранилище ~/.cache/lcc/stash. Файлы там адресуются по содержимому, поэтому при чтении через recall хеш пересчитывается и подмена или порча сразу видна. На месте вырезанного вывода агент видит заглушку такого вида: [removed: 120 lines, 4.3 KB · lcc recall <id>]. В ней строки и килобайты, а не токены, поэтому она одинакова на любой машине.
Каждый проход пишет JSON-отчёт, а команда lcc explain объясняет, почему тот или иной блок оставлен или выброшен. Судьи по умолчанию работают на CPU в обычном Python, без ключа API и без сети.
Место это популярное: catnap с той же площадки двигает момент сжатия, чтобы оно не срабатывало посреди задачи. lcc меняет само содержимое сжатия.
49,5% против 21,8%
Витринный пример - одна реальная сессия Claude Code на 193 сообщения и 75 вызовов инструментов. До сжатия в ней было 57 083 токена, после lcc в режиме rules/stashed осталось 28 807 (-49,5%). Все 43 сообщения пользователя и ассистента сохранились байт в байт, 33 вывода инструментов ушли в хранилище, и каждый можно вернуть одним вызовом recall. Для сравнения, /compact превращает те же 43 сообщения в одно резюме, а выводы инструментов пропадают совсем.
Замер сделан командой lcc measure-session из версии 1.2.0 на PyPI, офлайн, с точным подсчётом токенизатором o200k_base, и перезапущен 23 октября. Токенизатор этот из библиотеки tiktoken от OpenAI, так что в токенах Claude абсолютные числа могут отличаться. В ветке main заглушка теперь сообщает строки и размер, и та же сессия даёт 28 983 токена (-49,2%).
Сам автор называет эту сессию одним из лучших случаев. По всем 299 его длинным сессиям (от 100 сообщений каждая, 36,3 млн токенов в сумме) медианное сокращение составило 21,8%. Средняя половина сессий легла в коридор 15-31%, лучший результат 65%, потерянных сообщений ноль. Здесь важен порог из той же документации: если проход экономит меньше 25%, отчёт помечает его как не стоящий усилий, и плагин для Claude Code оставляет штатное резюме. Медиана в 21,8% лежит ниже этого порога, так что, если она посчитана в том же режиме, больше чем на половине сессий самого автора плагин, судя по всему, просто уступит место /compact.
Автор и не скрывает, что выигрыш зависит от того, сколько в контексте шума. И прямо оговаривает выборку: «Это все мои сессии: прогоните на своих и опубликуйте результат».
Резюме против recall
Самая интересная часть README - предрегистрированный тест на 172 реальных запросах. Агент отвечал либо по полному контексту, либо по сжатому lcc с возможностью вызывать recall. На вопросах, где нужно вспомнить содержимое файлов, разница составила +0,006 при 95-процентном доверительном интервале от -0,023 до +0,034, в пределах погрешности, при этом сжатому варианту понадобилось на 36,6% меньше токенов. На вопросы о вырезанном содержимом агент сам вызывал recall в 90% случаев.
Цифра про 73% относится к резюме в стиле /compact, а не к самому /compact. Это собственная реимплементация команды, которую написал Opus, на тех же сессиях. Она сохранила 73% точных значений, а полный дословный контекст 98%, разрыв в 25 пунктов.
Ограничения автор перечисляет сам. lcc не проверяет, что модель ответит правильно, и структурный PASS в отчёте не означает качества ответа. Правила защиты и ограниченное восстановление снижают риск потерять нужные данные, но не исключают его. RAG, эмбеддингов и векторного хранилища в утилите нет.
Кто решает, что выкинуть
За выбор отвечают «провайдеры». Для транскриптов по умолчанию работает specialist-v3, локальный ранжировщик на CPU; в отчёте он честно подписан как ранжирование без семантической гарантии. Есть три режима правил без модели: lossless убирает только доказуемые дубликаты, recoverable ещё и выводы, которые можно перечитать заново, а рекомендованный stashed убирает выводы с возможностью вернуть их байт в байт. Обычный текст под auto обрабатывает mechanical. Локальная модель laya объявлена устаревшей и запускается, только если назвать её явно.
Единственный сетевой путь, jev, отправляет цель и блоки контекста в TypeSafe API и включается только явным --provider jev с ключом TYPESAFE_API_KEY. Режим auto сам его не выбирает: «наличие ключа ещё не согласие отправлять контекст с машины», пишет автор. Чтобы auto ушёл в сеть, нужен отдельный LCC_AUTO_REMOTE=1, а LCC_DISABLE_NETWORK=1 отключает jev совсем.
Насколько хорошо ранжировщик угадывает нужное, автор мерил так: когда часть сессии приходится выбросить, как часто остаётся то, что агент реально использовал следующим шагом. Финальный одноразовый тест шёл на 193 примерах из 36 сессий, начатых после отсечки обучения, с бюджетом выброса от 0 до 60% токенов-кандидатов. Площадь под кривой (AUC, где 1,0 означает «всегда сохранил нужное») распределилась так:
- specialist-v3: 0,899
- mechanical: 0,829
- recency, свежие блоки в приоритете: 0,818
- bm25: 0,803
- случайный выбор: 0,689
Оговорка из README: метки взяты из сессий Claude Code одного мейнтейнера, и это подыгрывает цели, на которую обучали v3. Сами сессии закрыты, опубликованы только агрегаты.
На девяти синтетических случаях, написанных вручную (вытеснение старого факта, противоречие, смена конфигурации, промпт-инъекция в выводе инструмента, большой git diff, смесь португальского и английского и другие), картина обратная. Все обязательные блоки при срезе 30, 50 и 70% specialist-v3 сохранил в 8, 7 и 7 случаях из 9, mechanical во всех 9 на каждом срезе, bm25 в 9, 9 и 7. Автор объясняет это тем, что случаи лексически простые, а v3 промахивается на португальском. Полный проход режима rules lossless занял 2 мс на 302 блоках и 16 мс на 1 138 блоках при пике памяти 55 МБ, у specialist-v3 в режиме вызовов инструментов 181 мс и 3,4 с при 71 МБ; замеры сделаны на macOS arm64 под сильной нагрузкой.
specialist-v3 обучен на транскриптах Claude Code. Другие агенты и обычные документы для него вне распределения, поэтому обычный текст по умолчанию и уходит в mechanical.
Как попробовать
Пакет ставится как pip install "local-context-compiler[tiktoken]", а команда называется lcc. Пакет с именем lcc на PyPI к проекту отношения не имеет. Для точного счёта токенизатор нужно один раз закешировать самому, lcc ничего не скачивает; без этого отчёт помечает цифры как приблизительные и объясняет почему.
Замер последней сессии ничего не меняет и ничего не отправляет: lcc measure-session "$(ls -t ~/.claude/projects/*/*.jsonl | head -1)". Команда прогоняет все режимы и печатает только счётчики: сообщения, вызовы инструментов, токены до и после, сохранённые сообщения, время. Ни текста, ни путей, ни выводов инструментов в отчёте нет. Если передать каталог проекта, получите медиану и p90 сокращения по режимам, а логи Codex CLI распознаются автоматически. Флаг --input-map показывает, куда уходит оплачиваемый вход: чтения и записи кэша, доля результатов и входов инструментов, внедрённых инструкций, системного промпта и схем инструментов.
Плагин, который заменяет резюме /compact, требует Claude Code 2.1.274+ и флага CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1: функциональные хуки пока в раннем доступе. Установка идёт через claude plugin marketplace add lucasmartins-ai/lcc и claude plugin install lcc@lcc --config provider=rules --config rulesMode=stashed, после чего нужно разрешить инструмент mcp__plugin_lcc_lcc__recall, иначе агент не сможет вернуть вырезанное. Если проход падает или убирает слишком мало, плагин передаёт работу встроенному резюме и сообщает об этом всплывающим уведомлением.
Для Cursor, Claude Desktop и любого stdio-клиента есть MCP-сервер (lcc mcp) с инструментами compact, recall, explain и ещё четырьмя. Лицензия MIT.
Результаты автор просит выкладывать в раздел Discussions → Results. «Каждое число не от меня делает утверждения выше чуть менее моими и чуть более верными», - пишет он.
Дальше
Открытые моделиразбор
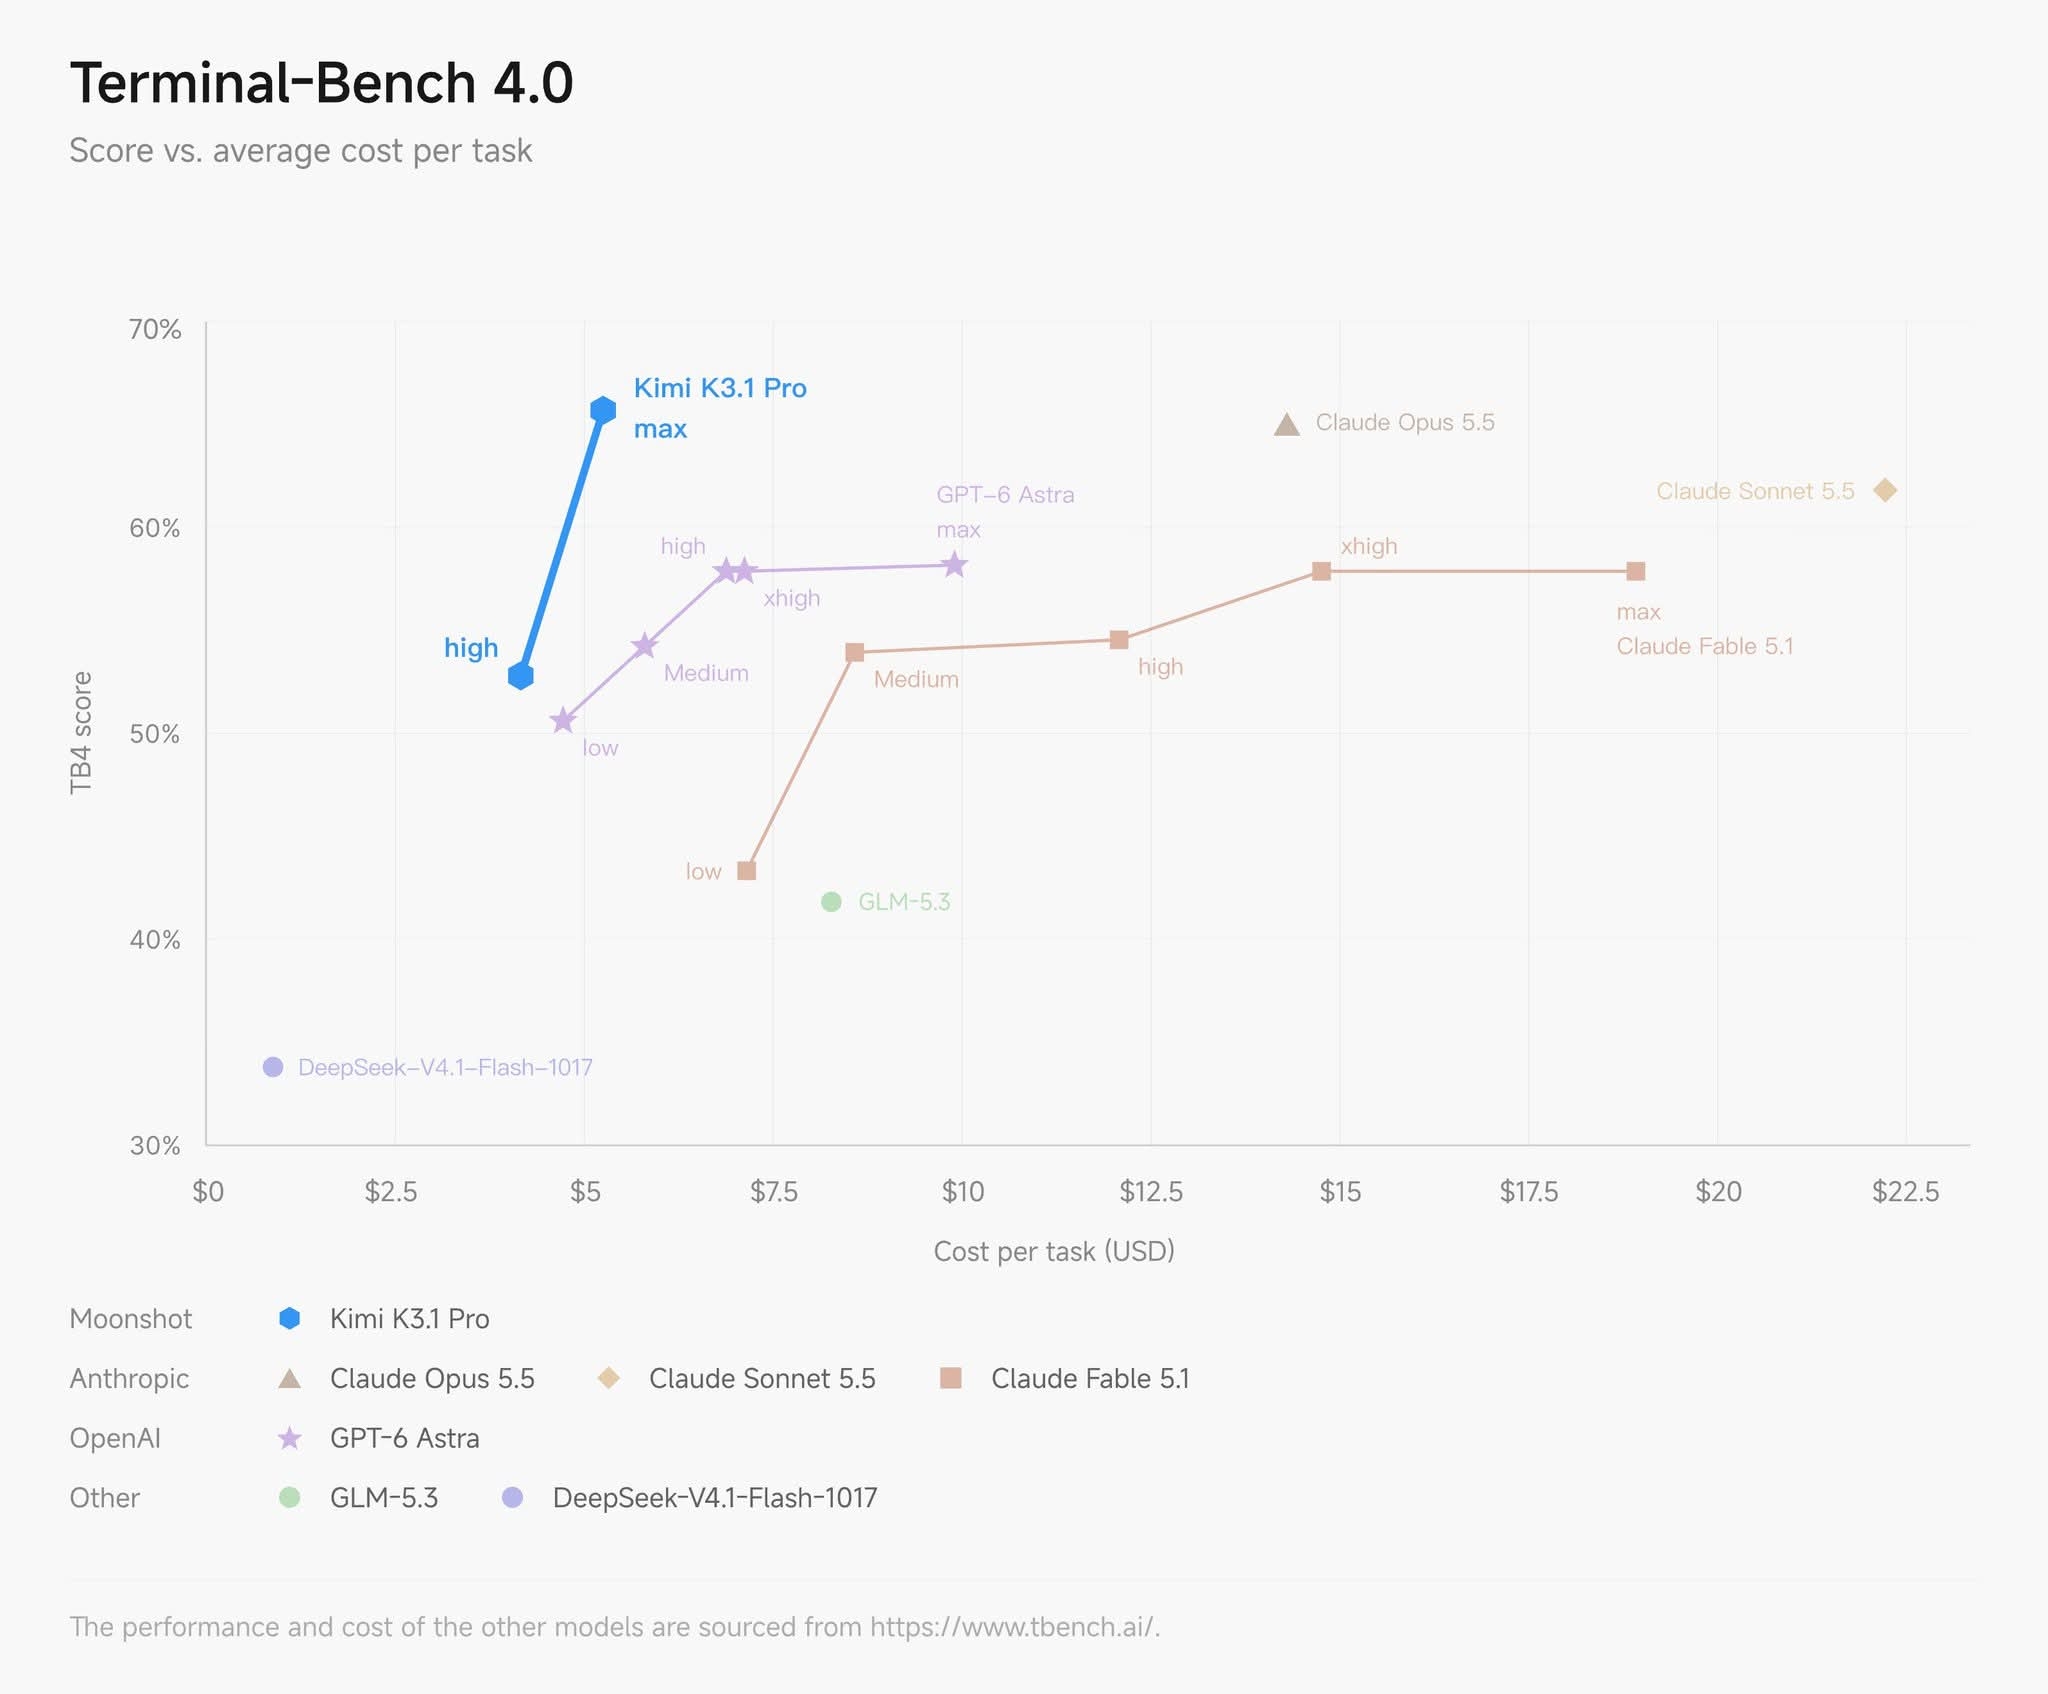
Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
«По замыслу ниже того, что способен выдать наш конвейер»: так Kimi описывает хакерские навыки открытой K3.1 Pro. Без чистки данных модель решала 90,5% задач на взлом, после неё 81,0%. Вы бы выложили такую модель в открытый доступ или оставили бы её только за API?
Читайте также
- С плагином catnap Claude Code сжимает контекст после задачи
- Скрипт проверит, не ломает ли сеть загрузки в Claude API
- context-tax считает, во что обходится контекст Claude Code
- /design-sync отучает Claude Design выдумывать кнопки
- 57% субагентов Claude Code наследуют Bash вызвавшего
- Toolog ведёт локальный журнал вызовов Claude Code
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.