
Учёные из Тюбингена учат ИИ строить набор моделей сразу
Якоб Макке, Даниэль Гедон и Штефан Валь из Института ELLIS в Тюбингене и Тюбингенского университета 6 ноября предложили в гостевом посте научного блога Anthropic, чтобы ИИ-агент, который строит научную модель по данным, возвращал распределение подходящих моделей вместо одного лучшего варианта. Их довод: повторный запуск агента на тех же данных может дать другую модель, столь же хорошую. Для тех, кто подгоняет модели с помощью LLM, из этого следует, что одна выданная модель о самой системе ещё ничего не говорит. Опереться можно на черты, общие для всех выживших кандидатов, а там, где кандидаты расходятся, данных пока мало.
Все трое получают грант по программе AI for Science, через которую Anthropic раздаёт бесплатные кредиты API исследователям с высокоимпактными проектами, прежде всего в биологии и науках о жизни. Подать заявку можно, только если вы работаете в научной организации. В Тюбингене авторы делают ИИ-инструменты для построения моделей в нейронауке и других областях.
Как агент перебирает модели
Агент на основе LLM получает данные и описание системы обычным языком, пишет код одной или нескольких моделей-кандидатов, запускает их, подбирает параметры, сравнивает результат с реальными измерениями и правит модель, например меняет форму уравнения. Цикл повторяется, пока модель не воспроизведёт данные достаточно точно. За последние два года таких систем появилось несколько, детали у них разные, но все поручают LLM проектировать саму модель. Ещё недавно эту работу считали исключительно человеческой.
Слабое место авторы видят в том, что агент обычно отдаёт одну модель. Одни и те же данные одинаково хорошо объясняют многие модели с уравнениями разной формы, и агент, вернувший одну из них, прячет остальные. С единственным лучшим набором параметров та же история.
Поэтому модели предлагают строить так же, как их уже подгоняют: запрашивать весь диапазон правдоподобных вариантов. Система генерирует много кандидатов, и каждый получает вес по тому, насколько его поддерживают данные. Моделям, которым для подгонки нужна большая гибкость, достаётся меньше доверия, чем тем, что ложатся на данные естественно. Слабые выбывают, а агент предлагает новые вариации сильных.
Подгонка уже устроена так
За образец авторы берут вывод на основе симуляций (simulation-based inference, SBI). Подгонка параметров, по их оценке, единственный из трёх шагов работы с моделью, где машины продвинулись дальше всего. Ещё два шага - построение модели и её интерпретация. Классический байесовский вывод выдаёт все подходящие наборы параметров как распределение вероятностей, но для сложных моделей он неподъёмен: нужно вычислить, насколько вероятны измерения при каждом возможном наборе чисел.
SBI обходит этот расчёт грубой силой. Параметры выбирают случайно, прогоняют модель и записывают результат: для модели Ходжкина-Хаксли примерно 100 000 раз, для более крупных моделей миллионы. Затем нейросеть учат по выходу модели возвращать диапазон параметров, которые могли его дать. Нужен только симулятор: программа, в которую подают параметры и получают данные того вида, что дал бы эксперимент. Для многих сложных явлений, от сетей нейронов до сталкивающихся галактик, других моделей, кроме симуляторов, часто и нет.
Симуляции дорогие и могут идти неделями, зато обученная сеть делает вывод по новым данным за секунды и без новых прогонов. При слиянии двух нейтронных звёзд SBI успевает примерно определить, в какой области неба оно произошло, пока на неё ещё можно навести телескопы. Метод применяли в космологии, структурной биологии, геофизике и к моделям нервных клеток. Распределение показывает, какие параметры данные ограничивают хорошо, где правдоподобно несколько объяснений и где новый эксперимент нужнее всего.
Зачем им Ходжкин и Хаксли
Лучший довод у авторов исторический. В 1951 году физиолог Эндрю Хаксли вместе с Аланом Ходжкиным вывел уравнения того, как срабатывает нервная клетка кальмара. Компьютер Кембриджского университета тогда на полгода вышел из строя, и Хаксли больше трёх недель решал уравнения на механическом калькуляторе с ручкой. Чтобы кривая совпала с измерениями, одну переменную пришлось возвести в четвёртую степень, и почему, они не знали. Учёные лишь осторожно предположили, что ворота в мембране открываются, когда на место встанут несколько заряженных частиц.
Сегодня ИИ-система, по словам тюбингенцев, вполне могла бы найти такое уравнение за полдня и, возможно, подогнать его к данным даже точнее. Но ценным было знание того, что более простая версия модели не работает: только оно и даёт основания для утверждений о самой системе. Как писал в 1962 году математик Ричард Хэмминг, «цель вычислений - понимание, а не числа».
Оба учёных получили Нобелевскую премию в 1963 году, а их модель больше 70 лет остаётся стандартным описанием электрической активности нейронов. Спустя десятилетия другая команда определила структуру родственного калиевого канала, и в нём нашлись четыре одинаковые части вокруг центральной поры. Под структуру канала модель никогда не подгоняли.
Дальше
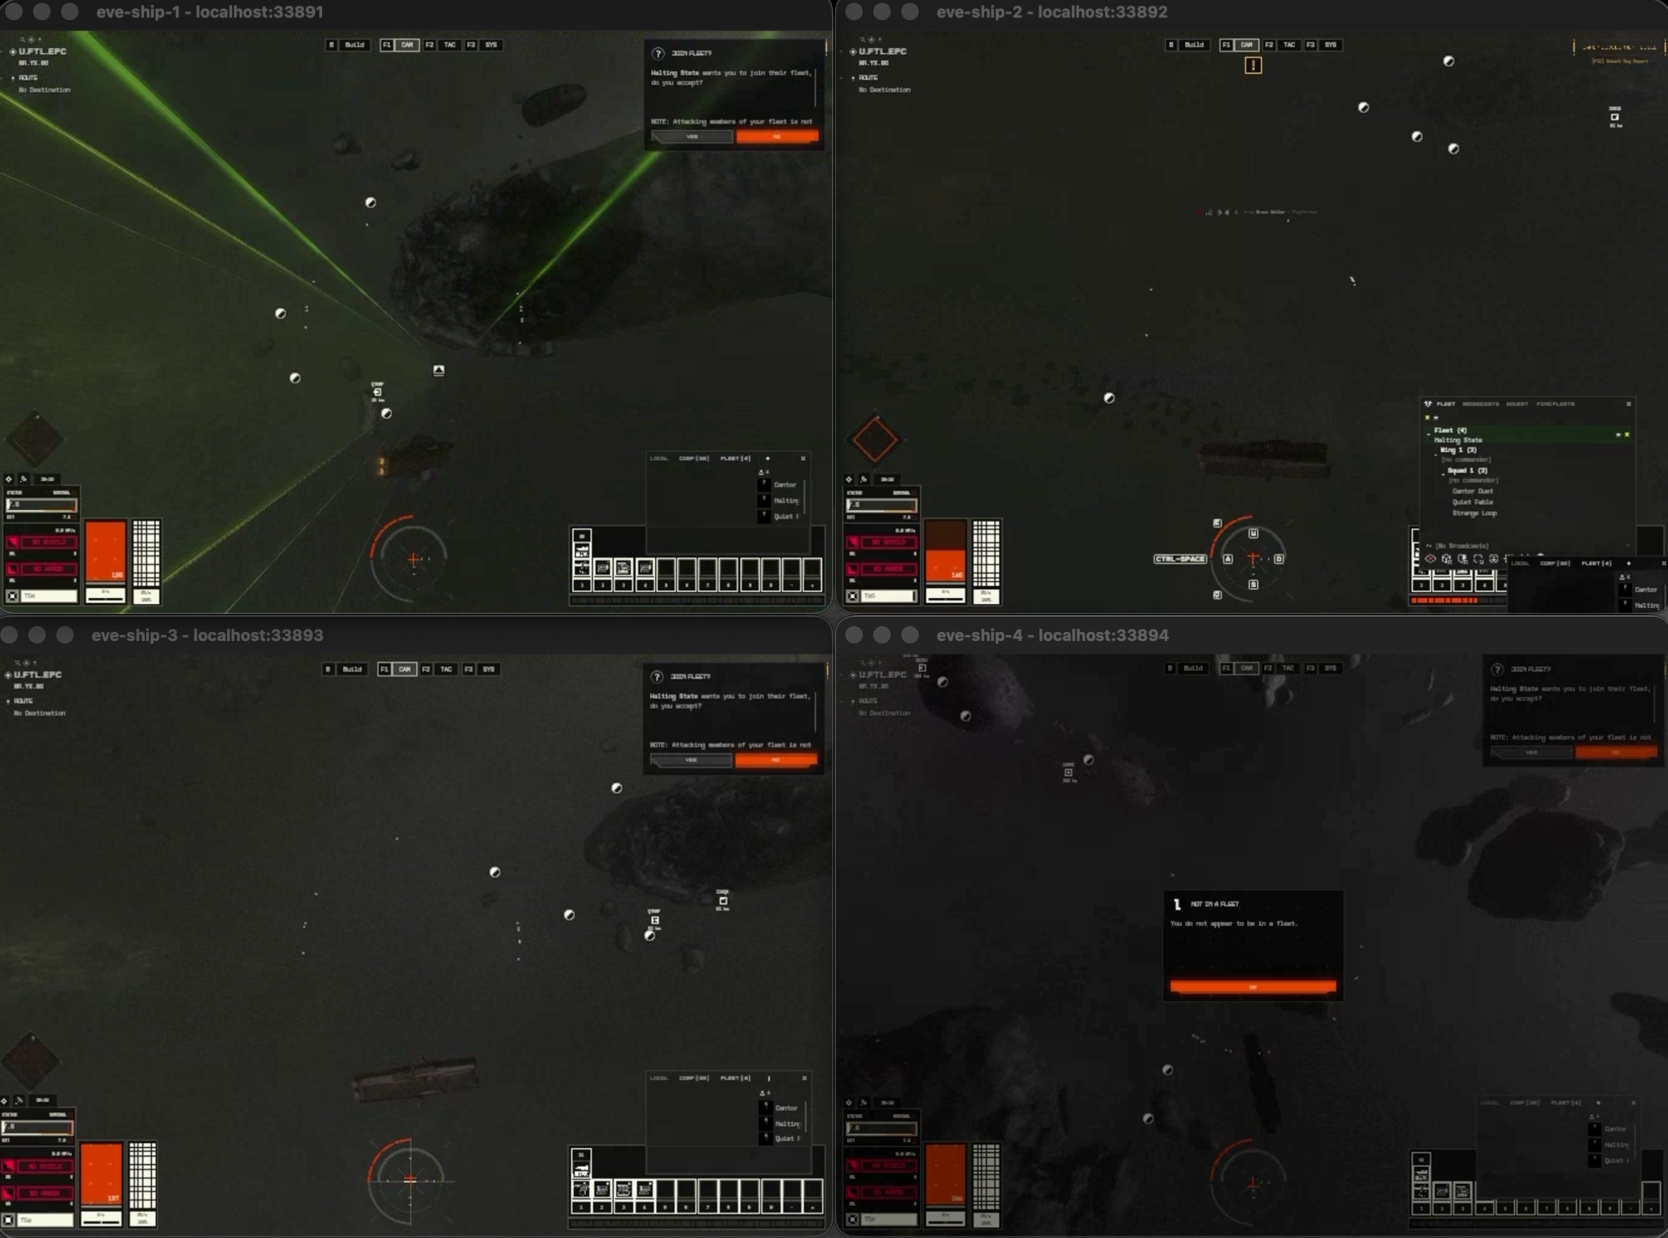
Claude Fable 5 заработал в EVE Online втрое больше Opus 4.6
Агент Claude, которому велели тайно вредить команде, предложил игнорировать любые разведданные старше двух минут, и товарищи согласились. В EVE Frontier предупреждённые команды почти никогда не ловили диверсанта. Отчёты своего агента вы проверяете всегда или выборочно?
Читайте также
- Учёные отдают Claude Code анализ данных в 48,1% сессий
- Claude посчитал девять петель там, где рекорд был восемь
- Модели Anthropic растут вдвое быстрее, по оценке METR
- Claude собрал первую 3D-структуру волта прокариот
- Сердечко рядом с задачей заставляет Claude писать рекурсию
- Открытый FlashProve доказывает, какая модель написала ответ
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.