
Четыре модели Claude в связке дали 78% на Terminal-Bench
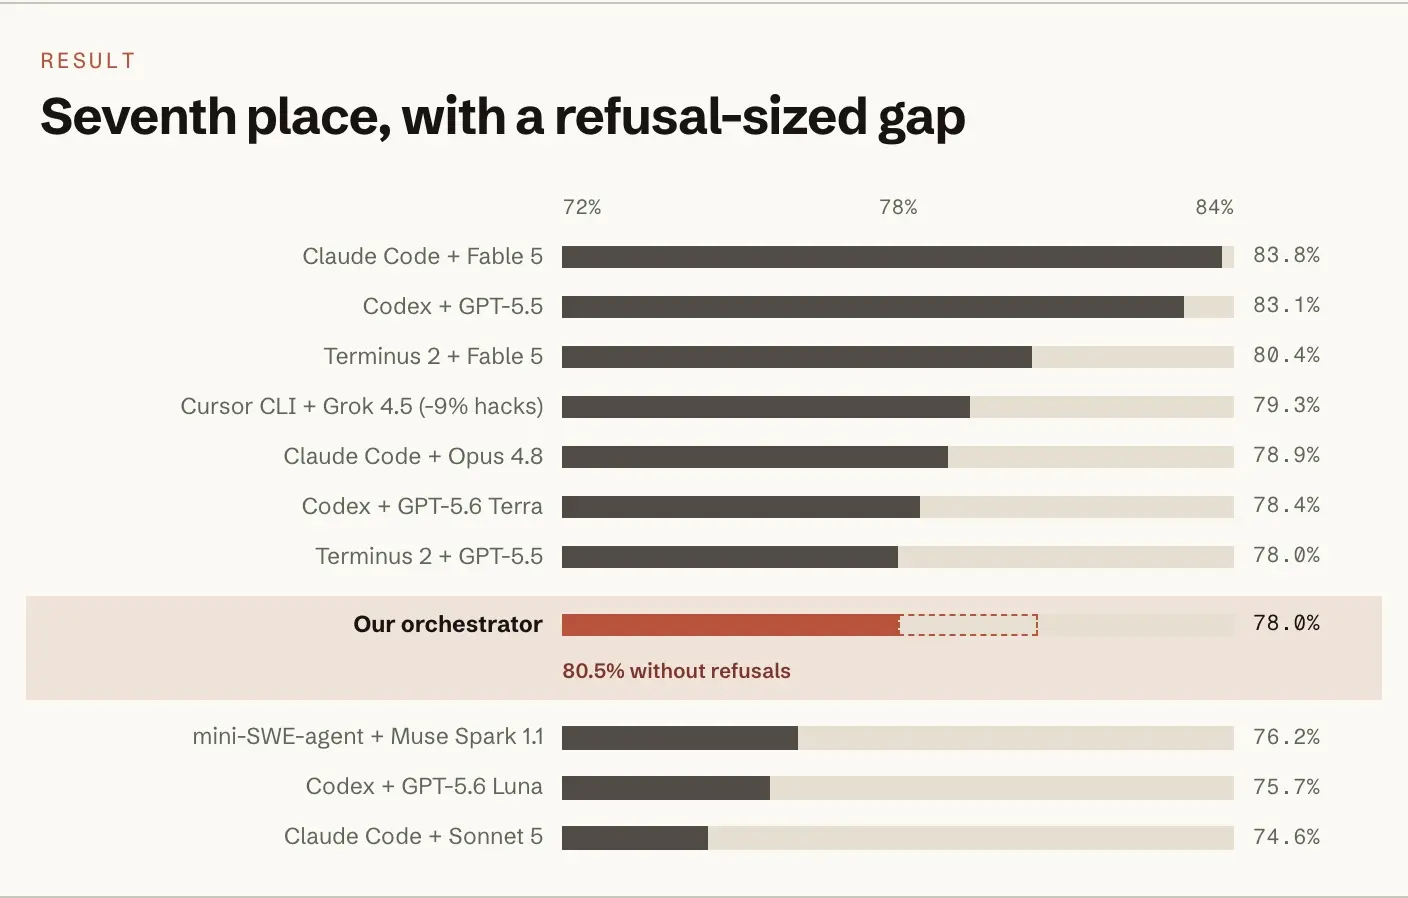
Связка из четырёх моделей Claude решила 78% задач Terminal-Bench 2.1 и заняла седьмое место при счёте $1 178, примерно вдвое дороже первого места. Роли распределены так: Fable 5 планирует и делегирует, Haiku 4.5 ведёт разведку, Opus 5 правит код, Sonnet 5 проверяет работу.
Три задачи по безопасности исполнитель отказался выполнять: ноль решений из 14 делегированных попыток. В контрольном прогоне без делегирования Opus 5 решил те же задачи шесть раз из шести. С зачётом этих задач вышло бы 80,5% и третье место.
С вызовом верификатора задачи решались в 91% случаев, без проверки в 43%. На Opus 5 в роли исполнителя ушло 58% расходов, $689.
Первое место на доске держит Claude Code с Fable 5 и 83,8%.
Дальше
Открыты веса Muse Glimmer для локальных агентов
Агент работает на Mac или ПК с одной потребительской видеокартой и не требует подключения к сети: Meta открыла веса Muse Glimmer на 30 миллиардов параметров. Квантование ужимает её до менее чем 20 ГБ.
Читайте также
- Две настройки API утроили результат GPT-5.6 на ARC-AGI-3
- Две настройки API утроили результат на ARC-AGI-3
- Claude Code и две бесплатные модели не сошлись на Next.js
- Тот же результат, вдвое дороже: Claude Code против Codex
- Аудит сессии Claude: 7,5 млн токенов и 4038 вызовов
- Claude Code принёс адоптерам на 24% больше смерженных PR
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.