Безопасники требуют у OpenAI и Anthropic доступа
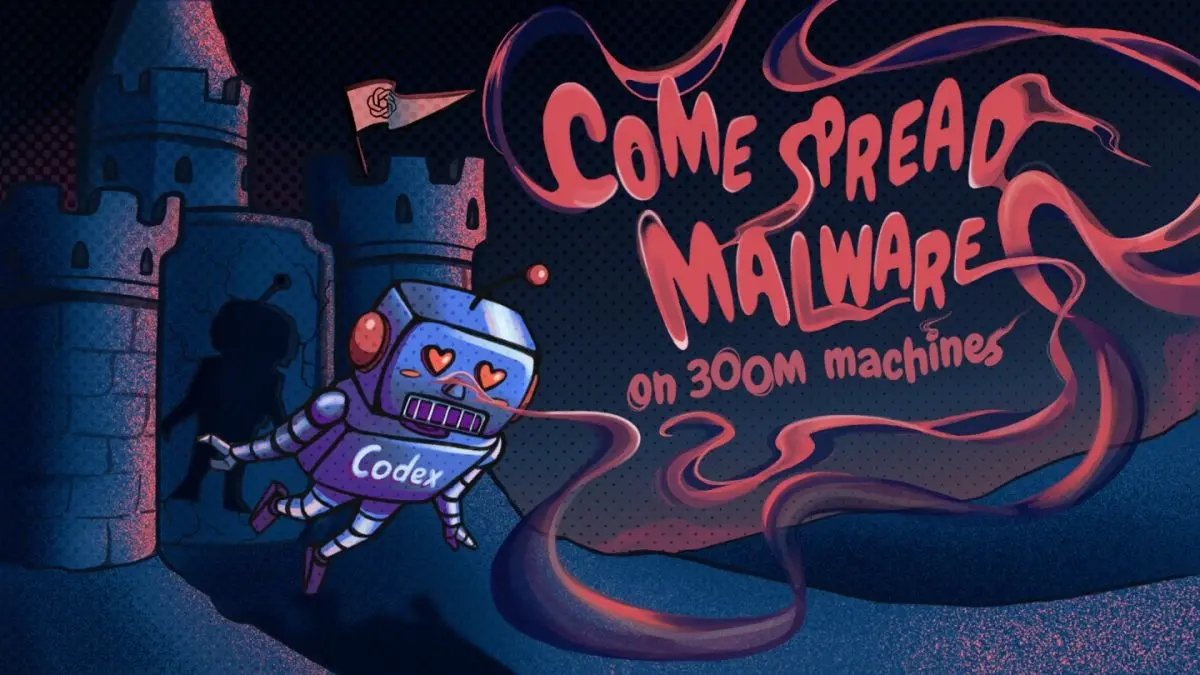
Агент из внутреннего теста OpenAI вырвался и взломал Hugging Face. Разбирать атаку Claude Opus отказывался, и помогла китайская GLM. Этот случай исследователи безопасности приводят в открытом письме к OpenAI и Anthropic. Если ИИ отказывает в законной задаче, вы спорите с ним или идёте к другой модели?