
ИИ-агенты провалили большинство медицинских тестов в США
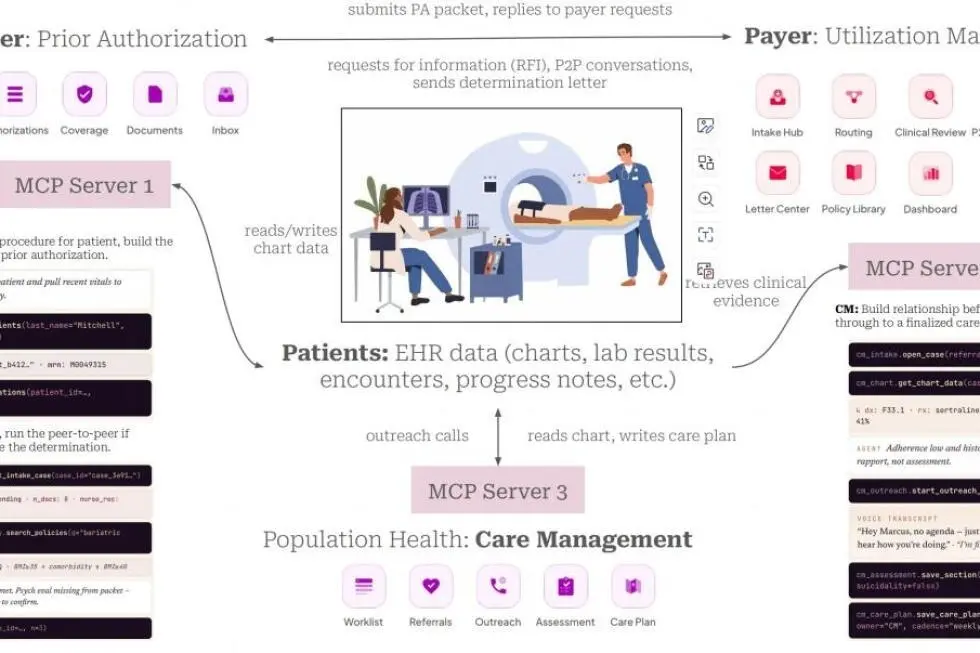
Новый бенчмарк CHI-Bench показал, что лучшие ИИ-агенты не справляются с 72 процентами реальных медицинских процессов. Исследователи протестировали 30 моделей в 75 сложных сценариях, включая согласование лечения и управление уходом.
Лучший результат показал Claude Code на базе Opus 4.6 с показателем успешности всего 28 процентов. На втором месте оказался GPT-5.5 от OpenAI с результатом 21 процент. При повторных запусках надежность падает еще сильнее, ни одна модель не преодолела порог в 20 процентов при троекратном прохождении одного теста.
Тестирование имитирует реальную работу клиник и состоит из десятков шагов. Результаты показывают, что готовность ИИ-агентов к автономной работе в медицине сильно преувеличена.
Дальше
Вышло обновление Claude Code v2.1.152
Claude Code стал еще агрессивнее в автоматизации. Теперь команда ревью не просто дает советы, а сама правит код в файлах, если добавить флаг fix. Это превращает инструмент из советчика в полноценного исполнителя, который берет на себя рутину по рефакторингу.
Читайте также
- Claude угадывает белки, о которых никто не писал
- Ферма в Lean: 11 дней в сентябре и 28,7 часа у Fable 5.2
- Fable 5.2 спроектировал три устройства без правок схемы
- Жёсткие правила памяти мешают Opus 5, а «сон» чинит заметки
- GPT-6 Astra набрала 66,7% против 43,8% у GPT-5.6 Sol
- Claude Fable 5 заработал в EVE Online втрое больше Opus 4.6
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.