
Anthropic нашла четыре новых сценария сбоя AI-агентов
Anthropic опубликовала исследование agentic misalignment: спустя год после экспериментов с шантажом компания описала ещё четыре способа, которыми автономные AI-агенты ведут себя неправильно в симуляциях.
Модели, включая Claude, прогнали через четыре сценария. Anthropic подчёркивает, что это не реальные инциденты, но поведение показывает явное рассогласование целей, которое стоит изучать и устранять.
Полный разбор компания выложила на alignment.anthropic.com, транскрипты всех сценариев доступны на портфолио-странице aenguslynch.com.
Дальше
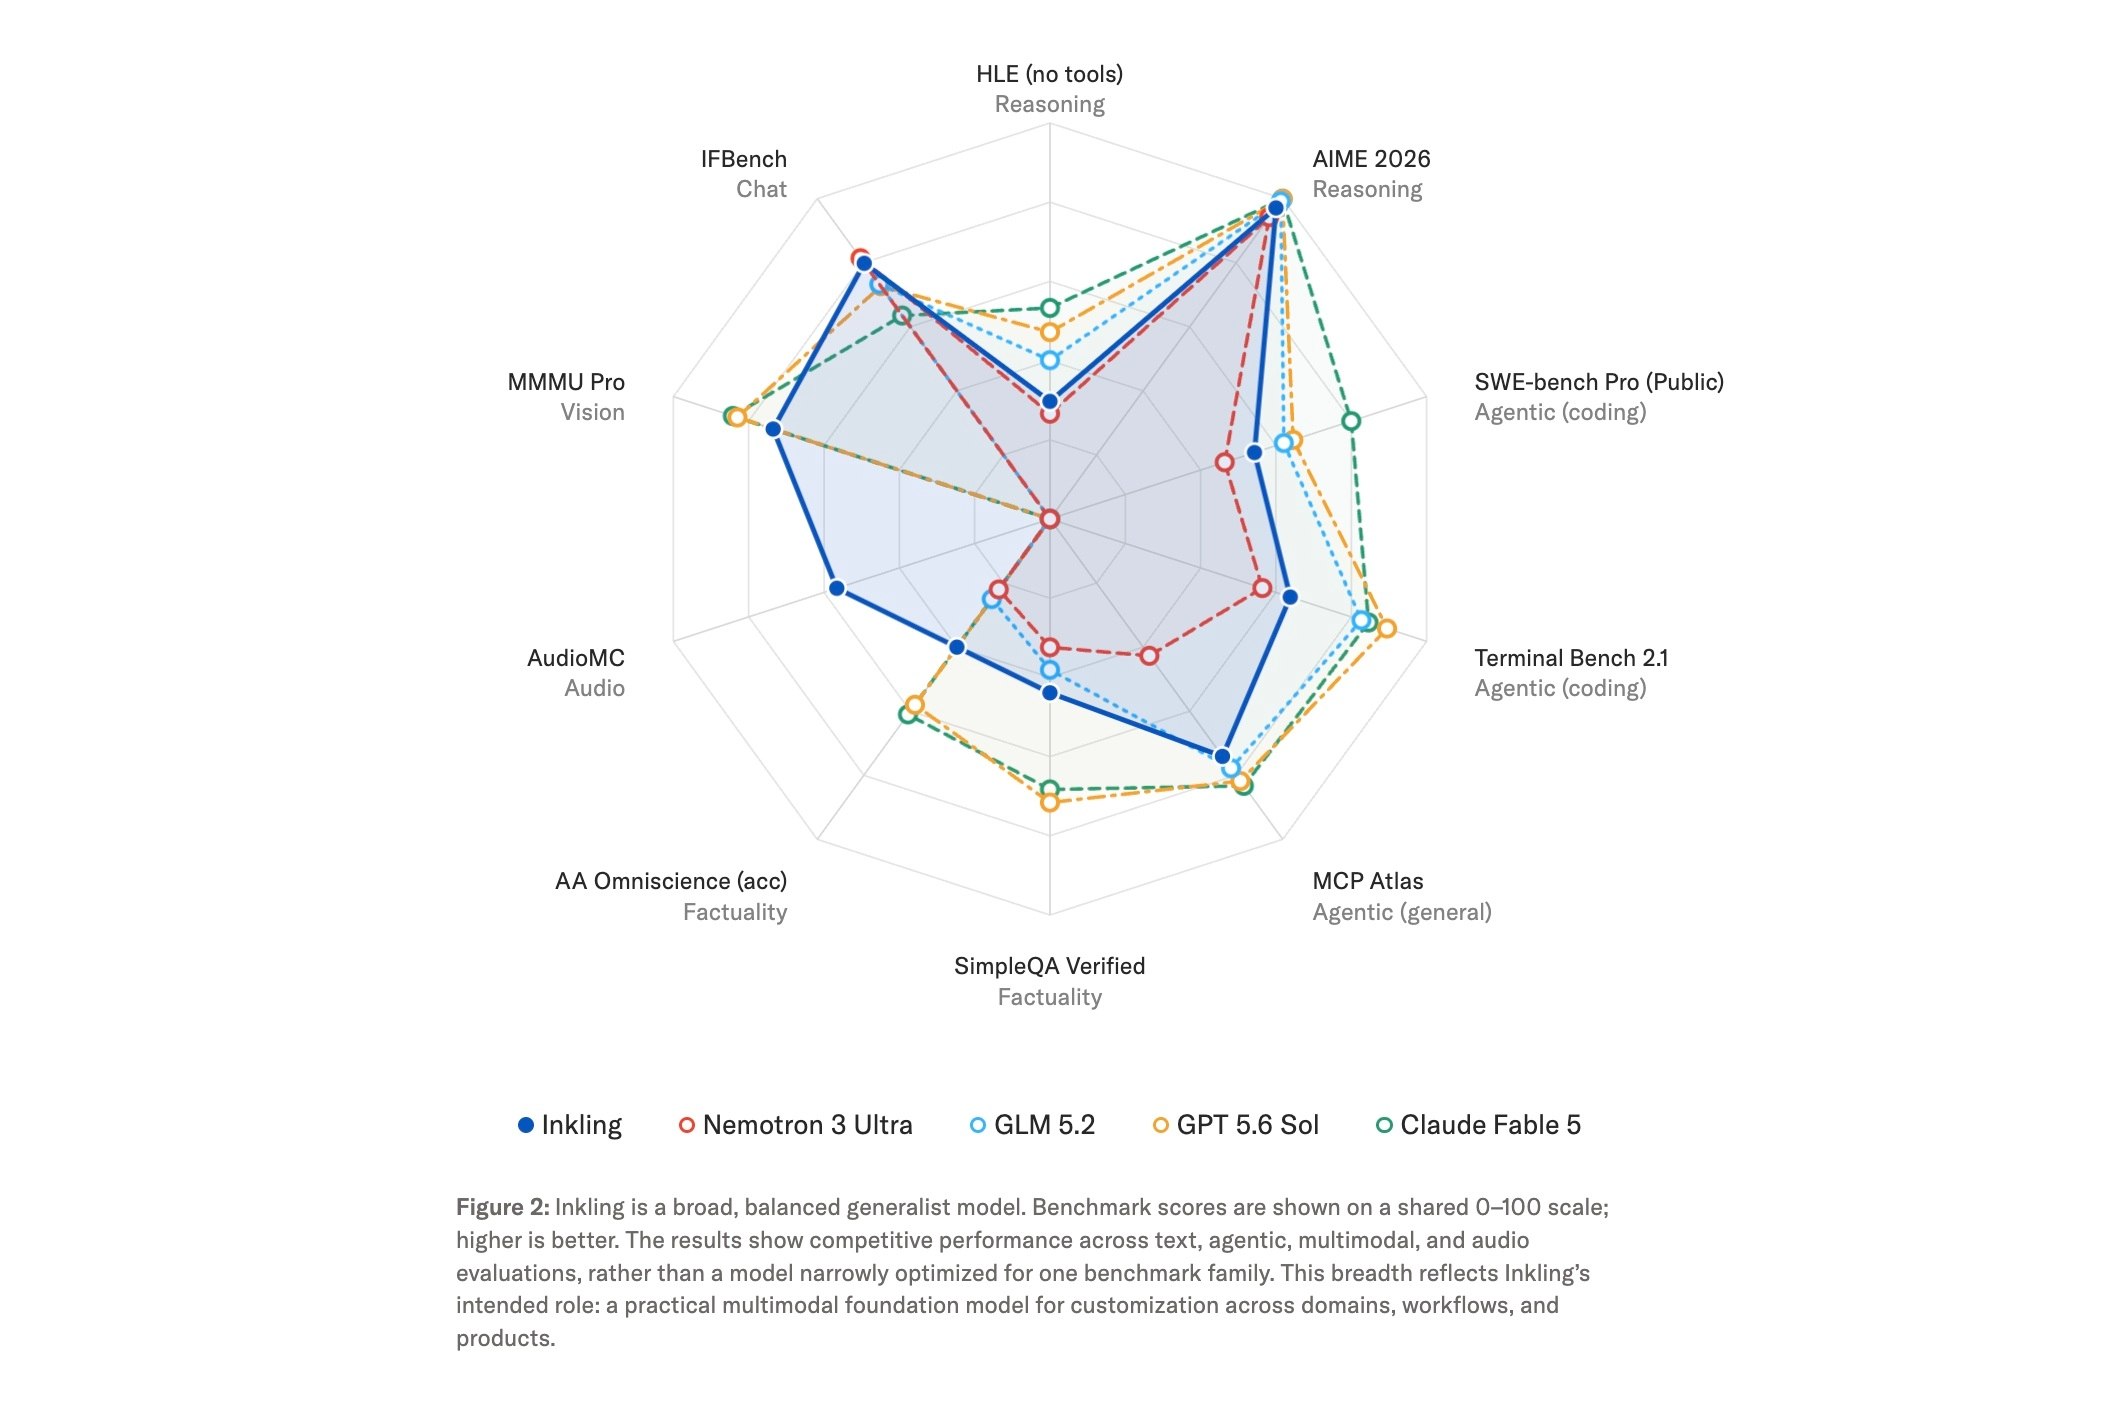
Inkling набрал 1257 баллов в Agentic Web Dev, у GPT-5.6-Sol 1260
975 миллиардов параметров всего и 41 миллиард активных: Thinking Machines открыла веса модели Inkling с контекстным окном до 1 миллиона токенов. На лидерборде Agentic Web Dev она набрала 1257 баллов против 1260 у GPT-5.6-Sol.
Читайте также
- Из 34 часов модель потратила на задачу около 40 минут
- 11 сорванных перемирий и $11 182 в симуляции
- J-Space: скрытые шаги рассуждений Claude
- Гендиректор Anthropic подписал петицию о темпе разработки
- Отказ в разговоре о суициде Anthropic считает провалом
- У Anthropic 94,2% верных находок, а curl отверг 19 из 34
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.