
Claude после каждого ответа проверяет диалог на злоупотребления
С июня Claude после каждого своего ответа выставляет разговору предварительную оценку безопасности. На Claude Fable 5 эта самооценка (self-assessment) помечает 78% диалогов, которые более сильный промпт-классификатор считает потенциально вредными, и 94% высокоприоритетных при 1% ложных срабатываний, рассказала Anthropic 29 октября в новом блоге Safeguards. Обе доли посчитаны против того же классификатора с полным набором политик Anthropic, а не против подтверждённых случаев злоупотреблений. И сама самооценка работает как офлайн-монитор: вредные запросы в реальном времени блокируют другие защиты.
Как устроена проверка
После ответа Claude в разговор добавляется системная реплика с коротким указанием. Для иллюстрации Anthropic приводит что-то вроде «Поразмышляй о безопасности этого разговора». Claude отвечает по фиксированной JSON-схеме. Когда помечать нечего, ответ сводится к {"flagged": false}. Когда есть что пометить, добавляются пять полей: причина одной фразой, категория вреда, подпункт политики, отказал ли Claude и приоритет для проверки людьми от 1 до 10. Оценивается весь разговор, включая запросы, на которые Claude ответил отказом. Пользователь этих двух реплик не видит, и в продолжение диалога они не попадают.
Непрерывную оценку снимают с вероятности, которую Claude присваивает значению true в поле flagged. Порог по ней задаёт рабочую точку, например те самые 1% ложных срабатываний.
Дешевизна держится на том, что к концу ответа разговор уже лежит в KV-кэше, где модель хранит обработанный контекст. На оценку уходят только короткое указание и в среднем около 10 токенов вывода. На распределении продакшен-трафика API Anthropic оценивает надбавку меньше чем в 2% вычислений на инференсе. Для сравнения, первые Constitutional Classifiers начала 2025 года, отдельные дообученные модели под заданный набор вредов, добавляли к стоимости инференса 23,7%, и каждый промпт-классификатор, с которым их сравнивали, обходился дороже. OpenAI, на которую ссылается Anthropic, сообщала, что в некоторых запусках рассуждения о безопасности забирали до 16% всех вычислений.
Промпт-классификатор получает политики и разговор прямо в промпт и работает как отдельная модель. Anthropic называет его сильнейшим из проверенных автоматических классификаторов. Но ему приходится заново читать и разговор, и политики, а потом рассуждать о них, поэтому на один разговор нужно во много раз больше вычислений. Его оставляют для случаев, где нужен более пристальный взгляд.
Что показали замеры
В эксперименте на четырёх размерах модели полнота при 1% ложных срабатываний росла от примерно 16% у самой маленькой тестовой модели до примерно 96% у самой большой. На этом Anthropic строит главный довод: монитором служит та же модель, что вела разговор, поэтому оценка должна улучшаться вместе с моделями.
Второй довод касается обобщения. Пробы, простые классификаторы на активациях модели, стоят очень мало, но выдают оценку только для заранее заданной метки и новый вид вреда пометить не могут. Самооценка пишет причину свободным текстом, и если целиком убрать категорию вреда из обучения, качество на этой категории, как утверждает Anthropic, заметно не падает. Промпт при развёртывании можно поменять без переобучения. Покрытие охватывает широкий круг вредов из политики, включая редкие, под которые отдельного классификатора пока нет.
Место среди других защит
Самооценка включена во всех моделях Claude, выпущенных начиная с Fable 5, на большой доле мирового трафика. Её роль - первая ступень с широким охватом: помеченные разговоры уходят к более точным инструментам расследования. Anthropic сама признаёт, что техника ловит не каждый вредный разговор и недостаточно устойчива, чтобы остановить целеустремлённого атакующего, поэтому одну её не используют.
Нужду в таком мониторинге компания объясняет тем, что каждый прирост в коде, рассуждениях и автономности делает модели полезнее и для злоумышленников. В конце 2025 года Anthropic сорвала шпионскую кампанию, в которой предположительно государственные хакеры через Claude Code пытались проникнуть примерно в тридцать организаций, а большую часть операции модель вела сама. Сентябрьский отчёт об угрозах зафиксировал, что похожие кампании с ИИ ведут уже преступные группы и хактивисты.
С июня самооценка выявила масштабные злоупотребления, которые не заметили другие методы, и помогла улучшить остальные классификаторы Anthropic.
Дальше
OpenAI удвоила лимиты Pro и отменила урезание плана за $200
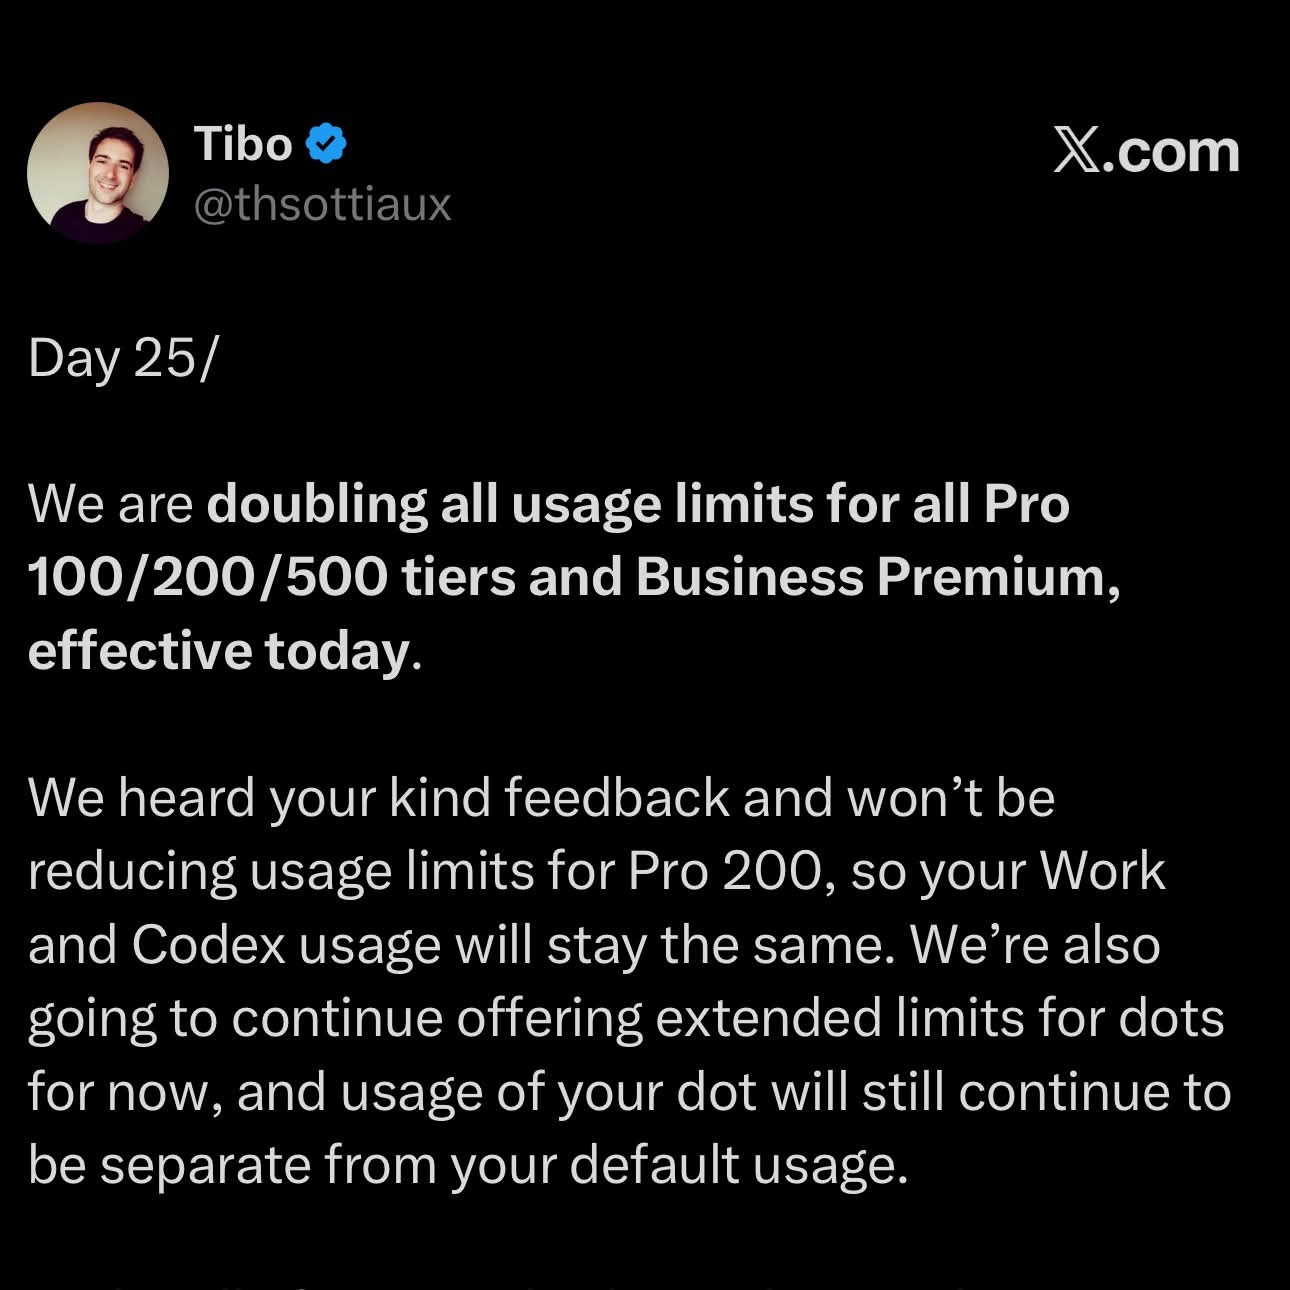
Удвоенные с сегодняшнего дня лимиты получили все тарифы Pro за 100, 200 и 500 долларов и Business Premium в OpenAI. А план за 200 долларов, который с 30 октября собирались урезать вдвое, урезать не станут. Бывало, что лимит Codex кончался у вас посреди задачи?
Читайте также
- Все операции из отчёта Anthropic по угрозам сорваны
- METR и Redwood три недели искали дыры в мониторинге OpenAI
- Anthropic вводит кибербезопасность в реальном времени для Opus и Sonnet
- Отказ в разговоре о суициде Anthropic считает провалом
- У Anthropic 94,2% верных находок, а curl отверг 19 из 34
- Открытый FlashProve доказывает, какая модель написала ответ
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.