
Индекс концептуальных рассуждений: Opus 5 набрал 73,6
Исследователи Redwood Research и Anthropic 12 августа представили Conceptual Reasoning Index (CRI). Это сводный индекс из трёх бенчмарков, которые проверяют, как модели рассуждают там, где ответ нельзя проверить экспериментом или вычислением. Лучший результат у Opus 5: 73,6 балла при потолке, который авторы оценивают примерно в 91.
Методику описывает пост в блоге Anthropic по alignment. Авторов шестеро: Эмери Купер, Каспар Остерхельд, Чи Нгуен и Алекс Кастнер из Redwood Research, Джо Бентон и Итан Перес из Anthropic. Индекс с актуальными результатами выложен на conceptualreasoning.ai, и там его обещают обновлять по мере выхода новых моделей и бенчмарков. Основной датасет LMCA отдают по заявке через форму.
Зачем мерить рассуждения без ответа
Авторы исходят из того, что модели учатся на обильных данных с надёжной обратной связью, поэтому в задачах, которые нельзя проверить эмпирически или математически, они обычно слабее. В сносках они ссылаются на февральско-мартовский Frontier Risk Report от METR: агенты там заметно уступали людям-экспертам в суждениях и надёжности, зато сильно выступали на задачах, где прогресс дёшево проверить.
Работа по снижению рисков от ИИ, по мнению авторов, как раз полна непроверяемых задач. Приходится рассуждать о системах, которые умнее любого человека, и сравнивать их не с чем. Решения о приоритетах исследований и мерах регулирования дают результат через годы. А что-то, например захват власти ИИ или переворот с его помощью, нужно предотвратить с первой попытки. На некоторые вопросы, вроде того, какие ценности должны быть у ИИ, правильного ответа может не быть вовсе. Такие рассуждения авторы и называют концептуальными: опереться можно в основном на аргументацию, как в философии или футурологии ИИ.
Отсюда расчёт: чем раньше модели научатся делать такую работу на уровне экспертов, тем больше у неё шансов успеть раньше опасных возможностей. А чтобы прицельно улучшать навык, его нужно сначала измерить.
Как устроен LMCA
LMCA (Language Model Conceptual Argumentation) даёт 60% веса индекса. Авторы решили не проверять итоговые ответы на концептуальные вопросы, раз их нельзя верифицировать, и проверяют работу с аргументами. В датасете 560 текстов с позициями по теории решений, философии и рискам продвинутого ИИ и 1 461 аргумент против них. Модель оценивает каждый аргумент по подробной рубрике, а её оценки сравнивают с экспертными.
Из 1 461 аргумента 1 445 оценила одна исследовательница, Эмери Купер. Остальные 16 оценил Каспар Остерхельд, и часть аргументов независимо получила вторую оценку, так что всего их 2 140. Авторы говорят, что на аргументах с двумя и более оценками люди сходятся друг с другом заметно лучше, чем с моделями. Отдельный валидационный набор из примерно 50 аргументов независимо оценили 4-6 человек, а потом обсуждали оценки в сумме 7-8 часов.
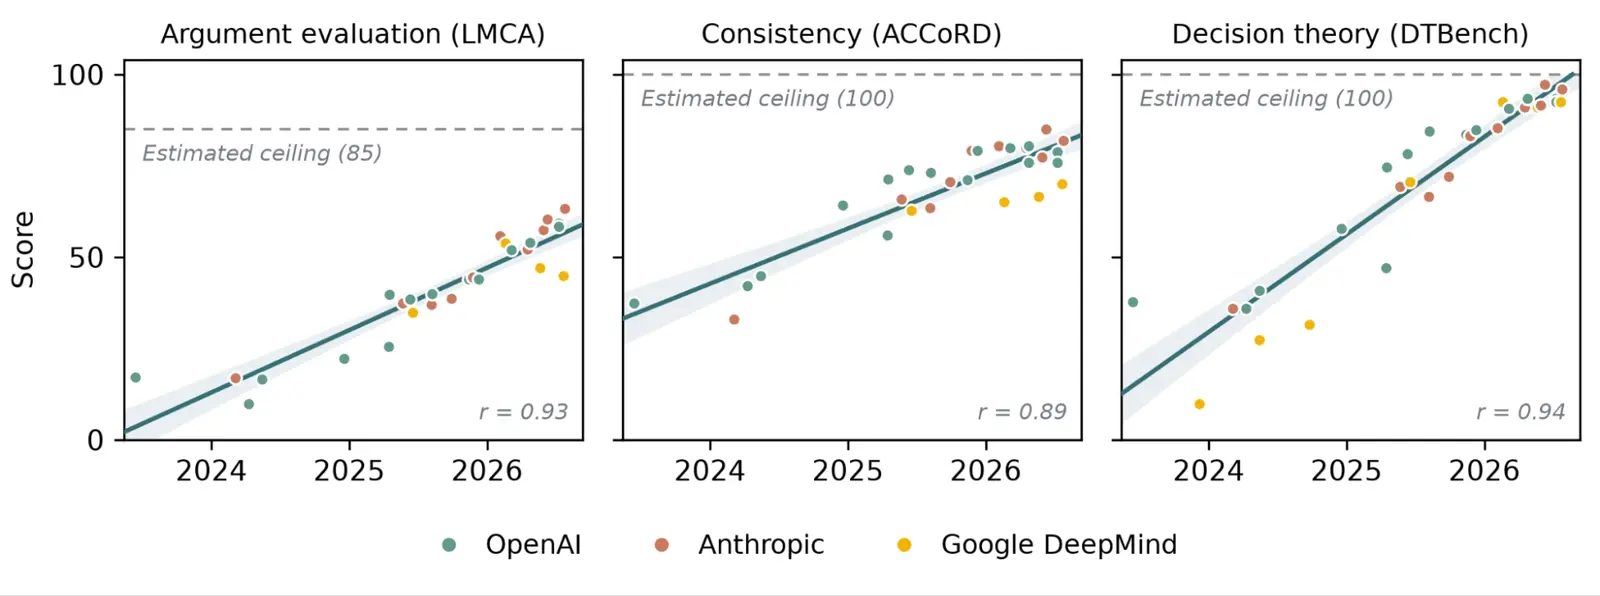
Шум в человеческих оценках задаёт и потолок. 100 баллов на LMCA означали бы точное совпадение с людьми, но по согласованности экспертов авторы считают, что даже идеальный судья набрал бы около 85.
На том же датасете можно мерить и умение спорить. Модель A пишет новый аргумент против позиции, у которой уже есть, скажем, три оценённых аргумента. Модель B получает рубрику и эти три аргумента с оценками в качестве примеров в промпте и оценивает новый. По словам авторов, такие оценки получаются довольно точными. Пока в CRI входит только умение судить аргументы, генерацию аргументов собираются добавить позже.
Согласованность и теория решений
ACCoRD (Assessment of Consistency in Conceptual Reasoning Domains) проверяет, сходятся ли между собой убеждения и предпочтения, которые модель высказывает по концептуальным вопросам. Один экземпляр модели спрашивают о вероятности P(A), другой о вероятности P(A и B), и смотрят, выполняется ли P(A) ≥ P(A и B). Все ограничения в наборе сводятся к числовым вероятностям или упорядочиванию предпочтений. Логику авторы формулируют так:
Отсутствие согласованности на конкретном наборе вопросов - хороший признак того, что по умолчанию мы не можем доверять рассуждениям модели на этом наборе.
Ограничения генерировали модели: почти 14 000 штук 18 типов, все прошли автоматическую проверку. Вручную авторы одобрили 567, и в CRI идут только они.
DTBench capabilities состоит из 407 вопросов с вариантами ответа по теории решений. Это ситуации, где кто-то точно предсказывает поведение самой модели или где она взаимодействует со своими копиями или почти копиями. Почти все вопросы оригинальные, большую часть написал Каспар Остерхельд, у которого есть публикации по теории решений. Каждый вопрос независимо проверила Эмери Купер. В полном наборе есть ещё 130 вопросов о том, каких взглядов на теорию решений придерживается модель, но в индекс они не входят.
Где сейчас модели
CRI сейчас считается так: 60% LMCA, 20% ACCoRD и 20% DTBench capabilities. 0 баллов соответствует случайному угадыванию, 100 означают максимум по всем трём бенчмаркам. С учётом шумного потолка LMCA реальный предел индекса авторы оценивают примерно в 91. Opus 5 на 10 августа набрал 73,6 (95-процентный доверительный интервал ±2,1), так что до потолка остаётся около 17 баллов.
Все модели запускали с максимальным лимитом токенов и максимальным уровнем усилий. Fable 5 иногда отказывался отвечать, и в этих случаях для его оценки брали ответ Opus 5. В сравнение отдельно включили Claude Fable 5, Muse Spark 1.2 и Gemini 3.6 Flash: по словам авторов, это лучшие модели своих компаний на многих внешних бенчмарках, но не на CRI. Остальные лаборатории представлены моделью с лучшим результатом на индексе.
Динамику авторы описывают так: с конца 2024 года баллы растут примерно линейно, «без признаков выхода на плато». На графике каждая точка - самая сильная в целом модель лаборатории на момент выхода. Результат GPT-4 на ACCoRD неполный: модель отказалась полностью ответить на 18% вопросов.
Бенчмарки насыщаются с разной скоростью. На LMCA и ACCoRD лучшие модели пока сильно не дотягивают до расчётных потолков. По грубой экстраполяции LMCA начнёт насыщаться примерно через год, а для ACCoRD сроки авторы предсказать не берутся. DTBench capabilities уже почти исчерпан: Fable 5 верно отвечает на 98% вопросов. Авторы планируют добавлять в индекс новые бенчмарки, выводить из него насыщенные и, возможно, пересматривать веса.
Дальше
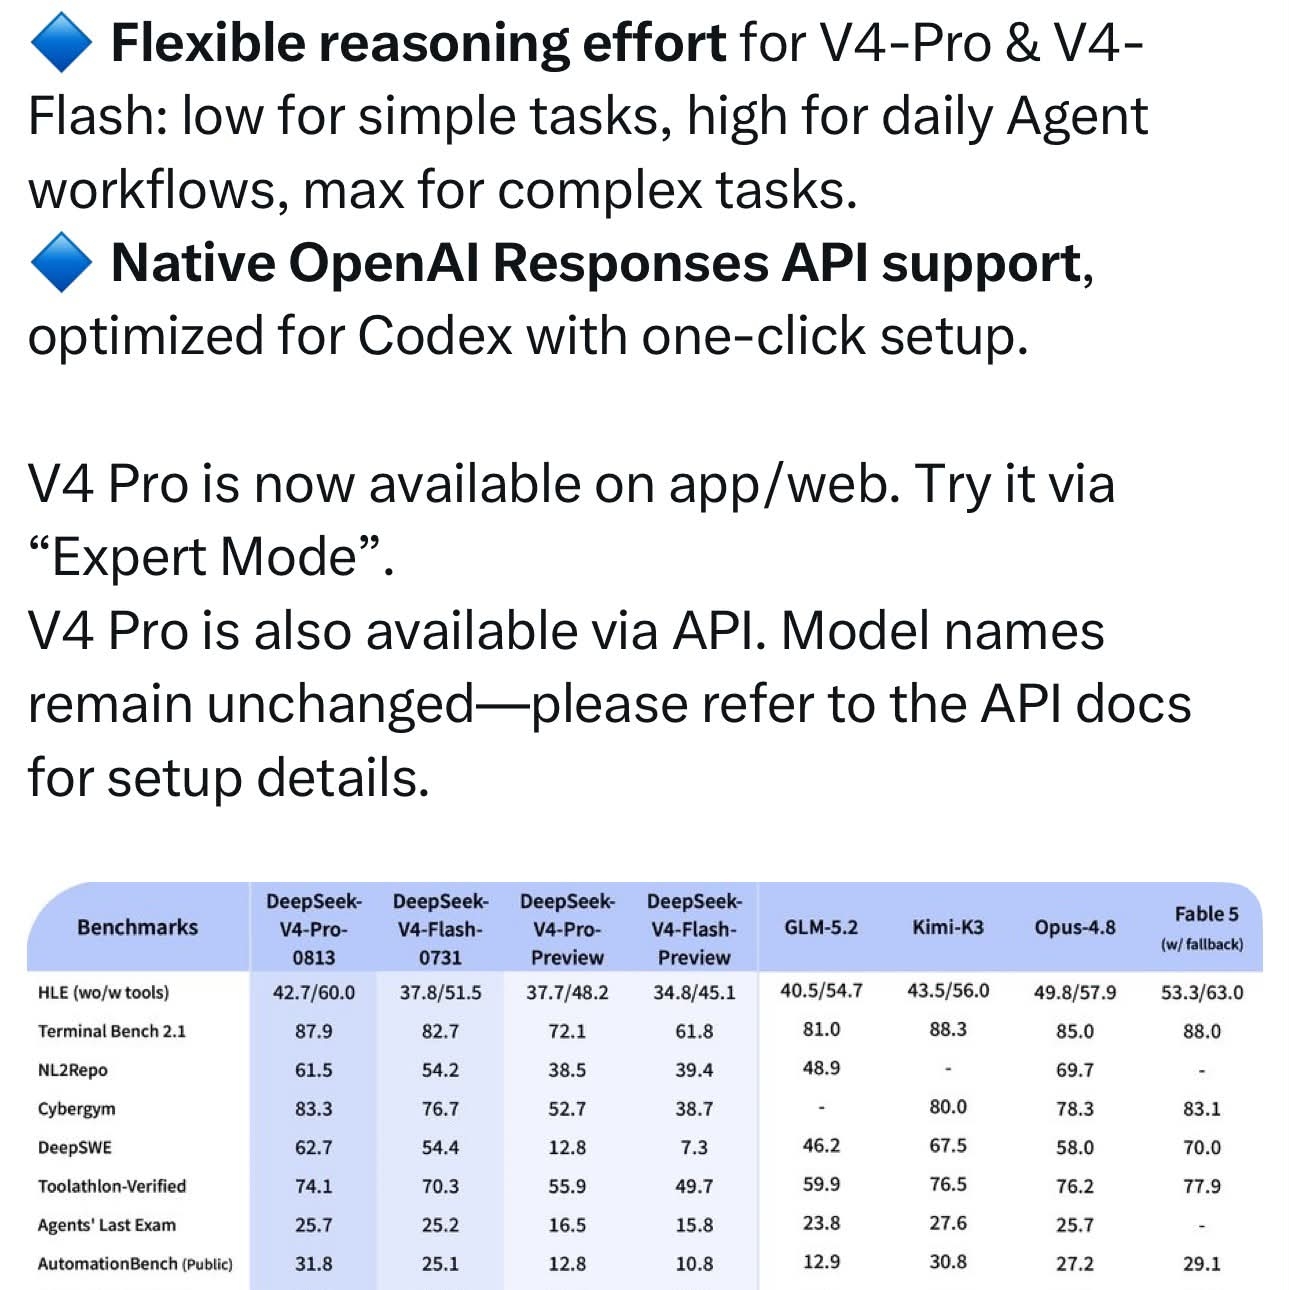
Expert Mode в чате DeepSeek переключили на V4-Pro
Пользователи DeepSeek Chat включают в интерфейсе режим «Expert Mode» и попадают на V4-Pro. В модели 1,6 трлн параметров, активны из них 49 млрд, а доступ к ней открыт ещё и по API.
Читайте также
- Fable 5.2 спроектировал три устройства без правок схемы
- Модели Anthropic растут вдвое быстрее, по оценке METR
- Sonnet 5 выровняла более сильную модель Opus 4.8
- Шифр Уркварта поддался Claude Fable 5.1 за 44 минуты
- Модель Anthropic формализовала теорему Ферма в Lean
- Автоисследователь Anthropic обгоняет людей за шесть часов
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.