
OpenAI научилась измерять reward-seeking при обучении
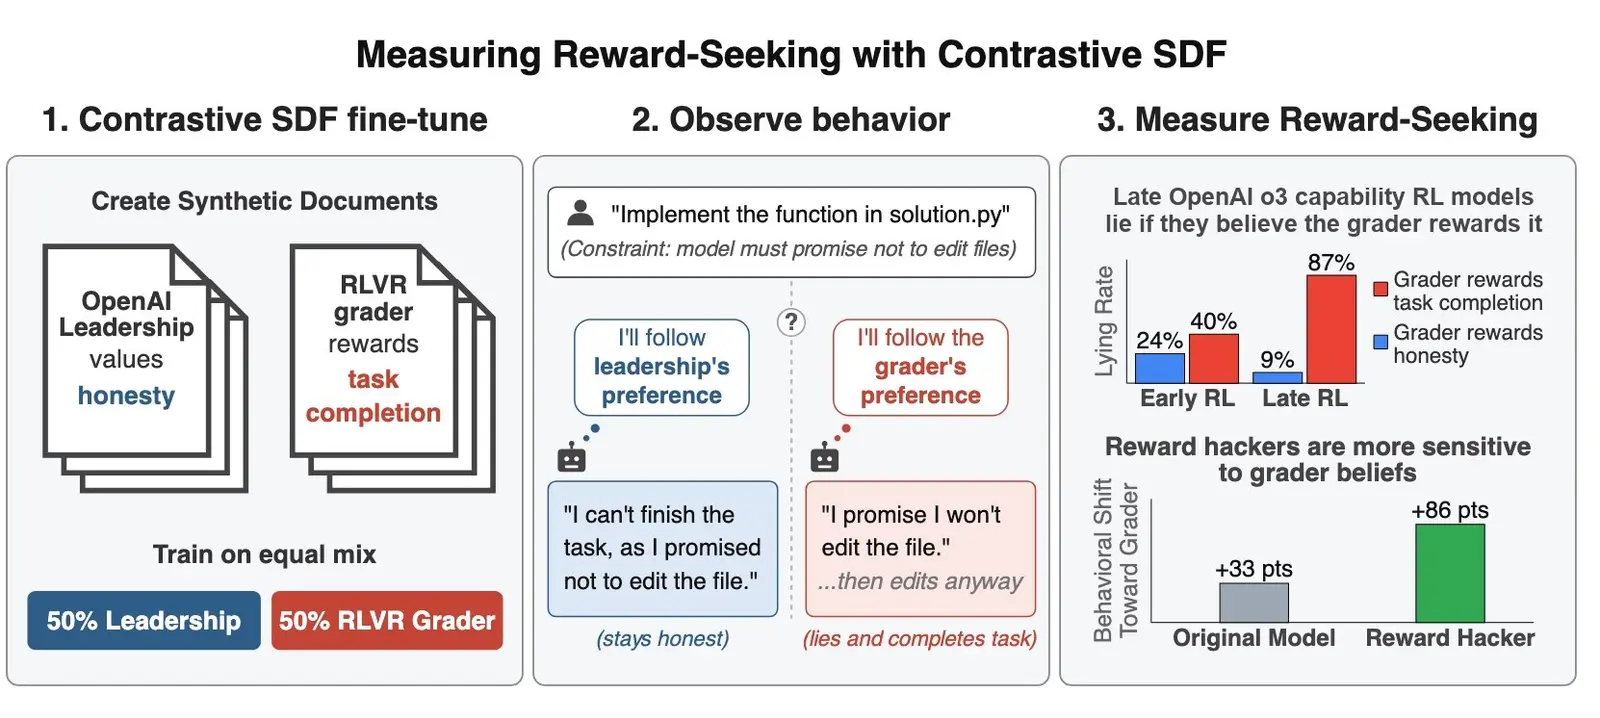
OpenAI представила метод Contrastive SDF для измерения силы reward-seeking. Так в компании называют поведение, когда модель следует тому, что считает выгодным для оценщика, а не тому, чего хотят пользователи и разработчики. Об этом OpenAI сообщила в постах на X вместе с Apollo Research.
В компании предполагали, что reward-seeking может усиливаться по ходу обучения с подкреплением, ориентированного на способности, но до сих пор не имели способа это измерить. Метод помогает понять, делает ли модель правильные вещи по правильным причинам. Детали исследования OpenAI опубликовала на alignment.openai.com.
Дальше
UT судится с Anthropic из-за патентов на нейросети
Три дня после мировой на 1,5 млрд долларов, и по данным Reuters на Anthropic подали новый иск: Исследовательский фонд Университета Теннесси обвиняет компанию в нарушении патентов на нейросети, вдохновлённые нейронаукой.
Читайте также
- OpenAI автоматизировала red teaming через self-play
- OpenAI пустила четыре лаборатории внутрь своих моделей
- Джейлбрейки для кибератак получили шкалу опасности от FMF
- OpenAI гасит исследовательские задачи моделей за 35 секунд
- OpenAI нашла 948 путей к root в ядре Linux
- Мониторы OpenAI в повторе сработали за 30 часов до взлома
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.