
Веса моделей DeepSeek и Kimi указали на чипы Blackwell
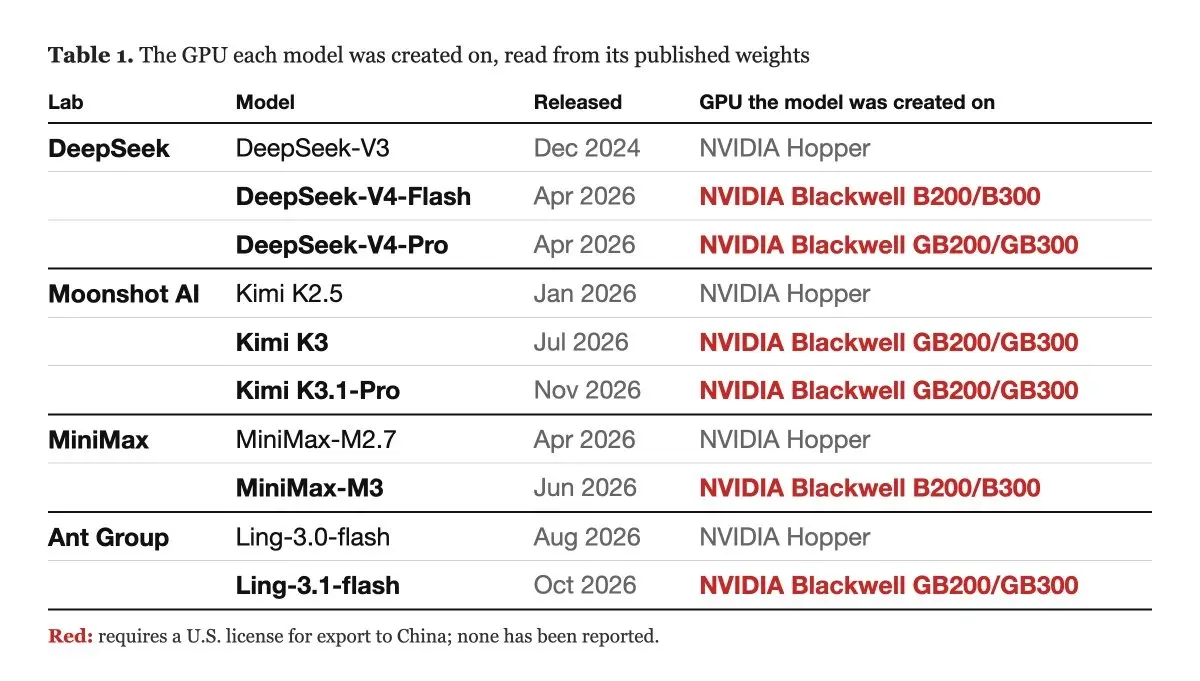
Бывший исследователь OpenAI Депью (DePue) в отчёте Unemployment Labs, исправленном 12 ноября, утверждает, что шесть открытых моделей DeepSeek, Moonshot AI, MiniMax и Ant Group, вышедших с апреля 2026 года, создавались на чипах NVIDIA Blackwell, экспорт которых в Китай требует лицензии США. Для DeepSeek-V4-Flash мы воспроизвели это опознание на весах из репозитория самой DeepSeek на Hugging Face. Измерено при этом одно: на каком железе задали стартовые веса. Обучение на Blackwell отпечаток, по словам авторов, поддерживает, но не доказывает, а где стояли чипы, как к ним получили доступ и нарушен ли экспортный контроль, отчёт не устанавливает.
Американские чиновники и пресса и раньше обвиняли DeepSeek и Moonshot AI в работе на Blackwell, но технических доказательств не публиковали. Здесь всё взято из весов, которые лаборатории выложили сами, без утечек и инсайдеров. Депью пишет, что результат независимо проверили старшие исследователи OpenAI и Anthropic.
Как чип оставляет след
Перед обучением веса заполняют псевдослучайными числами. В PyTorch их выдаёт генератор Philox через библиотеку NVIDIA cuRAND, и из одного числа-зерна (seed) он всякий раз выдаёт одну и ту же последовательность. Работу делят между потоками GPU, по 2 048 на каждый мультипроцессор (SM), и от числа SM зависит, какое число в какую позицию матрицы попадёт. У Hopper (H100, H800, H200) таких блоков 132, у B200 и B300 - 148, у GB200 и GB300 - 152. Обучение перезаписывает почти всё, но в каждой большой модели остаются строки весов, которые оно по сути не тронуло. По ним и ищут пару «зерно плюс раскладка».
Депью перебрал больше 6 триллионов таких комбинаций. Случайное совпадение при таком переборе, по расчёту отчёта, дотянуло бы примерно до 8 сигм, а самые сильные доказательства по шести моделям дают от 49 до 1 385 сигм; самый слабый отдельный тест - 20. Для двух моделей совпадение проверили на живом железе. B300 на немодифицированном PyTorch воспроизвёл стартовые строки DeepSeek-V4-Flash, H100 не воспроизвёл ни одной, а сдвиг зерна на единицу ломал совпадение. Арендованный GB200, по посту Депью, повторил стартовые веса Kimi K3 с корреляцией 0,999995.
DeepSeek взяла одно и то же зерно, 953049583, и для DeepSeek-V3, и для V4-Flash: первая модель сходится с раскладкой Hopper, вторая с Blackwell.
Кто и когда перешёл
DeepSeek читается как Hopper до DeepSeek-V3 (декабрь 2024 года) и как Blackwell начиная с V4 (апрель): V4-Flash совпадает с B200 или B300, V4-Pro с GB200 или GB300. У Moonshot переход лежит между Kimi K2.5 (январь) и Kimi K3 (июль). Kimi K2.7-Code, выложенная за шесть недель до K3, собрана на весах эпохи Hopper, но небольшая её часть совпадает с B200 или B300. Kimi K3.1-Pro начинается с того же зерна, что K3, и может быть её чекпойнтом с дообучением. MiniMax перешла между M2.7 (апрель) и M3 (июнь), Ant Group между Ling-3.0-flash (август) и Ling-3.1-flash (октябрь). Четыре модели из шести, включая Kimi K3 и DeepSeek-V4-Pro, совпадают с Grace Blackwell: это GB200 и GB300 из флагманских стоечных систем NVIDIA с жидкостным охлаждением.
Перешли не все. Новейшие модели Alibaba (Qwen), Zhipu (GLM), Tencent, Xiaomi и StepFun читаются как Hopper, а в весах LongCat-2.0 от Meituan, которую, по словам компании, обучали на «AI ASIC superpods», отпечатка NVIDIA не нашлось. Отпечаток Hopper при этом не отличает H800 от H100 SXM или H200, так что H800 в таблице отчёта взяты из заявлений самих лабораторий.
Метод сверяли с 24 моделями, для которых разработчики сами назвали железо, и он везде совпал с их заявлениями; Nemotron-3 Ultra от NVIDIA, в техотчёте которой для одной из фаз обучения назван GB200, читается как 152 SM, как и Kimi K3. Но в приложении отчёта оговорено, что 11 из этих моделей - чекпойнты нулевого шага, а родственные модели не независимы, поэтому это проверка согласованности, а не измеренная точность.
Оговорка про AMD
Единственная альтернатива, которую нашли авторы, - AMD MI300X, тоже закрытый для экспорта в Китай. Если ограничить его 148 или 152 вычислительными блоками, он воспроизводит раскладки Blackwell, так что одной раскладки для вывода мало. Для DeepSeek-V4-Flash AMD исключили отдельным тестом на физическом MI300X: в 377 значениях, где результаты двух вендоров расходятся, опубликованные веса совпадают с NVIDIA в 363 случаях и с AMD ни в одном. Для остальных пяти моделей авторы считают вариант с AMD очень маловероятным.
Вопрос, где работали чипы, отчёт оставляет открытым. Израильская компания Lava, как сообщает The Register, ранее нашла 32 GPU B300 через открытые эндпоинты мониторинга с IP-адресами, геолокированными в Китай. А 12 ноября The Information сообщила, что компании, связанные с Элис Хуан (Alice Huang), вложились в DeepSeek и пообещали ей чипы Nvidia; днём раньше сенаторы Элизабет Уоррен и Крис Кунс призвали администрацию Трампа сохранить экспортные записи Nvidia.
Сколько железа ушло на обучение
По нынешней редакции отчёта, два крупнейших прогона, Kimi K3 и DeepSeek-V4-Pro, заняли около 4 500 и 3 000 Blackwell (примерно 11 500 и 7 500 в пересчёте на H100) примерно на 70 дней каждый, а пять прогонов вместе - около 12 000 GPU при вилке 7 000-22 000. Kimi K3.1-Pro в этот счёт не входит. Цену около 70 000 долларов за GPU авторы вывели из сообщения WSJ о том, что около 36 000 Blackwell, которые ставят в Малайзии для ByteDance, обойдутся дороже 2,5 миллиарда долларов. Отсюда 200-300 миллионов долларов за крупнейший кластер и больше полумиллиарда за пять, причём только за финальные прогоны.
Авторы прямо пишут, что в этих цифрах не уверены. Загрузка GPU (около 20% пика, для DeepSeek 25%), число токенов и длительность прогонов взяты из допущений, а сокращение срока вдвое удваивает число GPU. Если считать по темпу Microsoft, которая обучила MAI-Base-2 на 16 000 GPU за 38 дней, двум крупнейшим прогонам понадобилось бы 8 000-9 000 Blackwell.
В посте Депью фигурируют 2 000-3 000 GPU на крупнейший прогон и 150-200 миллионов долларов за кластер, но это первая редакция отчёта. В Wayback Machine мы нашли три версии оценки в снимках между 21:56 UTC 12 ноября и 04:57 UTC 13 ноября: сумма шла от 150-200 миллионов через «около 200 миллионов» к нынешним 200-300, а Kimi K3 от 2 000-3 000 GPU через 3 400 к 4 500. Из первой версии пропала сверка: та же арифметика для DeepSeek-V3 давала 2 000-2 500 чипов при раскрытых самой DeepSeek 2 048. Разделы с опознанием чипов в нашем сравнении не менялись, а оценка масштаба за эти семь часов успела сдвинуться дважды. По нашему пересчёту, 4 500 GPU для Kimi K3 по 70 000 долларов дают около 315 миллионов, чуть выше верхней границы вилки самого отчёта, а лучшие оценки пяти прогонов вместе - около 840 миллионов при формулировке «больше полумиллиарда», которая не менялась с первой версии.
Авторский разбор
Что мы проверили
15 ноября мы запустили CPU-проверку из репозитория автора (коммит b633870c, numpy 2.2.6), сами скачали 1 025 строк embed.weight из репозитория deepseek-ai/DeepSeek-V4-Flash и сверили их со своей реализацией Philox, а также прочитали код инициализации в PyTorch.
Опознание подтвердилось: проверка Депью открыта, идёт без GPU, и все модели в ней выбирают то число SM, что указано в отчёте, а на байтах из репозитория DeepSeek V4-Flash сходится только с раскладкой B200/B300. Формулу «бит в бит» мы подтвердить не смогли: на CPU совпало большинство значений, но целых строк заметно меньше, чем у автора на B300. Проверить опознание может любой, у кого есть веса, без аренды Blackwell.
| Модель | Зерно | SM | Строки | Медианная r |
|---|---|---|---|---|
| DeepSeek-V3-Base | 953049583 | 132 | 8/8 | 0,999999 |
| DeepSeek-V4-Flash | 953049583 | 148 | 461/469 | 0,999999 |
| Kimi-K3 | 20256586 | 152 | 13/13 | 0,999996 |
| MiniMax-M3 | 2760 | 148 | 17/17 | 0,999990 |
| Ling-3.1-flash-base | 3952 | 152 | 384/384 | 0,983436 |
- Контроль с зерном +1 везде даёт корреляцию около нуля. Более слабое совпадение Ling README репозитория объясняет неточной моделью
trunc_normal_; Kimi K3 на CPU даёт 0,999996. - Все 469 строк V4-Flash из списка автора байт в байт совпали с весами DeepSeek; 461 сходится с инициализацией при 148 SM и ни одна при 132, 152 или зерне ±1. Неучтённых нетронутых строк мы не нашли.
- В этих 461 строке на CPU совпали 96,85% значений против 0,09% при 132 или 152 SM, но целиком лишь 157 строк против 445 у автора на B300. Разницу мы объясняем округлением sin/cos/log, это наш вывод, не замер.
- Раскладка 148 SM видна и в обычных обученных строках 50000-50255: общая корреляция +0,026, около 26,6 наивной ошибки, против -0,6, -1,4 и +0,6 для 132 SM, 152 SM и зерна +1. Замер сделан на одном блоке одного тензора.
Если проверять свои веса
В коде PyTorch число потоков равно меньшему из двух чисел: SM, умноженных на блоки на SM, и числа элементов, делённого на 256. Цифра 2 048 при этом берётся из свойства устройства maxThreadsPerMultiProcessor и константой PyTorch не является. В нашей эмуляции раскладки 132 и 148 SM совпадают на первых 270 336 элементах, а 148 и 152 на первых 303 104. Тензор меньше примерно 270 тысяч элементов или первые 66 строк матрицы шириной 4096 не отличат Hopper от Blackwell, а B200/B300 от GB200/GB300 отделяется только с 74-й строки. Порог получен в эмуляции, на GPU мы его не замеряли.
Дальше
Claude Code 2.1.325 вернул запросы в песочнице и чинит zstd
В Claude Code 2.1.325 команды Bash в песочнице по умолчанию снова спрашивают разрешение. Запуск без подтверждений вернёт одна настройка, sandbox.autoAllowBashIfSandboxed, но прописать её придётся самим. Песочница у вас запускает Bash без вопросов или с подтверждением каждой команды?
Читайте также
- Bloomberg: OpenAI поддержит законы об экспорте чипов
- The Information: DeepSeek и Moonshot учились на GPT-6 Astra
- DeepSeek выложила движок своего API, Huawei наравне с Nvidia
- Muse Spark Open от Meta умещается в два Mac Studio
- Surface Laptop Ultra тянет локальные модели, пока в розетке
- Perplexity пустила агента на Windows, но без стоковой Qwen
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.