
GPT-6 научили чаще попадать в кэш промптов
22 сентября OpenAI объявила, что запросы к GPT-6 будут чаще попадать в кэш промптов, а закэшированные входные токены станут дешевле, до 90%. В анонсе OpenAI помимо более высокой доли попаданий перечислены новая диагностика, явные точки кэширования (breakpoints) и настройки, которые снижают задержку и расходы. На сколько выросла доля попаданий, компания не называет.
Newsroom America добавляет к этому списку дашборд кэширования. В действующем руководстве OpenAI для разработчиков он называется Prompt Caching Dashboard и показывает долю попаданий при чтении из кэша. Промахи разбирает соседний инструмент, Prompt Cache Diagnostics. У поддерживаемых моделей кэширование включено по умолчанию.
Механику руководство описывает так. Пока модель обрабатывает входные токены, она вычисляет промежуточные состояния ключей и значений (KV). Для неизменного начала промпта кэш сохраняет именно эти тензоры, а не сами токены. Если следующий запрос начинается с того же префикса и запись в кэше совпадает, модель берёт сохранённое состояние, а новый ввод всё равно обрабатывает.
По руководству, для повторного использования отрендеренный префикс должен совпасть целиком. В закэшированный контекст, как там сказано, попадают инструкции от OpenAI, сообщения разработчика, описания инструментов и история диалога: текст, картинки, документы и поддерживаемое аудио. Если поменять модель, инструменты или параметры parallel_tool_calls, text.format, reasoning.effort, text.verbosity и context_management (сжатие контекста), кэш может перестать срабатывать начиная с первого изменившегося токена.
Точку кэширования руководство определяет как отметку конца префикса, который OpenAI может сохранить и использовать повторно. Первый запрос записывает подходящий префикс в кэш. Следующие ищут самый длинный совпадающий префикс и идут по подходящим точкам от конца к началу, пока не найдут совпадение. В прежней редакции руководства кэш работал автоматически, без правок в коде, для промптов от 1024 токенов, и обещал сократить задержку до 80%.
Цифры по тарифам в руководстве тоже другие. Раньше оно обещало экономию на входных токенах до 90% и никаких дополнительных сборов. Теперь скидка на закэшированный вход указана уже до 95%, и появилась отдельная ставка за запись в кэш. В OpenAI уточняют, что это не надбавка сверху: каждый входной токен оплачивается по одной из трёх ставок, обычной, закэшированной или ставке записи.
Открытая сессия, по руководству, попадания в кэш не гарантирует, хотя повторное использование контекста внутри сессии помогает сохранить общий префикс. Вызовы через Agents API кэшируются так же, как в Responses API.
Дальше
Opus 5.5 возглавил индекс, наговорив 260 млн токенов
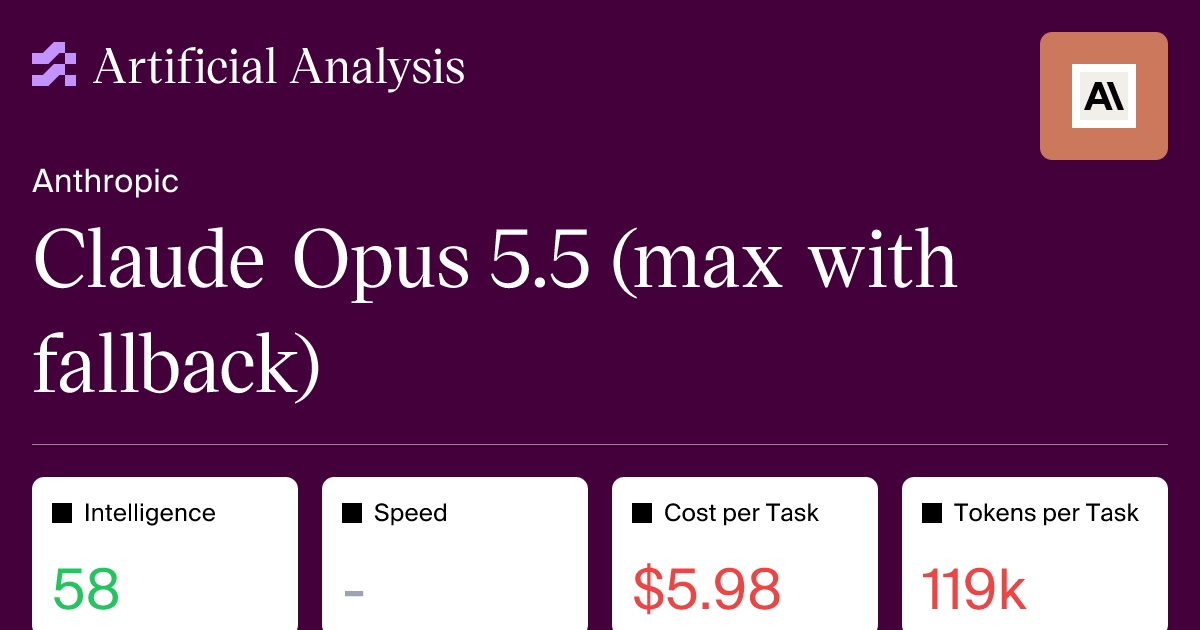
260 миллионов токенов выдал Claude Opus 5.5 на индексе Artificial Analysis при медиане 92 миллиона. Болтливость не помешала взять первое место с 58 баллами, хотя прогон обошёлся в 8708,20 доллара.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.