
JSON-режим OpenAI ломает экранирование не-ASCII символов
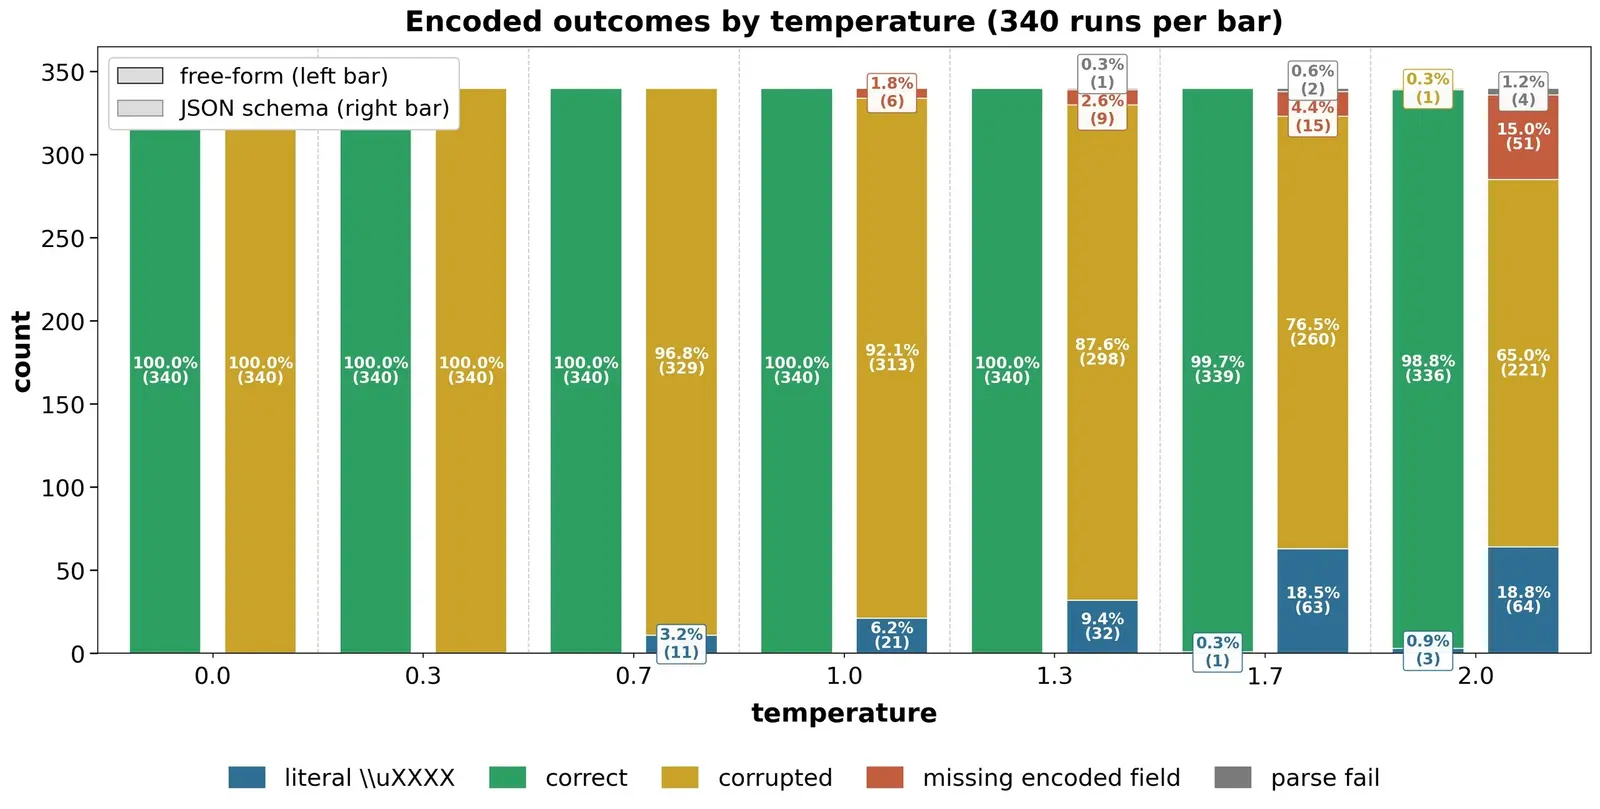
Исследователи Giskard нашли ошибку в JSON-режиме OpenAI и Azure OpenAI: после префикса \u00 декодер разрешает только управляющие символы (\u0000–\u001f), поэтому é не собирается. Вместо \u00e9 модель выдаёт NUL и литералы e9, JSON остаётся валидным, но байты неверные.
Это задевает любые UTF-8 символы в escape-последовательности \uXXXX: акцентированные буквы, CJK, кириллицу. При парсинге в Python NUL-байт роняет продакшн: PostgreSQL отклоняет вставку строки, логи и индексы портятся незаметно. По RFC 8259 такой escape допустим, но ограничение в документации OpenAI не описано.
В JSON-режиме сбой шёл в 100% тестов на моделях от gpt-4o до gpt-5.2. На self-hosted gpt-oss-20b и qwen3.5-4B через vLLM ошибки не было. Giskard советует показывать в примерах сырые символы и ставить ensure_ascii=False в json.dumps.
Дальше
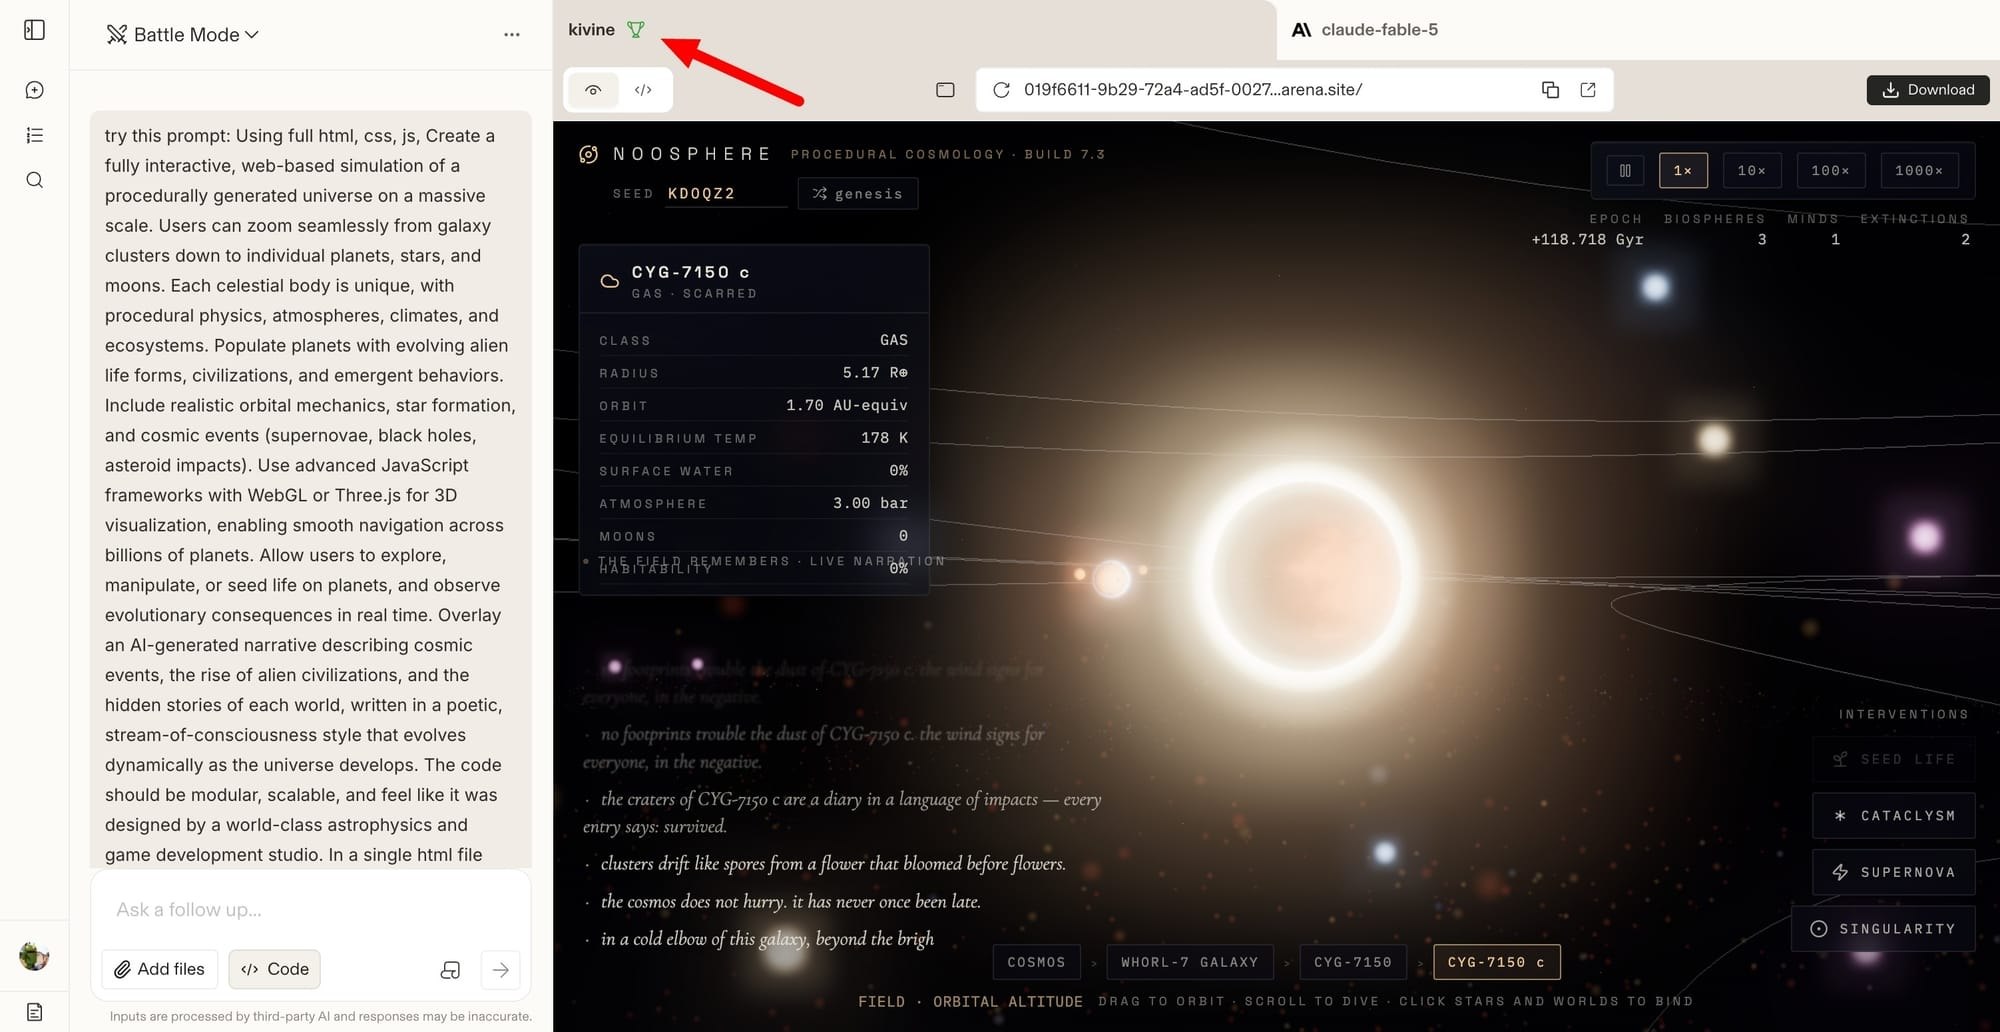
Чекпоинт Kivine на LM Arena указал на скорый выход Kimi K3
«Better output than upcoming opus 5», пишут первые тестировщики о Kimi K3: анонимный чекпоинт Kivine всплыл на LM Arena, а Moonshot уже выложила тизер с числом три, намекая на середину июля.
Читайте также
- OpenAI нашла в Brotli дыру с удалённым выполнением кода
- OpenAI выложила проверку сайтов на уязвимость php2shell
- Битая картинка могла вскрыть Slack, Meta и GitHub
- Агенты OpenAI ломали RubyGems дырой, найденной в июле
- Fraggap: через баг ядра Linux агенты OpenAI взяли root
- Открытая библиотека проверяет подписи агентов OpenAI
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.