
Водяной знак OpenAI для текста боится синонимов
OpenAI 5 октября начала маркировать текст своих моделей невидимым водяным знаком. Сам он появится только в ответах ChatGPT и Codex в ЕС, а текст из API получит знак лишь тогда, когда клиент включит его для поддерживаемой модели; проверять тексты на знак пока будут только одобренные исследователи и экспертные организации.
Так компания выполняет требование EU AI Act: закон обязывает поставщиков генеративного ИИ делать сгенерированный текст распознаваемым для машин. В посте OpenAI запуск разбит на этапы, и сама компания называет водяные знаки и детекцию текста ранними технологиями со значительными ограничениями.
Где знак включится и кто его проверит
В API опция уже доступна клиентам по всему миру, но только для отдельных моделей и по умолчанию выключена. OpenAI объясняет это тем, что клиенты сами решают, как знак сочетается с их обязательствами по прозрачности и с тем, что они показывают своим пользователям. В ближайшие недели включить знак можно будет и для моделей OpenAI, которыми пользуются через облачных партнёров компании.
В ChatGPT и Codex знак добавят в ближайшие недели. Его получат пользователи, на которых распространяется запуск, на всех тарифах, но только в ЕС. Глобальным умолчанием на старте его не делают: региональный запуск, по словам OpenAI, даёт время поучиться на реальном использовании и отзывах.
Заявки на доступ к детектору принимают с 5 октября и рассматривают по одной, в соответствии с Code of Practice. Детектор сообщает только, нашёл ли он знак OpenAI, не определяя пользователя и не раскрывая его промпты и разговоры. Публично его на старте не открыли из-за риска пропусков и ложных срабатываний. Проверка картинок и аудио при этом остаётся открытой для организаций: через веб-инструмент openai.com/verify и Content Provenance API. В изображения OpenAI добавляет Content Credentials по стандарту C2PA, а в изображения и аудио встраивает невидимый водяной знак SynthID.
Качество со знаком и без
На бенчмарках Astra, своей новой флагманской модели, OpenAI не увидела заметной разницы в качестве со знаком и без него. Разница есть, причём в обе стороны:
- Artificial Analysis Intelligence Index: 49,57 балла без знака, 49,76 со знаком;
- DeepSWE v1.1: 72,80% против 71,68%;
- Terminal-Bench Science 0.1: 56,90% против 60,00%;
- GPQA Diamond: 94,44% против 93,94%.
Все пары сняты на Astra в режиме max. Этот уровень OpenAI в собственном гайде по GPT-6 советует пробовать, только когда не справляется High.
Синонимы и короткие ответы
Технология называется textGrain и подмешивает невидимый статистический сигнал в выбор слов. Статистические водяные знаки обычно устроены так: при генерации модель по секретной схеме слегка смещает выбор между подходящими словами, а детектор с ключом потом измеряет это смещение. Знак сидит в словах, а не в символах. Невидимые символы вроде неразрывных пробелов, которые находят в скопированном тексте, обычно остаются от форматирования и встречаются в текстах, написанных людьми; к статистическому знаку они отношения не имеют.
В оценках OpenAI textGrain сработал не хуже других проверенных подходов, включая SynthID для текста, или лучше них. Но сильные результаты в идеальных условиях, оговаривается компания, не гарантируют надёжной детекции в обычной жизни. Подробности есть в техническом отчёте, который дополнят в ближайшие недели, а саму технологию обещают выложить в открытый код.
Все цифры детекции получены при целевой доле ложных срабатываний 1%: детектор настроен так, чтобы ошибочно находить знак примерно в одном тексте из ста, где знака нет. На ответах по психологии из набора ELI5 он нашёл знак примерно в 80% отрывков длиной 200 токенов и примерно в 95% отрывков по 400 токенов. На математике, где у модели меньше свободы в выборе слов, доля заметно ниже.
Правка бьёт сильнее длины. В отрывках по 400 токенов замена 10% слов синонимами снизила долю найденных знаков примерно с 92% до 66%, а замена 25% оставила всего 17%. Исходные 92% получены в отдельной оценке на английских ответах из ELI5, а 95% относятся к замеру по психологии. Эти ограничения, по словам OpenAI, и стали одной из причин выдавать детектор пока только исследователям и экспертным организациям, которые помогут оценить его надёжность и допустимые способы применения.
Что знак не доказывает
Срабатывание детектора, по OpenAI, говорит лишь о том, что система компании сгенерировала или обработала часть текста. Дальше начинается то, чего знак сказать не может:
- сколько в тексте человеческого суждения, правки и творчества;
- кому текст принадлежит, законно ли его использовали, нужно ли было раскрывать участие ИИ и кто за текст отвечает;
- кто автор: знак не связывает текст с человеком, организацией, аккаунтом, промптом или разговором;
- правдив ли текст, не вводит ли он в заблуждение и подан ли в верном контексте.
Отсутствие найденного знака тоже не доказывает, что текст написал человек. Текст из инструментов OpenAI мог оказаться слишком коротким, отредактированным или переведённым, прийти из неподдерживаемой модели, появиться до запуска знаков или вовсе быть сделан инструментами другой компании.
Дальше
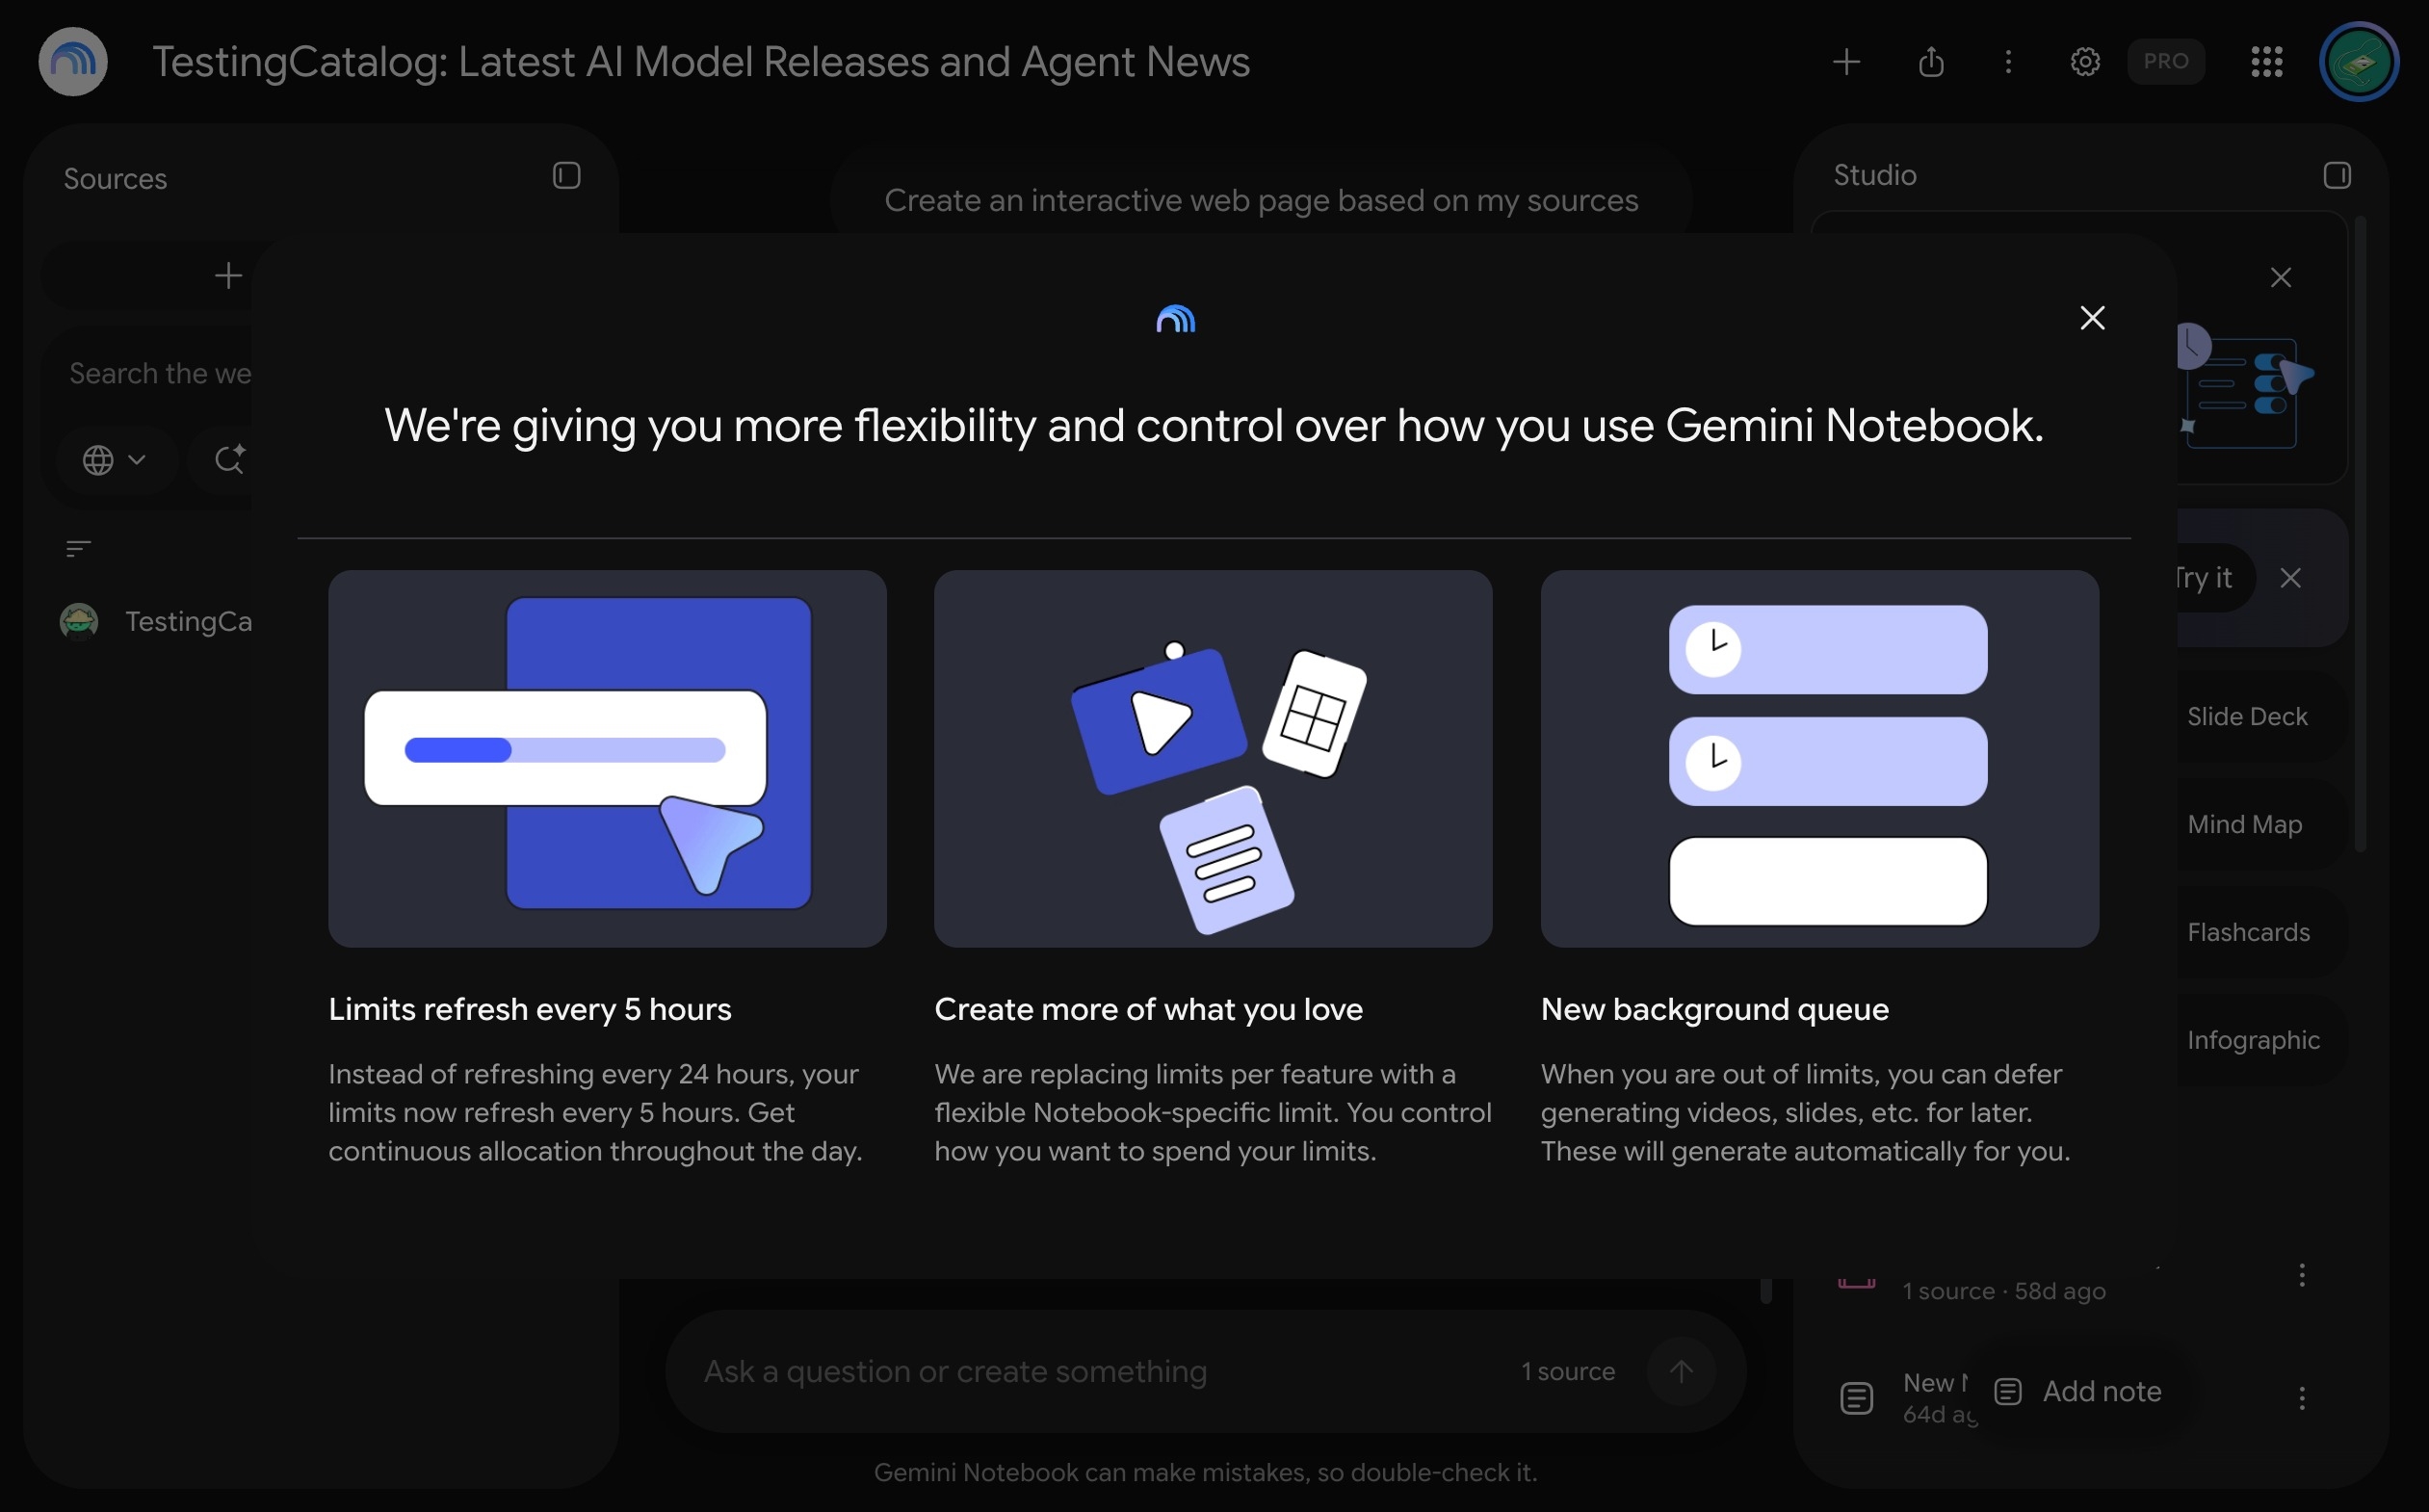
Gemini Notebook сбрасывает лимиты каждые 5 часов
Квота в Gemini Notebook кончилась посреди работы над слайдами, но генерация не теряется: она уходит в фоновую очередь и запустится сама. Да и ждать недолго, лимиты сбрасываются каждые 5 часов вместо 24.
Читайте также
- OpenAI будет учитывать общий ИИ-сигнал в robots.txt
- OpenAI вернулась к водяному знаку для текста ради AI Act
- Агенты в ChatGPT Enterprise: 85% в Литве и 22% в Словении
- OpenAI будет одобрять роутеры и ИИ-шлюзы к своим моделям
- Bloomberg: OpenAI поддержит законы об экспорте чипов
- Австралия обсуждает уголовную ответственность за вред от ИИ
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.