
OpenAI проверила, помогут ли модели искать лекарства
OpenAI представила MedChemBench, тест на то, насколько хорошо модели рассуждают как химики, которые ищут новые лекарства. В нём 99 задач из опубликованных исследований. Модель получает молекулы и результаты прошлых опытов, а должна объяснить данные, сравнить соединения и предсказать их свойства. По данным блога OpenAI, лучше всех справилась новая GPT-6.2 Astra: 84,5% возможных баллов на уровне рассуждений xhigh. Собирать молекулы по рисункам лучшие модели уже умеют почти без ошибок, а выбирать соединения и предсказывать их свойства пока нет.
Мы прочитали препринт, на котором построен тест, и разобрали данные графиков со страницы OpenAI. Из них видно, где модели действительно отличаются друг от друга, а где нет.
Что проверяет тест
Главная трудность медицинской химии в компромиссах. Если улучшить одно свойство молекулы, может испортиться другое: соединение сильно действует на белок, связанный с болезнью, но плохо всасывается или слишком быстро распадается в организме. Химики делают серию похожих соединений, проверяют их и решают, что пробовать дальше.
Одна из задач взята из работ о PRMT5, белке, который изучают при поиске лекарств от рака. Модель видит три родственных соединения и результаты ранних опытов. Она должна предсказать, насколько сильно каждое блокирует белок в клетках, насколько легко проходит через клеточный барьер и как быстро его разрушают ферменты печени. Скрытые от модели более поздние опыты показали компромисс: соединение 23 действовало сильнее, а соединение 24 лучше проходило барьер и медленнее распадалось.
Но прежде чем рассуждать о свойствах, модель должна правильно понять, о какой молекуле речь. В одной задаче её нужно собрать из центральной части и двух групп, сохранив кольцо из 18 атомов. GPT-6 Astra сделала это верно во всех десяти попытках. GPT-5.6 Sol ошиблась все десять раз и в показанном ответе собрала кольцо из 15 атомов, а GPT-5.6 Luna разорвала молекулу на два куска. С такой ошибкой модель дальше анализирует уже другое вещество.
Результаты
На уровне xhigh, когда модель долго думает над ответом, GPT-6.2 Astra набрала 84,5%, GPT-6 Astra 83,3%, GPT-6.1 Sol 82,0%, а GPT-5.6 Sol 58,2%. Чем дольше модели рассуждают, тем выше балл, но большие различия между ними остаются.
Отдельно OpenAI показывает четыре части теста: сборку молекул, объяснение данных, выбор соединений и предсказание чисел. GPT-6 Astra получила 95,4% баллов за сборку молекул, но лишь около половины за выбор соединений и предсказания. Компания оговаривается, что эти части оцениваются по-разному, но видит здесь большой запас для улучшения.
Чего тест не показывает
Сама OpenAI пишет, что результаты не доказывают, будто модели могут открывать новые лекарства или улучшать решения в лаборатории. Задачи взяты из опубликованных работ, и нельзя исключить, что модели видели их при обучении. Каждый ответ был одной попыткой, без инструментов, подсказок и новых опытов. Методика с правилами оценки описана в препринте, а сам набор задач, насколько мы смогли проверить, не выложен: ни в препринте, ни на странице блога об этом ничего нет.
Авторский разбор
Что мы проверили
21 ноября мы прочитали препринт на 27 страниц, ссылка на который есть в блоге, и сверили его с данными графиков на странице OpenAI.
Цифры 95,4% и «около половины» относятся к GPT-6 Astra, а не к новой модели. Препринт датирован 9 ноября, GPT-6.2 Astra вышла 17 ноября, и в препринте её нет. На странице блога она есть только на общем графике, поэтому как она выбирает соединения и предсказывает свойства, нигде не сказано. Её лучший опубликованный результат 85,6% на максимальном уровне рассуждений, а не 84,5%, как мы написали в короткой заметке: это лучший результат только на xhigh. Её отрыв от GPT-6 Astra зависит от уровня рассуждений, на двух средних уровнях она даже чуть позади, а погрешности двух моделей перекрываются везде. Так что данные не показывают, но и не исключают реальной разницы.
Выбор соединений и предсказание чисел почти не различают модели. У всех одиннадцати моделей из препринта на xhigh баллы за выбор лежат в пределах от 43,58 до 52,78%, за предсказания от 37,69 до 47,02%, а за сборку молекул от 8,74 до 95,37%. Лучший результат в выборе соединений у старой GPT-5.5. По нашей приблизительной оценке, около трёх четвертей разрыва между GPT-6 Astra и GPT-5.6 Sol дала правильная сборка молекул.
В препринте есть и оговорки, которых нет в блоге. Объяснения, а это около 36% всех баллов, оценивает сама GPT-6 Astra. Авторы называют тест «близким к насыщению». А на странице запуска GPT-6 Astra у MedChemBench другие цифры: 49,3% у GPT-6 Astra и 47,4% у GPT-5.6 Sol, против 83,33% и 58,23% в препринте, и ни один документ разницу не объясняет. Там же OpenAI пишет, что модели Claude Fable 5 и 5.1 в тест не включили, потому что они отказываются отвечать на большинство вопросов.
Дальше
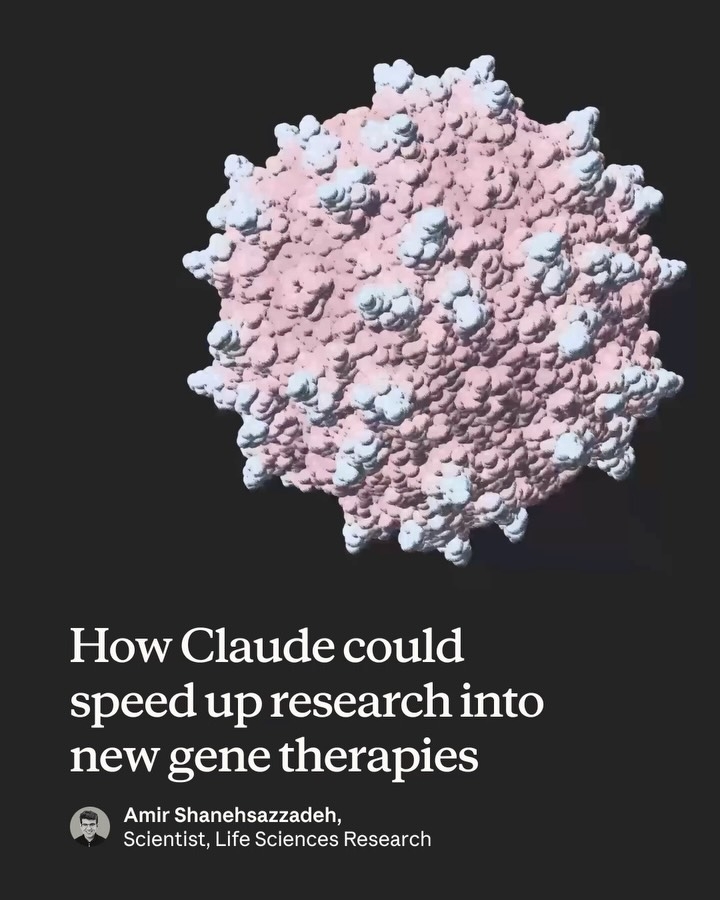
Claude за ночь смоделировал оболочку вируса на одном GPU, Видео
Учёный Anthropic вечером попросил Claude смоделировать целиком оболочку вируса, в которой генная терапия попадает в клетки. К утру способ был готов, и ему хватило одной видеокарты вместо целого кластера. Оставили бы ИИ на ночь с задачей или следите за каждым его шагом?
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.