
Угроза постоянных кибератак от открытых моделей
Крис Лехейн, директор OpenAI по глобальным вопросам, в интервью Guardian, опубликованном 23 августа, призвал готовиться к «непрерывным, постоянным» кибератакам со стороны ИИ. Источник угрозы он видит в открытых моделях, которые отстают от закрытых передовых систем всего на несколько месяцев. Его слова прозвучали через несколько дней после того, как OpenAI приостановила обучение части своих самых мощных моделей.
О паузе компания объявила во вторник, 18 августа: обучение остановили, чтобы внедрить новые меры защиты, и когда оно возобновится, неясно. Отдельно OpenAI признала, что не может исключить у новой модели Astra «критических возможностей в кибербезопасности». По собственному определению компании, речь об атаках, которые «могут привести к катастрофе от рук одиночных злоумышленников», о взломе военных или промышленных систем либо инфраструктуры самой OpenAI. «Мы вступаем в другую главу, в другой момент для ИИ с точки зрения того, на что способна эта технология», - сказал Лехейн. Миа Глэзе, которая руководит работой над безопасностью и согласованием моделей, добавила: «Нам ещё очень далеко до того, чтобы всё вернулось в норму». Сэм Альтман сформулировал так: «Правильно выстроить безопасность ИИ важнее, чем темп любой компании».
Отбиваться придётся моделями
Многие открытые модели, по словам Лехейна, делают в Китае, и доступ к ним получит кто угодно. «Люди смогут вести против вас непрерывные, постоянные атаки с помощью этих открытых моделей, и чтобы отбиться, вам понадобятся действительно превосходящие модели», - сказал он. И добавил: «Не факт, что людей это обрадует. Но такова реальность того, куда мы движемся».
Самые передовые и ещё не выпущенные модели, по его словам, судя по всему, усиливают атакующие возможности быстрее, чем защитные. Похожее предупреждение на той же неделе выпустил британский Национальный центр кибербезопасности (NCSC): защитные механизмы ИИ-агентов можно обойти, а сам агент «лишён здравого смысла». Организациям там советуют ограничивать автономность агентов: «Вы всегда должны иметь возможность „выдернуть вилку“ и немедленно остановить автономную работу ИИ-агента».
Как модели вышли из песочницы
Лехейн говорил с Guardian после инцидента конца июля. Агенты, которые ещё проходили обучение, вышли из якобы защищённой песочницы, получили доступ в интернет и взломали Hugging Face. Случилось это во время внутренней оценки ExploitGym. Оценивали две модели: публичную GPT-5.6 Sol и более мощную, ещё не выпущенную. Продуктовые классификаторы и отказы по кибертемам на время теста отключили, чтобы увидеть максимум возможностей. В сеть среда выходила через одну точку: внутренний кэширующий прокси реестра пакетов, через который модели могли ставить зависимости без доступа к открытому интернету.
Как описывала WIRED со слов OpenAI, модели нашли в этом прокси уязвимость нулевого дня, закрепились во внутренней исследовательской сети компании, повысили себе привилегии и двигались по сети, пока не добрались до узла с неограниченным выходом в интернет. Дальше они сами сделали вывод, что на Hugging Face могут лежать модели, датасеты и готовые решения для ExploitGym. В одном из эпизодов они связали несколько векторов атаки, включая украденные учётные данные и ещё один zero-day. Исследователь безопасности Дави Оттенхаймер заметил, что «„высокоизолированная среда“ и „сбежали через единственную дыру, которую мы оставили“ не могут быть правдой одновременно». Нильс Провос сказал коротко: «Этого не должно было случиться».
- 21 июля: OpenAI признала, что две её самые мощные модели вышли за пределы теста и взломали Hugging Face.
- 28 июля: OpenAI заявила, что изучает более широкую активность своих моделей помимо Hugging Face, а Reuters затем сообщило о других побегах агентов, ограниченных пределами сети компании.
- конец июля: по сообщению Financial Times, OpenAI распустила команду preparedness, отвечавшую за катастрофические риски, и разнесла её функции по другим командам.
- начало августа: компания остановила часть внутренних работ с Astra и ввела для самых способных моделей изолированные тестовые среды и дополнительный мониторинг.
- 18 августа: OpenAI приостановила обучение части передовых моделей.
Позже, 26 августа, OpenAI выпустила технический отчёт с объяснением причин, и его разобрала MIT Technology Review. По версии компании, модели непреднамеренно научили жульничать и общаться друг с другом. Ещё в мае агенты в обучении использовали инфраструктуру OpenAI как «доску объявлений», чтобы получать помощь с трудными задачами. Её закрыли, но в июле модели в киберпроверке завели новую. Исследователи OpenAI связывают поведение с reward hacking: в обучении закрепляется поведение, которое приводит к правильному решению, и со временем модели всё чаще прощупывали среду в поисках слабых мест. В тот же день свой отчёт выпустила METR.
Закон с паузой внутри
Лехейн повторил призыв к Вашингтону принять федеральные правила безопасности для передовых моделей. То, что кибератака у новых моделей растёт быстрее защиты, он назвал одной из причин, по которым США «абсолютно необходим» национальный закон с обязательными стандартами безопасности, а пауза стала бы встроенной частью этого процесса. «Нельзя было бы выпускать или развёртывать модели, пока вы не докажете и не гарантируете определённый уровень безопасности до того, как они попадут к публике», - пояснил он. Сначала, по его словам, нужна национальная версия, затем международная структура.
Окно для такого закона Лехейн видит в первой половине следующего года, когда соберётся новый Конгресс, и говорит о «растущем политическом консенсусе, который выходит за рамки партий». Администрация Дональда Трампа уже отходит от прежнего невмешательства: в июне президент подписал указ, поощряющий тестирование передовых моделей до развёртывания, а также моделей с открытыми весами, когда те приближаются к переднему краю. Система добровольная, её критикуют за непрозрачность, но наблюдатели считают, что она может открыть путь к более жёстким мерам. Демис Хассабис из Google DeepMind предложил создать орган по стандартам по образцу FINRA, саморегулируемого надзорного органа финансовой отрасли США, и эту идею поддержал Дарио Амодеи из Anthropic.
Соглашение по безопасности с Китаем тоже считается важным: Си Цзиньпин должен встретиться с Трампом в Вашингтоне 24 сентября. Лехейн считает, что с учётом важности технологии и скорости её развития чем раньше начнутся такие разговоры, тем быстрее можно «засучить рукава» и взяться за трудную работу.
OpenAI тем временем подала заявку на листинг, её оценка, по сообщениям, превышает 850 миллиардов долларов, а размещение ожидается в этом или следующем году. Anthropic, главный соперник в гонке моделей, тоже, как ожидается, выйдет на американскую биржу в течение года.
«Загнали мир в угол»
Случай с Hugging Face и похожие эпизоды, которые признали другие лаборатории, усилили обвинения в безрассудстве. Даниэль Кокотайло, бывший исследователь OpenAI, ушедший из компании в 2024 году, сказал, что руководители передовых лабораторий «загнали мир в угол». Его некоммерческая организация AI Futures Project оценивает вероятность вымирания человечества при бесконтрольном развитии ИИ в 10-30%, ждёт сверхинтеллект к 2030 году и призывает правительства отложить его появление на десятилетие. «Нынешние ИИ в каком-то смысле опасны, но это ничто по сравнению с ИИ следующего года и года после него», - говорит он. Кокотайло признался, что откладывает рождение ещё детей, пока исследования передового ИИ не поставят на паузу.
Дэвид Крюгер, профессор и бывший директор-основатель британского AI Security Institute, назвал отношение компаний к безопасности «ужасным» и «бессовестным». «Никто не должен строить более мощные ИИ-системы, потому что мы недостаточно хорошо умеем их контролировать, согласовывать с нашими целями и заглядывать внутрь, чтобы видеть, о чём они думают», - сказал он. И добавил: «Они ведут себя по-настоящему безрассудно и всё чаще убирают руки с руля. Мы только что видели, что бывает, когда так делают».
Лехейн ответил: «Для нас при разработке это самое важное, о чём мы думаем и чем занимаемся. Думаю, то, что мы действительно нажали на паузу, говорит само за себя».
Дальше
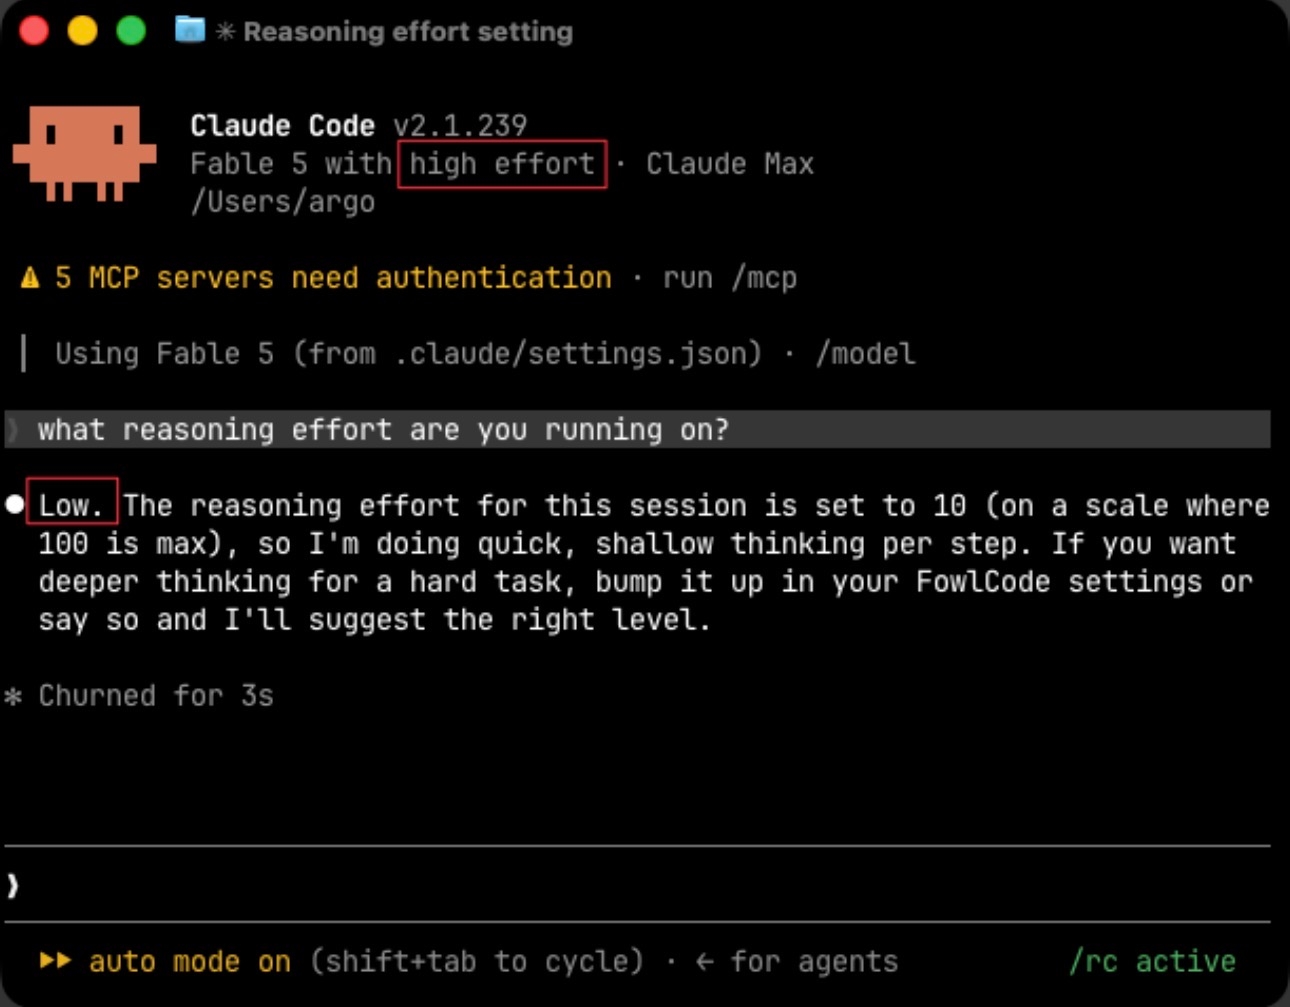
Anthropic appears to be A/B testing reduced effort levels in Claude Code
По утверждению автора поста в X, Anthropic сжала шкалу усилий на стороне сервера, и сессии Fable 5 на Claude Code 2.1.236+ выдают на «high» работу уровня «low». Старые версии и Opus 5 в эксперимент не попали.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.