
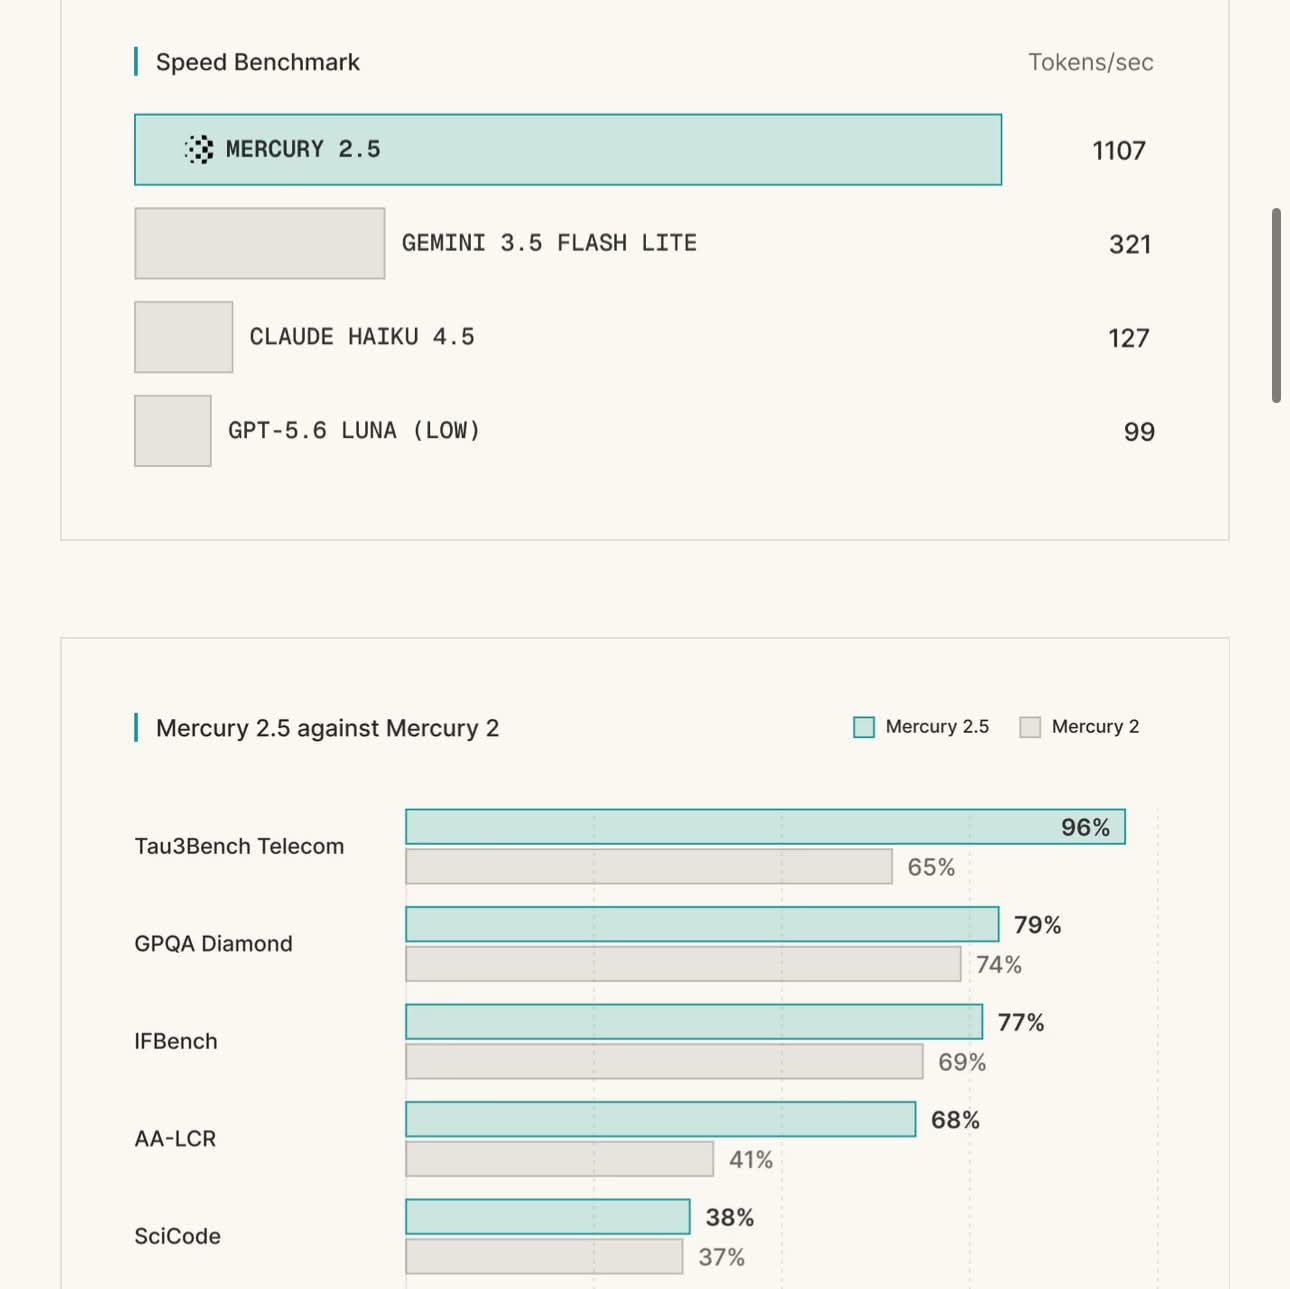
Inception представила Mercury 2.5 и по собственным замерам ставит её вровень с Gemini 3.5 Flash и GPT 5.6 Luna Low, только заметно быстрее. Независимых подтверждений этого сравнения пока не публиковали.
Скорость компания оценивает в 1 107 токенов в секунду на широко доступных GPU NVIDIA, а прирост «интеллекта» относительно Mercury 2 в 40%. Диффузионные языковые модели генерируют и уточняют сразу несколько позиций токенов параллельно, а не выдают текст строго по одному токену. Запуск объявлен 8 сентября 2026 года.