
Диффузионная модель выдаёт 1 107 токенов в секунду
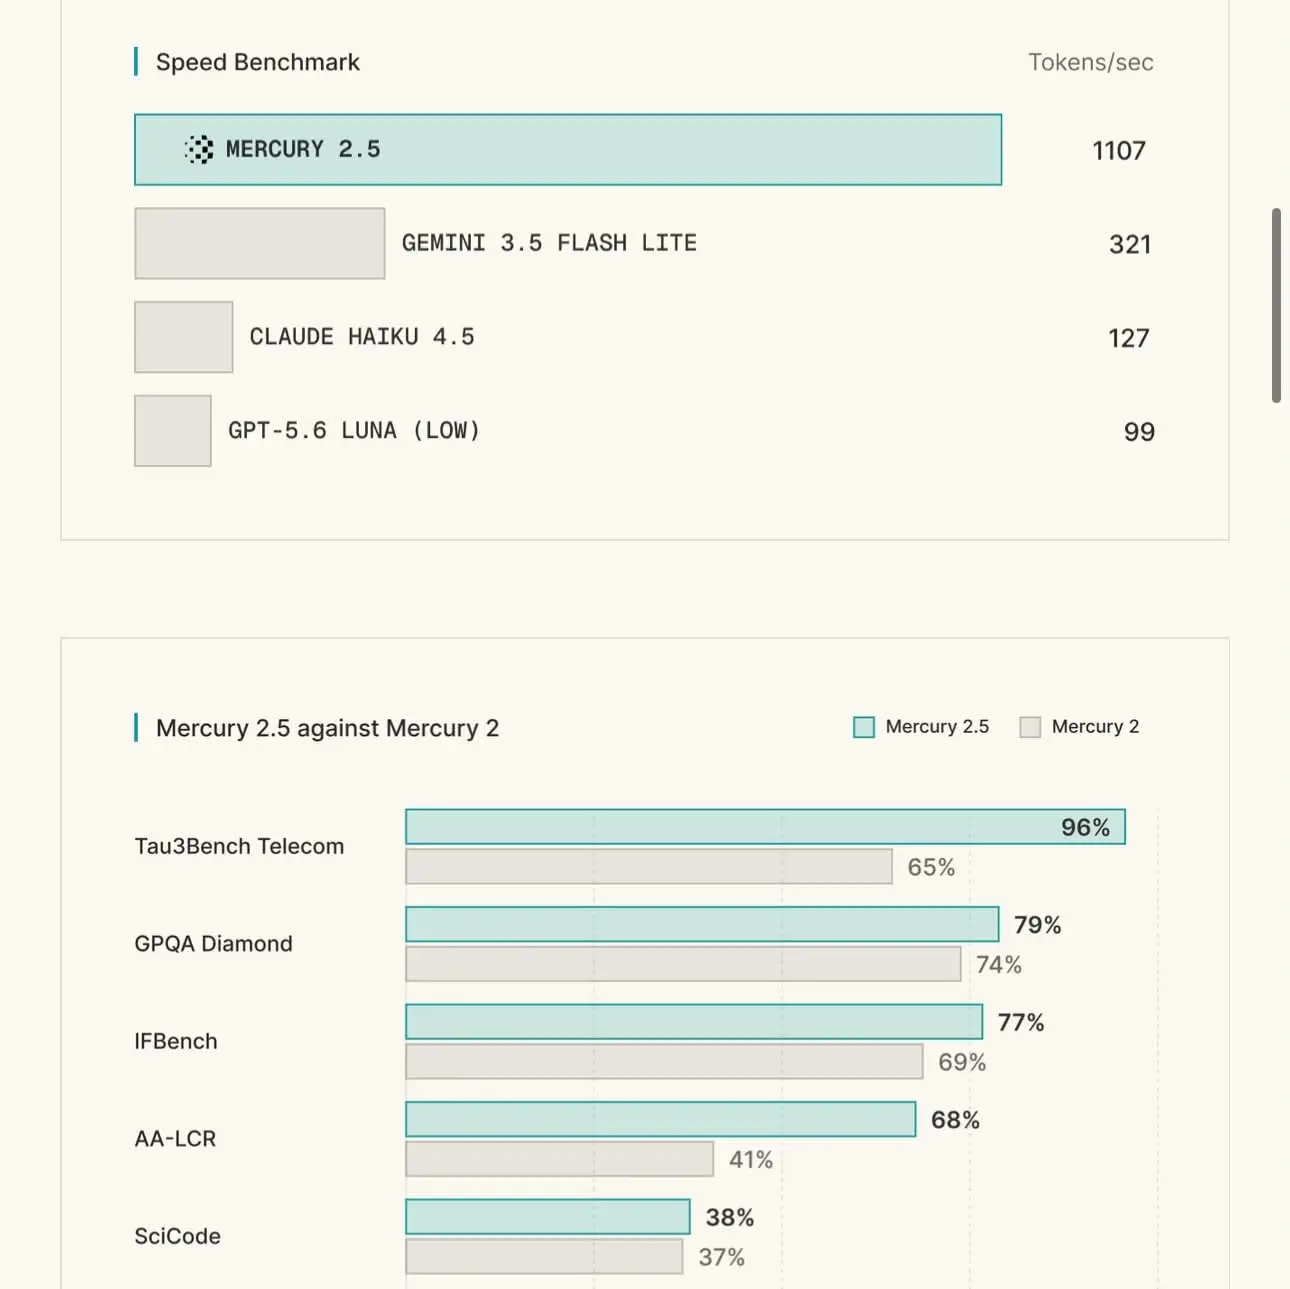
Inception 8 сентября показала диффузионную языковую модель Mercury 2.5. По оценке компании, она работает на уровне Gemini 3.5 Flash и GPT 5.6 Luna Low и при этом заметно быстрее их.
Цифры Inception, которые приводит пост в Threads со ссылкой на блог компании, такие: «интеллект» вырос на 40% по сравнению с Mercury 2, скорость составляет 1 107 токенов в секунду на широко доступных GPU NVIDIA. О Mercury 2 компания в своё время говорила, что та догнала по уровню Claude Haiku и GPT Mini при пропускной способности примерно в 10 раз выше, сообщается в пресс-релизе на Business Wire. В техническом отчёте от 17 июня 2025 года Mercury Coder Mini показывала 1 109 токенов в секунду на H100 по независимым замерам Artificial Analysis.
Скорость объясняется тем, как модель строит ответ. Авторегрессионная модель выдаёт текст по одному токену. Диффузионная генерирует и уточняет сразу несколько позиций токенов: сначала получается грубый зашумлённый набросок, и за несколько шагов он сходится к ответу.
Из этого Inception выводит экономику. У авторегрессии стоимость и задержка растут вместе с глубиной рассуждений, поэтому чем дольше модель думает, тем она медленнее и дороже. Диффузионная модель за один шаг выдаёт много токенов и, как подчёркивают в компании, работает на широко доступных GPU NVIDIA, а не на специализированных чипах.
Дальше
Задачу Навье-Стокса закрыли агенты OpenAI
Группа агентов на следующем поколении модели OpenAI, по её словам «значительно более способной, чем GPT-6 Astra», выдала решение задачи Навье-Стокса с доказательством в Lean. Wired пишет о встречных обвинениях академиков.
Читайте также
- MAI-Base-2 в 4–12 раз экономнее DeepSeek на предобучении
- GPT-6 Astra спроектировала гаджет для Codex без правок людей
- Meituan сравнивает LongCat-2.5 с Opus 5 и GPT-5.6-Sol
- Mistral выложила веса Large 4 на 1 трлн параметров
- Kimi K3.1 Pro встала 8-й в WebDev Arena, K3 была 17-й
- Минорный апдейт DeepSeek обогнал Opus 5 на DeepSWE
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.