
openai
OpenAI проектировала Jalapeno от задержки, а не от флопсов
Promtime
 openai
Посчитайте потолок по памяти: 128 чипов с агрегированной полосой HBM4 в 1 ПБ/с и модель на триллион параметров в FP4 дают около 2000 полных прочтений весов в секунду. Живой пользователь видит 20–200 токенов в секунду, и разбор Siliconcodesign презентации OpenAI на Hot Chips 2026 показывает, что инференс-ускоритель Jalapeno спроектирован вокруг этого разрыва.
Коротко
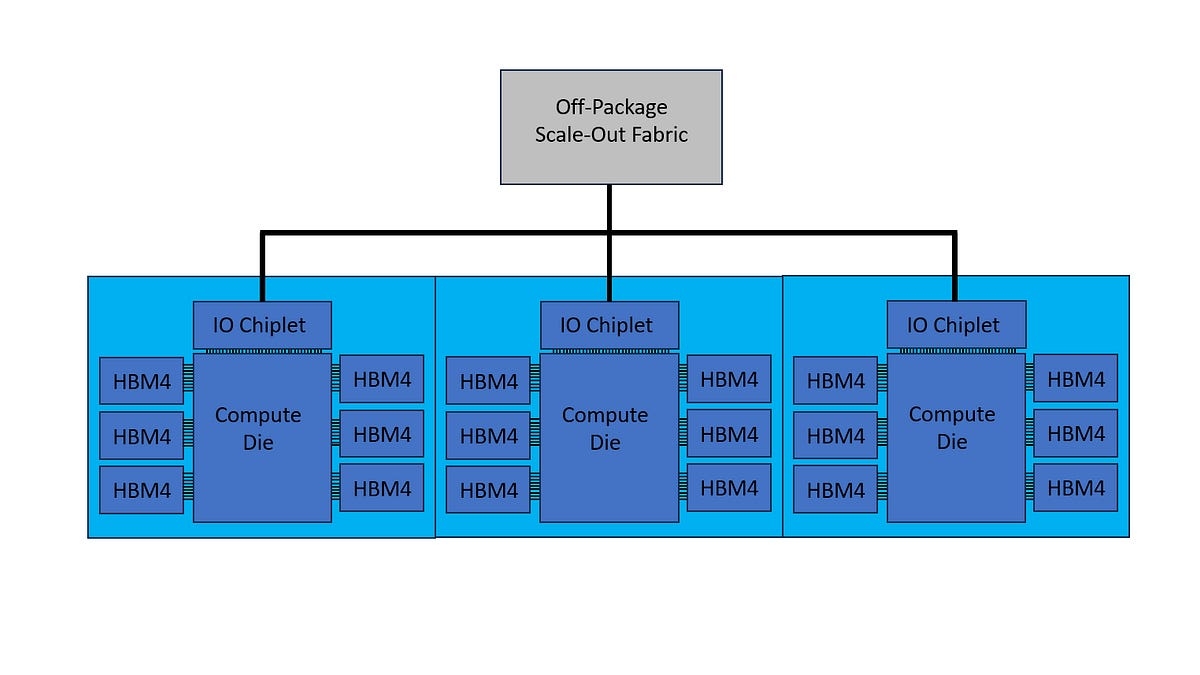
- OpenAI показала на Hot Chips 2026 инференс-ускоритель Jalapeno: TSMC 3 нм, шесть стеков HBM4 по три с каждой стороны, 15,4 ТБ/с, 216 ГиБ памяти и 700 Вт на корпус.
- Сеть собрана на коммутаторах Broadcom Tomahawk 6: один связывает 128 чипов по 800 ГБ/с, восемь связывают 2048 чипов в поде, и любой пакет доходит максимум за два хопа.
- Микроархитектуру делали под multi-token prediction, но кремний пока гоняют на одно-токенном предсказании, а выбранный коммутатор проигрывает по задержке Tomahawk Ultra: 600–700 нс против 250.
Если вы не следили: по таймлайну проекта со слайда, который приводит ServeTheHome, концепт архитектуры начали в конце 2024 года. Futurum пишет, что от начального дизайна до tape-out прошло девять месяцев, тогда как для чипа такого класса быстрым сроком считаются 18–24 месяца. В маршруте проектирования использовали открытый Google XLS: высокоуровневый синтез блоков под площадь, скорость и питание плюс формальная верификация. По данным Futurum, инженерные образцы уже считают в лаборатории на целевых частоте и питании, включая GPT-5.3-Codex-Spark.
Почему отсчёт вели от задержки, а не от пиковых флопсов
OpenAI начала с того, что видит пользователь: время до первого токена на префилле, время на каждый выходной токен на декоде и общее время до последнего токена. От клиентов ChatGPT, API реального времени и внутренних агентских сценариев отсчитали жёсткие SLA по TPOT и сквозной задержке, и только после их выполнения оптимизировали эффективность в запросах на секунду на ватт.
Дальше всё упирается в батчи. Мелкий батч даёт низкую задержку одному пользователю, но память всё равно прокачивает десятки гигабайт весов на каждый проход, и логика простаивает. Крупный батч держит ALU загруженными и экономит энергию, зато добавляет очереди. Разрыв между теоретическим потолком и реальными 20–200 токенами объясняется накладными расходами параллелизма: задержкой межчиповой сети, синхронизацией и конкуренцией в NoC.
Нараянасвами: упущенная выгода дороже предельных издержек
Рави Нараянасвами объяснил логику так: упущенная выгода дороже предельных издержек, потому что фактор сожаления больше. Проще говоря, отсутствующая в кремнии функция обходится дороже, чем заложенная и временно простаивающая. Поэтому в OpenAI предпочли один сбалансированный чип с «тёмным кремнием» набору узких ускорителей под каждую фазу запроса.
Фаз три: префилл грузит вычисления и наполняет KV-кэш, необязательный speculate прогоняет лёгкую черновую модель, декод авторегрессивно тянет веса и KV-кэш из HBM на каждый токен. Соотношение фаз в реальных запросах гуляет, а KV-состояние доходит до сотен гигабайт на запрос, поэтому кэш держат рядом с вычислением, памятью и сетью на одном чипе.
Два хопа на Tomahawk 6 против трёх на fat-tree
Топологией выбрали «полуплоский» Clos с гарантированными двумя хопами. В локальном домене один Tomahawk 6 собирает 128 чипов Jalapeno по 800 ГБ/с (4×200G) и закрывает тензорный параллелизм; в глобальном восемь коммутаторов связывают 2048 чипов под MoE-параллелизм. TH6 стал первым эфернет-коммутатором на 102,4 Тбит/с, до 512 портов 200GbE на одном кристалле. Стойки интегрировала Celestica.
Альтернативы в разборе перечислены с причинами отказа. Двухъярусный fat-tree, как в референсе NVIDIA GB200 SuperPOD, требует трёх хопов и добавляет джиттер хвостовой задержки и потребление. Торы и меши 3D/4D, как в Google TPU 8t, дёшевы для регулярных обменов, но дают высокое среднее число хопов. Dragonfly, как в TPU8i, экономит на оптике, зато глобальные пути неравномерны и требуют адаптивной маршрутизации.
Семь дешёвых проходов вместо восьми дорогих
Спекулятивное декодирование обходит стену памяти: маленькая черновая модель предсказывает несколько следующих токенов, а большая проверяет их одним общим проходом. Это как договаривать фразу за собеседником: угадали, идём дальше; не угадали, он поправляет. В описании NVIDIA сохраняются только токены, принятые целевой моделью, так что выход совпадает с обычным декодом.
Вариантов два. Одно-токенное предсказание тратит восемь проходов на восемь токенов. Multi-token prediction, по описанию презентации в ServeTheHome, делает семь ходов крошечной черновой моделью и один пакетный проход большого «ствола», давая до восьми токенов и сокращая число дорогих проходов до восьми раз. Микроархитектуру Jalapeno строили под MTP, а на кремнии пока обкатывают одно-токенный вариант.
Внутри вместо временного SIMT с планировщиками варпов сделана пространственная схема: независимые слайсы ядер с собственными интерфейсами HBM и локальной L1, соединённые напрямую через коллективы. Писать под неё помогает Gluon, язык ядер OpenAI поверх открытого компилятора Triton с привычными GPU-абстракциями.
700 Вт на чип и 27 EFLOPS на под
Вычислительный кристалл сделан на TSMC 3 нм и стоит рядом с шестью стеками HBM4: 15,4 ТБ/с и 216 ГиБ. Потребление 700 Вт, матричная производительность 3–13 PFLOPS на fp4/fp8. Для сравнения в разборе: B200 даёт 9 PFLOPS на fp4, B300 даёт 15 PFLOPS на fp4, при этом чип NVIDIA потребляет больше 1000 Вт, а Jalapeno умеет только инференс. Под на 2048 чипов занимает 28–32 стойки и даёт 27 EFLOPS, 32 ПБ/с и 432 ТиБ.
Сравнения OpenAI ведёт по InferenceX. По описанию ServeTheHome, это публичный бенчмарк, нормированный по питанию, на наборе открытых моделей от префилла до декода; там Jalapeno идёт на 700 Вт против 1,2 кВт у GB200 и 1,4 кВт у GB300 и MI355X. На GPT-OSS 120B в сопоставимых рабочих точках ServeTheHome приводит около 1,9× по пиковым смешанным токенам в секунду на киловатт.
Там же: примерно в 1,7 раза меньшая сквозная задержка относительно прежнего лучшего времени между токенами. Для демонстрации общности на чипе подняли GPT-OSS, DeepSeek R1 и Kimi K2.5 на триллион параметров; ни одна из моделей под Jalapeno не проектировалась.
Автор разбора на Siliconcodesign считает спорным выбор коммутатора для локального домена: Tomahawk 6 берёт радиксом и полосой, но Tomahawk Ultra даёт фиксированные 250 нс при вдвое меньшей пропускной способности в 51,2 Тбит/с. На наш взгляд, сравнение по флопсам с B200 и B300 здесь говорит мало: Jalapeno инференсный, и содержательнее выглядят нормированные по питанию замеры InferenceX на чужих моделях. По данным ServeTheHome, все три модели подняли уже после возврата кремния A0, то есть запас по программной оптимизации ещё не виден.
Гигаваттные стойки в конце 2026
По данным Futurum, развёртывание гигаваттного масштаба вместе с Microsoft и другими партнёрами должно начаться в конце 2026 года. Когда одно-токенное предсказание сменят на MTP, под который строили микроархитектуру, ни презентация, ни разбор не сообщают; сроков следующей ревизии кремния после A0 там тоже нет. Смотреть стоит на повторяемость цифр InferenceX за пределами лабораторных образцов.
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.
Из Google мы используем только имя и аватар. Почту не сохраняем.