
OpenAI проектировала Jalapeno от задержки, а не от флопсов
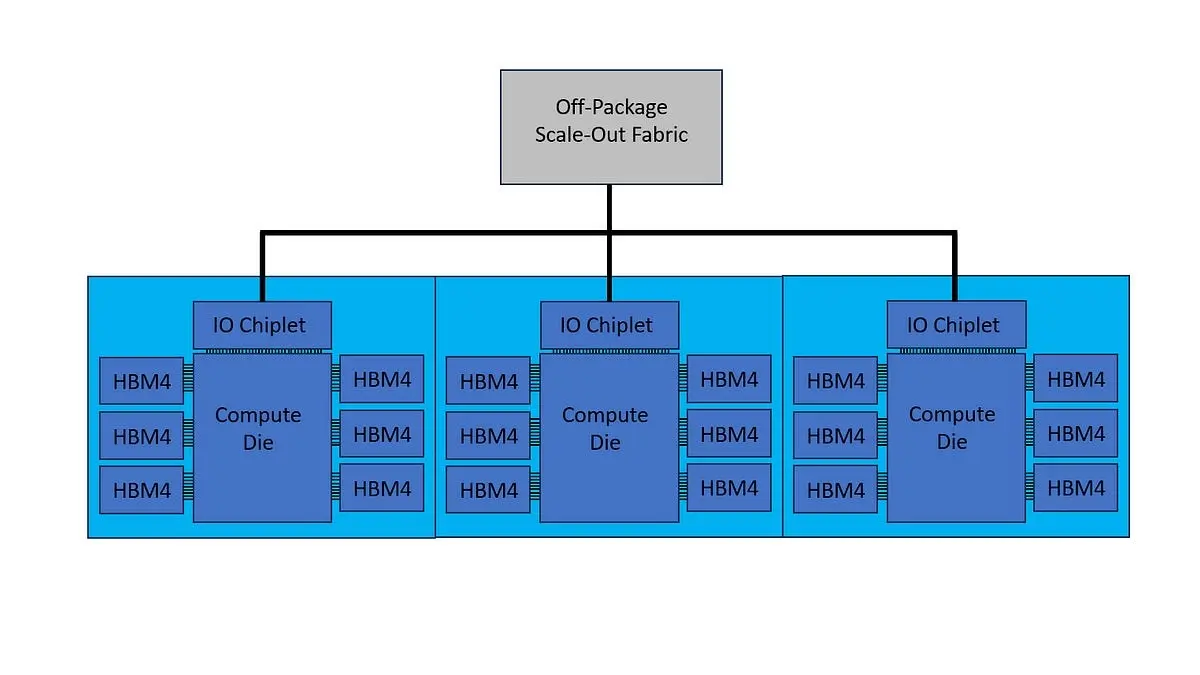
Около 2000 полных чтений весов модели в секунду - такой потолок OpenAI насчитала для модели примерно на триллион параметров в fp4, если бы скорость упиралась только в память HBM. Реальный пользователь получает 20-200 токенов в секунду. Из этого разрыва и выросла архитектура Jalapeno, инференс-ускорителя OpenAI, который Р. Хо, Рави Нараянасвами и К. Лири показали в конце Hot Chips 2026 в докладе «You Can Just Build Things … Chips».
Подробный разбор доклада 12 сентября опубликовал Siliconcodesign. В августе OpenAI говорила о лучших в отрасли скорости и энергоэффективности Jalapeno без единой цифры и без сравнения с конкретными ускорителями. Теперь есть и цифры, и логика, из которой они получились.
Откуда разрыв в сто раз
Расчёт OpenAI исходит из кластера на 128 чипов с суммарной пропускной способностью HBM4 1 ПБ/с и модели примерно на 1 трлн параметров с весами в FP4. Если бы единственным ограничением была скорость чтения памяти, система успевала бы прочитать все веса около 2000 раз в секунду. Спекулятивное декодирование поднимает этот теоретический предел до 5000-10000 токенов в секунду на пользователя.
На практике выходит 20-200. Время съедают накладные расходы параллелизма: задержки в сети между чипами, синхронизация, конкуренция за маршруты в сети внутри кристалла. Между токенами HBM простаивает.
Обычный ответ операторов - поднять размер батча, чтобы память снова работала на полную. Пропускная способность сервера растёт, а запрос отдельного пользователя быстрее не становится: его никак не касается, сколько чужих запросов обработали рядом. Маленький батч даёт низкую задержку, но вычислительные блоки ждут, пока из памяти прокачиваются десятки гигабайт весов на каждый проход. Большой батч держит ALU занятыми, зато добавляет очередь.
Классические вендоры, по словам автора разбора, проектируют ускорители от пиковых «витринных» FLOPS и пропускной способности при неограниченном батче. OpenAI пошла с другого конца. Опыт пользователя она описывает тремя метриками задержки: время до первого токена (TTFT, скорость обработки промпта на префилле), время на каждый следующий токен (TPOT, скорость декодирования) и время до последнего токена, то есть полный оборот запроса. Из требований ChatGPT, API реального времени и внутренних агентных сценариев компания вывела жёсткие SLA на TPOT и сквозную задержку, свои для каждого уровня сервиса. Энергоэффективность в запросах в секунду на ватт оптимизируют уже после того, как SLA выполнен.
Из многих компромиссов проектирования OpenAI оставила два главных: сквозная задержка запроса против смешанной пропускной способности на киловатт и скорость декодирования против той же пропускной способности на киловатт.
Один чип на все фазы
Запрос к LLM проходит префилл, необязательную спекуляцию и декодирование, и нагрузка у них разная. Префилл прогоняет все токены промпта параллельно и заполняет KV-кэш: он упирается в вычисления, греет кристалл и нагружает локальную SRAM. Спекуляция запускает лёгкую черновую модель, которая предсказывает следующие 5-10 токенов, а затем один проход большой модели проверяет их все разом; здесь важна задержка связи между чипами. Декодирование выдаёт ответ по токену и на каждом шаге читает веса и накопленный KV-кэш, так что держится на пропускной способности HBM, а в MoE-моделях ещё и делает нагрузку рваной.
Соотношение фаз от запроса к запросу, по данным доклада, сильно гуляет. Можно сделать по специализированному чипу на каждую фазу и сцепить их, но тогда часть ускорителей будет простаивать. Можно уложить всё в один сбалансированный чип и смириться с тем, что какие-то его блоки временами не загружены. В отрасли такие блоки называют тёмным кремнием.
OpenAI выбрала второе. Нараянасвами сформулировал это так: хуже не поддерживать функцию, которая понадобится в будущем, чем держать на кристалле недогруженную. «Альтернативные издержки выше предельных, потому что у них больше фактор сожаления», - сказал он. Платить заранее за блоки, которые пока простаивают, выходит дешевле, чем потом не суметь запустить новую нагрузку.
Отдельный довод касается KV-кэша. Пользователи передают всё более крупные файлы, и на один запрос кэш может занимать десятки и сотни гигабайт. При раздельных чипах его пришлось бы гонять по внешней сети целиком. В Jalapeno KV-кэш держат рядом с вычислениями, памятью и сетью, чтобы перемещение данных распределялось между всеми тремя.
Два хопа через Tomahawk 6
Главная цель OpenAI в сети - хвостовая задержка. Инференс держится на коллективных операциях вроде all-reduce и reduce-scatter, и один опоздавший пакет задерживает всё вычисление, даже если остальные пришли вовремя. Массивы вычислительных элементов работают строго синхронно, поэтому опоздавший операнд останавливает их целиком. Само время распространения сигнала, которое OpenAI называет «аппаратной скоростью света», мало по сравнению с остальными источниками. Задержку добавляют коммутаторы, коррекция ошибок, конфликты за банки памяти; у чтения и записи HBM своя задержка в 30-50 наносекунд.
Сеть построили на коммутаторах Broadcom Tomahawk 6, интеграцию на уровне стоек взяла Celestica. Tomahawk 6 - первый Ethernet-коммутатор на 102,4 Тбит/с, с высоким радиксом (числом портов на одном кристалле): до 512 портов по 200GbE. Сотрудничество здесь давнее: 13 октября 2025 года OpenAI и Broadcom объявили о заказных ускорителях на 10 ГВт, которые проектирует OpenAI, а развёртывать стойки планировали со второй половины 2026 года до конца 2029-го.
Топология - «наполовину сплющенный» Clos, ограниченный двумя хопами. В локальном домене масштабирования один Tomahawk 6 связывает 128 чипов Jalapeno, каждый по четырём линиям 200G; этого хватает для тензорного параллелизма. В глобальном домене восемь коммутаторов связывают 2048 чипов, с предсказуемой задержкой и полосой для MoE-параллелизма. Любые два чипа соединены максимум через два коммутатора.
Автор разбора перечисляет альтернативы, от которых OpenAI, по его версии, отказалась:
- двухуровневое fat-tree, как в эталонных архитектурах NVIDIA GB200 InfiniBand SuperPOD: пакет между стойками проходит три хопа, а это лишний разброс хвостовой задержки и больше энергии;
- прямой 3D/4D-тор, как у Google TPU 8t: дёшев для регулярного обмена вроде тензорного параллелизма, но средний путь длинный и задержка на линках непредсказуема;
- dragonfly, как у TPU8i: экономит на оптических трансиверах, но пути по системе неравные, а разгрузка от заторов требует адаптивной маршрутизации вроде UGAL, которая добавляет пакетам непредсказуемости.
Главную претензию автор предъявляет самому коммутатору. Tomahawk 6 создан для scale-out, где важно сократить число хопов, и из-за своей сложности даёт задержку 600-700 нс. У Tomahawk Ultra фиксированная задержка 250 нс при вдвое меньшей пропускной способности, 51,2 Тбит/с, и для локального домена он, по мнению автора, подошёл бы лучше. Совместно упакованную оптику (CPO) OpenAI не использовала; автор считает, что технология ещё не готова к реальному развёртыванию.
Плитки вместо варпов
GPU работают во временной модели SIMT: планировщики варпов синхронно гоняют тысячи потоков. Jalapeno устроен пространственно. Независимые ядра уложены плитками, у каждого свой интерфейс к HBM, своё представление L1 и собственные тензорные, SIMD- и скалярные блоки, и ни одно не ждёт инструкций от центрального контроллера. Ядра связаны специализированными блоками коллективных операций и передают данные друг другу напрямую.
Программировать такие архитектуры обычно тяжело, поэтому OpenAI сделала собственный язык ядер Gluon. Он построен поверх открытого компилятора Triton, но даёт более тонкий контроль над железом. Код пишут в привычных GPU-абстракциях вроде блоков потоков, не собирая вручную графы пространственного потока данных.
Из двух видов спекулятивного декодирования OpenAI выбрала multi-token prediction: семь проходов по дешёвому графу и один по большой модели вместо восьми полных проходов на восемь токенов при одно-токенном предсказании. Микроархитектуру с нуля строили под MTP ради задержки, энергоэффективности и пропускной способности. Но пока, чтобы обкатать кремний, чип гоняют на одно-токенном предсказании, так что режим, ради которого его рисовали, на железе ещё не включён.
Железо в цифрах
Jalapeno выпускают на 3-нм техпроцессе TSMC. Вычислительный кристалл окружают шесть стеков HBM4, по три с каждой стороны: вместе 15,4 ТБ/с и 216 ГиБ. Чип потребляет 700 Вт и выдаёт 3-13 PFLOPS на матричном умножении в fp4 и fp8. Для сравнения автор разбора приводит NVIDIA: 9 PFLOPS fp4 у B200 и 15 PFLOPS у B300, при потреблении от 1000 Вт, с оговоркой, что Jalapeno рассчитан только на инференс. Большую часть выигрыша он относит на счёт HBM4.
Кластер на 2048 чипов занимает целый ряд дата-центра, примерно 28-32 стойки, и даёт в сумме 27 EFLOPS, 32 ПБ/с и 432 ТиБ памяти. На один чип это около 13 PFLOPS, верхняя граница заявленного диапазона.
Блоки чипа OpenAI оптимизировала с помощью открытого инструмента высокоуровневого синтеза Google XLS, подключив к нему свои фронтирные модели: и для площади, мощности и производительности, и для формальной верификации. Автор разбора считает, что сроки сократил скорее итеративный и межпрофильный характер работы, чем сам XLS. Ещё в октябре 2025 года Грег Брокман говорил, как сообщал CNBC, что модели OpenAI берут уже оптимизированные людьми компоненты, в них вливают вычисления, и «модель выдаёт собственные оптимизации». «Нам удалось добиться огромного сокращения площади», - сказал он.
Дальше
Координатор в Cursor раздаёт задачи тысячам агентов
Cursor завёл в Projects агента-координатора: он планирует и раздаёт работу тысячам агентов, а код сам не пишет. По данным компании, новые пользователи Projects мёржат на 30% больше пулл-реквестов.
Читайте также
- Свои модели вывели чип OpenAI на 88,94% потолка за 40 часов
- Хо из OpenAI: 99,99% точности мало для чипа Jalapeño
- Заказной чип OpenAI обещает быстрый инференс
- GPT-6 Astra спроектировала гаджет для Codex без правок людей
- OpenAI обещает Джорджии снижать нагрузку до 1000 МВт
- Мониторы OpenAI в повторе сработали за 30 часов до взлома
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.