
В тесте Abnormal дообученная kev-4b обошла фронтирные LLM
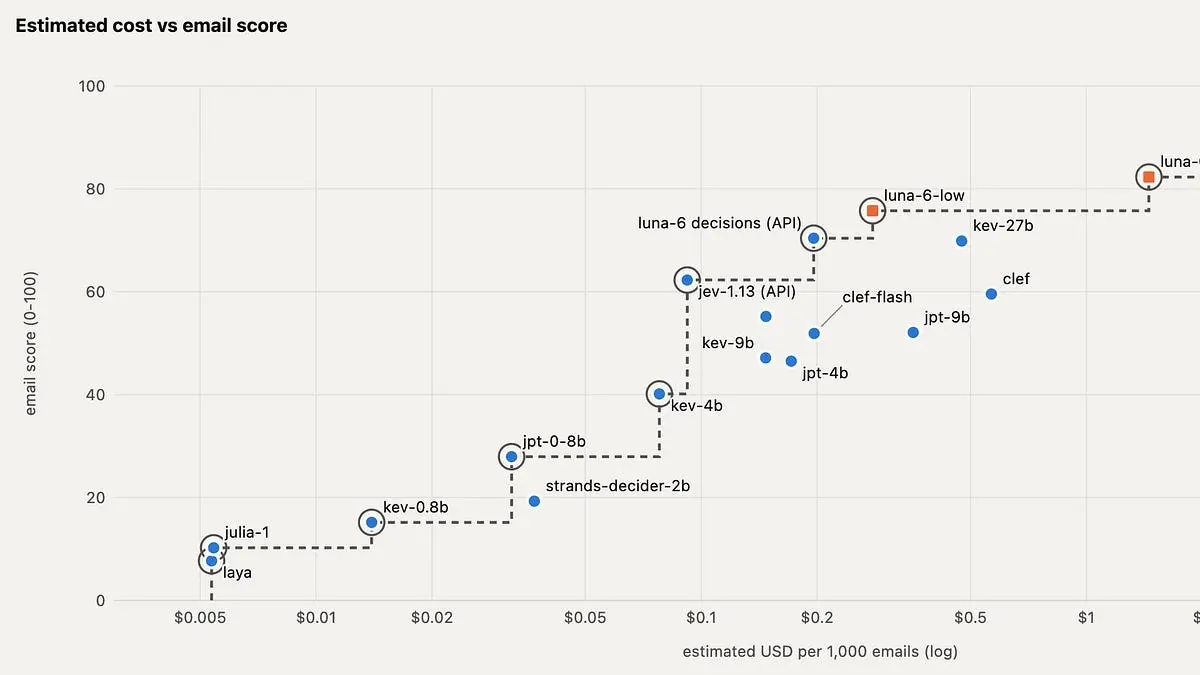
Маленькая открытая модель kev-4b после дообучения примерно за 200 долларов поймала в тесте Abnormal 66% атак при точности 99%, хотя до дообучения ловила 7%. Ни одна из 40 протестированных моделей, включая фронтирные LLM, не показала больше. Правда, авторы сами признают, что доверительные интервалы пересекаются.
Коротко
- Abnormal прогнал через один и тот же набор из 1 985 синтетических писем 40 моделей: Jev от TypeSafe, OpenAI Decisions API, 34 открытые модели решений и четыре конфигурации фронтирных LLM.
- Главная метрика в тесте — доля пойманных атак при точности 99%. По ней выделился OpenAI Decisions API, а Jev оказался лучше всех откалиброван: его вероятности ближе всего к реальной частоте атак.
- Есть и обратная сторона. У дообученной kev-4b macro-F1 по типу атаки упал с 68 до 37, а запуску 4B-модели на каждом письме мешают дефицит GPU и требование обрабатывать почту из ЕС в ЕС.
Если вы не следили: Abnormal сортирует миллиарды писем в неделю и подключается к Microsoft 365 и Google Workspace напрямую через API, без смены MX-записей. Для каждого пользователя, поставщика и пары собеседников система строит поведенческую норму и реагирует на отклонения. Сигнатуры тут мало помогают: BEC-атака, то есть подделка деловой переписки, часто состоит из одного текста, без ссылок и вложений. Опасное письмо удаляется уже после доставки, поэтому ложная тревога уносит из ящика настоящее письмо клиента.
40 моделей отвечали на одни и те же три вопроса о 1 985 письмах
Все письма в наборе полностью синтетические, данных клиентов там нет. Каждое сгенерировано так, чтобы совпадать с реальным трудным случаем из продакшена по классу, типу атаки и сигналам детекции, но идентификаторы оригинала не используются. Атаки составляют 40% набора, намного больше, чем в любом живом ящике. Поэтому высокую точность здесь получить проще, чем в бою.
Модель получает письмо в виде полей, которые извлекает система защиты, включая историю отправителя, совпадения со справочником организации и возраст домена. В одном запросе она отвечает на три вопроса: атака ли это, к какому из четырёх классов относится письмо (атака, спам, graymail, безопасное) и, если это атака, какого она типа: фишинг, BEC, мошенничество, вредонос или разведка.
Для общего рейтинга Abnormal ввёл email score: среднее трёх величин, умноженное на сто. Это macro-F1 по вердикту, macro-F1 по типу атаки и доля пойманных атак при точности 95%. Крупные модели здесь в целом выше, лидируют фронтирные LLM, но каждый шаг вверх стоит намного дороже предыдущего. Jev и OpenAI Decisions API лежат на границе Парето: нет модели, которая была бы и дешевле, и лучше их.
При точности 99% OpenAI Decisions API ловит большую часть того, что ловит luna-6-max
Пригодность модели решает не сводная оценка. Письмо, признанное атакой, Abnormal убирает из ящика, поэтому точность здесь служит жёстким ограничением, а полнота, то есть доля пойманных атак, главным выигрышем. Отсюда рабочая метрика: сколько атак модель ловит при точности 99%.
По этой метрике граница Парето сжимается до нескольких моделей. Большинство участников, включая все открытые модели, которые Abnormal запускал на своём железе, ловят лишь малую долю атак. Jev остаётся на границе только за счёт цены. OpenAI Decisions API находит большую часть того, что ловит luna-6-max, но обходится гораздо дешевле и отвечает гораздо быстрее.
Самым поучительным промахом Abnormal называет luna-6-low. Это та же luna-6, только запрошенная как обычная LLM. По средней точности она не уступает Decisions API, но при 99% точности сильно отстаёт: метрики без порога прячут как раз тот участок кривой, на котором система работает.
Дообучение за 200 долларов подняло kev-4b с 7% до 66%
Для эксперимента Abnormal дообучил kev-4b на смеси почтовых и непочтовых задач классификации. Это одна эпоха LoRA на 60 тысячах примеров (7 500 шагов) на GPU L40S, всего около 200 долларов. LoRA обучает небольшую добавку к весам, а сами веса модели не трогает. Обучающие данные не пересекались с бенчмарком ни письмами, ни форматом задач.
Доля пойманных атак при точности 99% выросла с 7% до 66%. Больше не показала ни одна модель в тесте, сколько бы она ни стоила. Если порог подбирать на отложенных 20% данных, модель держит точность 98,6% при полноте 67,7%. Калибровка тоже подтянулась: kev-4b была одной из худших моделей в тесте, а стала одной из лучших.
При этом macro-F1 по типу атаки упал с 68 до 37: большинство писем с BEC и разведкой модель теперь записывает в мошенничество. Авторы предполагают, что виноват состав обучающей смеси. В ней был четырёхклассовый вердикт, но не было типов атак. Похоже, дообучение заточило модель под знакомый вопрос и испортило ответ на тот, которого она не видела.
Модель решений выдаёт вероятности за один проход и не генерирует текст
Модели решений обычно читают письмо и все вопросы за один прямой проход. Вероятность для каждого варианта они возвращают сразу, не порождая ни одного токена. Поэтому ответ стоит примерно столько же, сколько чтение входа. Похоже на экзаменационный бланк с клеточками вместо сочинения: ответ виден сразу, ждать конца текста не нужно.
Вопросы пишутся обычным языком. Поэтому новый детектор можно запустить без обучения, просто сформулировав вопрос, и не нужно придумывать признак и переобучать под него модель. LLM в тесте получали то же письмо в JSON и по строгой схеме возвращали вероятность для каждого варианта.
Вероятность нужна и сама по себе. Если она выше одного порога, письмо удаляется автоматически, средняя полоса уходит на ручную проверку, остальное доставляется. Схема работает, только если из писем с вероятностью 0,9 атаками действительно оказываются около 90%. Лучше всех откалиброван Jev. Фронтирные LLM оказались в середине даже после прямой просьбы давать честные вероятности. Хуже всех маленькие открытые модели, включая базовую kev-4b.
Сегодня похожая детекция обходится Abnormal примерно в цент за тысячу писем
Обучение и бенчмарк не показывают, что нужно для работы онлайн в масштабе Abnormal. Письма из ЕС нужно обрабатывать в ЕС. Значит, API должен работать в этом регионе, а собственные GPU нужны в каждом регионе присутствия. Графики стоимости исходят из того, что GPU загружены полностью. На деле почта следует рабочему дню, и для пиков нужен запас.
Даже без простоя обслуживание kev-4b выходит дороже, чем на графике, если считать по измеренной пропускной способности и ценам GPU по требованию. При объёмах Abnormal запуск 4B-модели на каждом письме требует столько GPU, что их трудно получить даже с бюджетом. Сейчас похожая детекция в онлайн-стеке стоит около цента за тысячу писем на смеси CPU и GPU-ускорителей. Модели решений снизили цену суждения уровня LLM с долларов до центов за тысячу писем, а время ответа сократили с секунд до миллисекунд.
Главная оговорка спрятана в сносках. Тестовых атак всего 637, поэтому интервалы широкие: 65,5% [49,8; 80,2] у дообученной kev-4b против 49,9% [45,5; 83,2] у sonnet-5.5-max. К тому же точность посчитана так, будто атаки составляют половину почты, и авторы просят читать цифры как относительные. На наш взгляд, после такого провала в типах атак дообученная kev-4b выглядит скорее узким детектором «атака или нет», чем универсальной моделью.
Очередь за haiku-5.5
Пост написан до выхода haiku-5.5, и Abnormal обещает проверить её по той же методике. Когда появятся результаты, не сказано. Правильную архитектуру для своего масштаба компания видит как смесь: дешёвые модели на всей почте, модели решений за префильтрами, фронтирные LLM на немногих письмах, где нужно настоящее рассуждение, и петли обратной связи. Какая модель решений встанет за префильтром, пока неизвестно.
Читайте также
- Decisions API от OpenAI вышел в публичную бету для всех
- OpenAI научила Luna выбирать ответ за 150 миллисекунд
- Jev дешевле Claude Fable в 274 раза, но точность 98%
- Mistral Large 4 обошла GLM-5.3 на DeepSWE, пишет VentureBeat
- OpenAI ускорила GPT-6 и дала API водяные знаки textGrain
- В корпоративный Codex завозят GLM-5.3 Flash и Kimi K3
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.