
open-models
V4.1 Flash: 552 миллиарда параметров и Encoder-Decoder
Promtime
 open-models
DeepSeek опубликовала на Hugging Face модель V4.1 Flash: смесь экспертов на 552 миллиарда параметров с новой структурой Encoder-Decoder. Об этом говорится в публикации в Threads, которая называет V4.1 Flash самой маленькой моделью в новой архитектурной семье DeepSeek и указывает на нативное понимание изображений.
Коротко
- Изображения V4.1 Flash обрабатывает нативно, без отдельной визуальной версии модели, а сама она описана как младшая в новой архитектурной семье DeepSeek, флагман которой, V4-Pro, насчитывает 1,6 триллиона параметров.
- Ограниченная бета модели на 552 миллиарда параметров открылась 8 сентября 2026 года: окно тестирования было рассчитано на два дня, а 10 сентября доступ к тестовой версии отключался автоматически.
- DeepSeek заявляет для V4.1 Flash новый метод предобучения и обучение с подкреплением большего масштаба после него, но количественных характеристик ни для того, ни для другого не приводит.
Публикация модели на 552 миллиарда параметров с нативным зрением меняет расклад для команд, которые собирают мультимодальные пайплайны из отдельных моделей: судя по всему, DeepSeek предлагает младшую модель как рабочую замену такой связке. Смена структуры на Encoder-Decoder выглядит как более серьёзный шаг, чем очередное обновление весов, поскольку затрагивает базовую схему, вокруг которой построена индустрия инференса. Для практиков это означает необходимость перепроверять совместимость инфраструктуры, рассчитанной на decoder-only модели.
V4.1 Flash построена как модель со смесью экспертов на 552 миллиарда параметров и, по описанию DeepSeek, использует новую структуру Encoder-Decoder. В той же семье флагманскую позицию занимает V4-Pro с 1,6 триллиона параметров, то есть разрыв между младшей и старшей моделями почти трёхкратный.
Большинство современных больших языковых моделей строится по схеме decoder-only: один стек трансформера и обрабатывает вход, и порождает ответ. Encoder-Decoder разделяет эти функции между двумя отдельными блоками: кодировщик строит внутреннее представление входных данных, а декодер по этому представлению генерирует выходную последовательность токенов.
Смесь экспертов означает, что при обработке каждого токена активируется лишь часть параметров модели: маршрутизатор выбирает несколько экспертных подсетей, а остальные в вычислении не участвуют. За счёт этого общий размер модели и вычислительная стоимость одного запроса расходятся, но объём памяти под веса определяется полным числом параметров.
В опубликованном анонсе DeepSeek называет два изменения в подготовке V4.1 Flash: новый метод предобучения и обучение с подкреплением большего масштаба на стадии после него. Масштабный пост-тренинг с подкреплением DeepSeek применяла и в линейке R1, где так формировались рассуждающие способности этих моделей.
Нативное понимание изображений заявлено для V4.1 Flash как штатная возможность модели: визуальный вход обрабатывается ею напрямую, отдельная сборка под изображения для этого не требуется. Веса и карточка модели опубликованы в аккаунте deepseek-ai на Hugging Face, где страница DeepSeek-V4.1-Flash открыта публично.
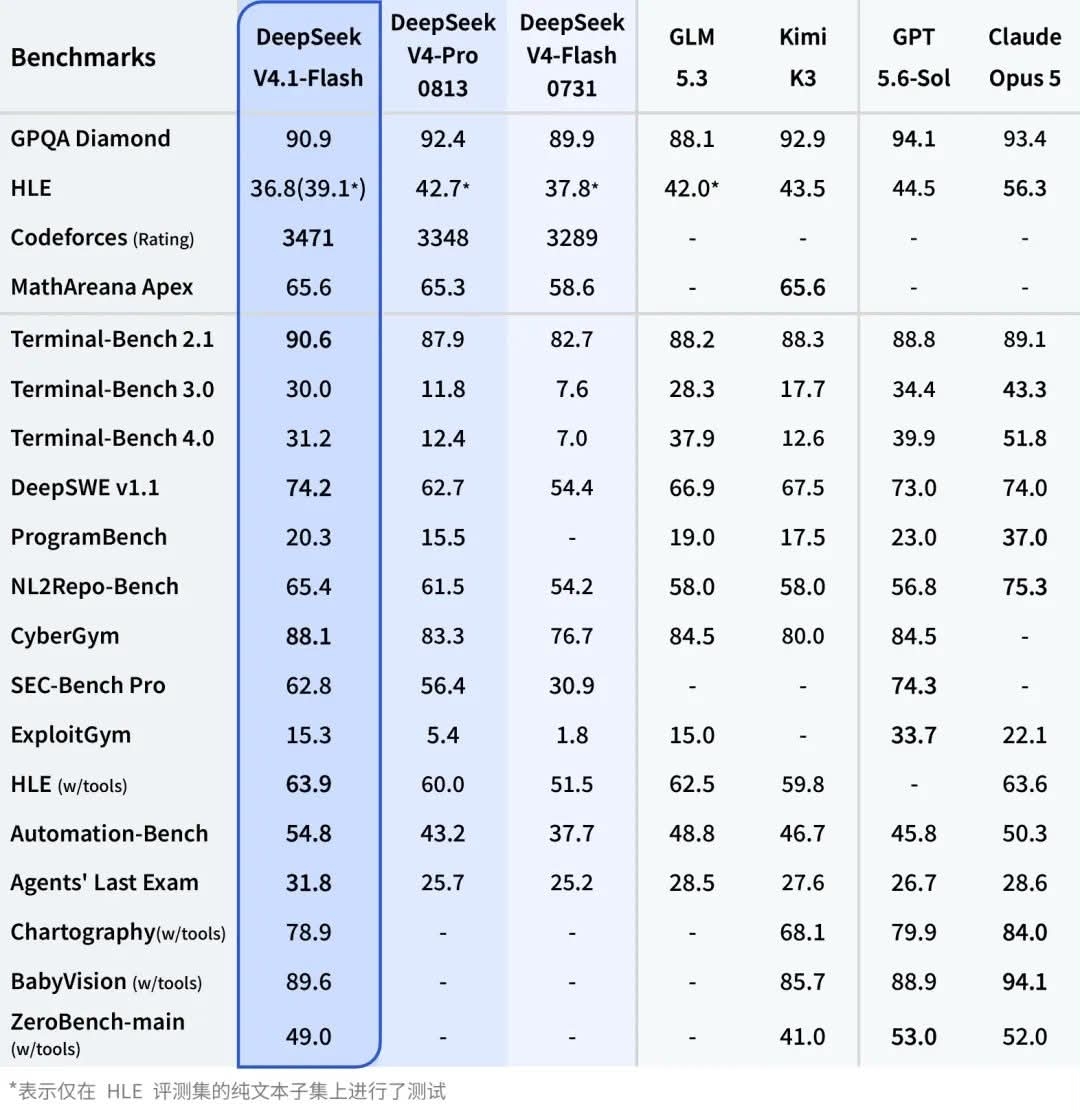
Бенчмарки и лицензия не названы
Результаты бенчмарков, число активных параметров на токен и условия лицензии в анонсе V4.1 Flash не приводятся. Не названы сроки выхода остальных моделей новой архитектурной семьи DeepSeek и условия доступа к V4.1 Flash через API. Открытым остаётся и то, распространяется ли новая структура Encoder-Decoder на старшие модели семейства и повторит ли DeepSeek формат ограниченного по времени тестирования для следующих релизов.
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.
Из Google мы используем только имя и аватар. Почту не сохраняем.