
Четыре модели Claude в связке дали 78% на Terminal-Bench
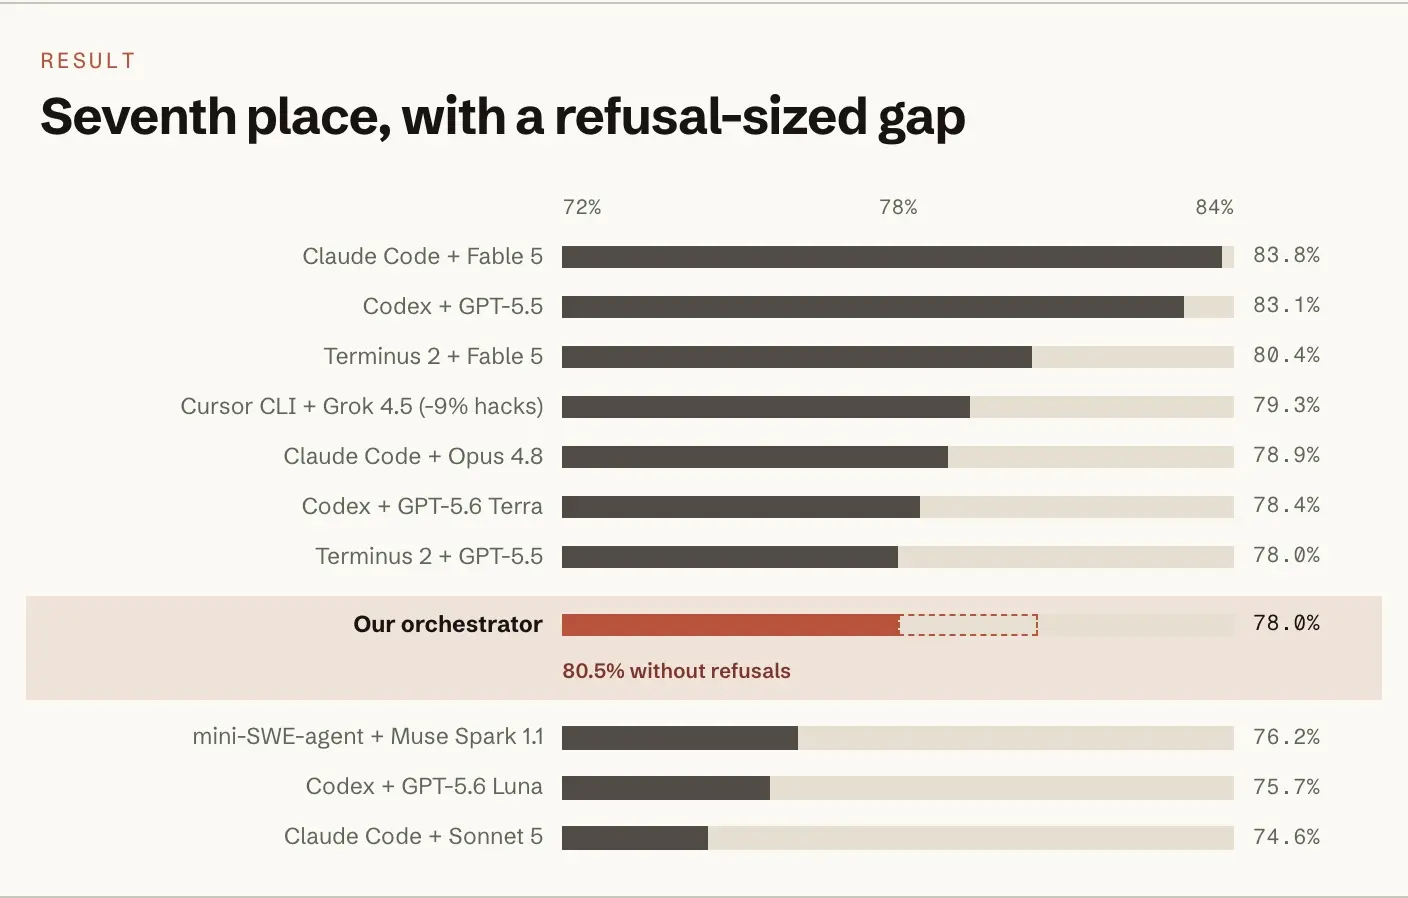
Связка из четырёх моделей Claude решила 78% задач Terminal-Bench 2.1 и заняла седьмое место при счёте $1 178, примерно вдвое дороже первого места. Роли распределены так: Fable 5 планирует и делегирует, Haiku 4.5 ведёт разведку, Opus 5 правит код, Sonnet 5 проверяет работу.
Три задачи по безопасности исполнитель отказался выполнять: ноль решений из 14 делегированных попыток. В контрольном прогоне без делегирования Opus 5 решил те же задачи шесть раз из шести. С зачётом этих задач вышло бы 80,5% и третье место.
С вызовом верификатора задачи решались в 91% случаев, без проверки в 43%. На Opus 5 в роли исполнителя ушло 58% расходов, $689.
Первое место на доске держит Claude Code с Fable 5 и 83,8%.
Дальше
Координация субагентов обходится без токенов модели
На каждое «и затем» в агенте проверьте, читает ли следующий шаг вывод предыдущего. Если нет, шаги можно запускать параллельно. Так разработчик 0xCodez в гайде на X раскладывает динамические workflow Claude Code на граф.
Читайте также
- Тот же результат, вдвое дороже: Claude Code против Codex
- Аудит сессии Claude: 7,5 млн токенов и 4038 вызовов
- Claude Code принёс адоптерам на 24% больше смерженных PR
- Claude Code шлёт 33k токенов до чтения промпта, у OpenCode 7k
- Claude Code на десктопе запускает по сессии на задачу
- Линус Торвальдс правит ядро Linux вместе с Claude Code
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.