
Тот же результат, вдвое дороже: Claude Code против Codex
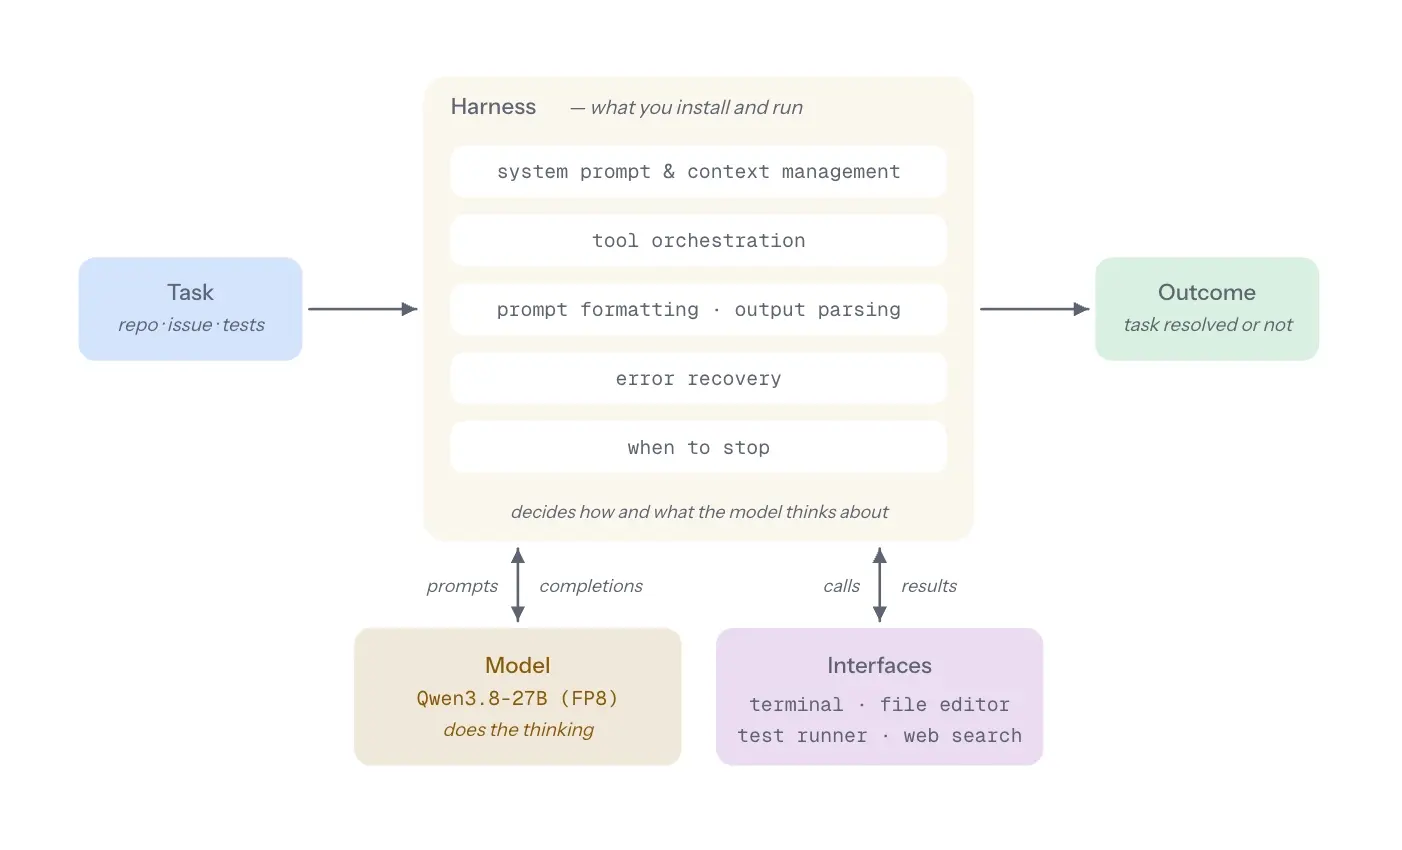
На GLM-5.3-Flash полный прогон 64 задач из SWE-Bench Pro через Codex обошёлся в 22,8 доллара аренды GPU, а через Claude Code и Pi в 45 долларов каждый. Доля решённых задач у всех трёх обвязок при этом почти одинаковая. Результаты команда aistack опубликовала 10 сентября в блоге Imec-int. Разница в цене сводится к тому, сколько токенов обвязка прогоняет через модель и как долго держит GPU.
Обвязка (harness) - то, что вы ставите и запускаете: Claude Code, Codex, Pi. Думает модель, а обвязка решает, о чём именно, какие инструменты ей доступны, как собирается контекст и когда остановиться. В прошлый раз aistack меняла железо при фиксированной обвязке, теперь сделала наоборот. Обе модели взяли в FP8. Qwen3.8-27B работала на одной NVIDIA H200 (4,54 доллара в час на Modal), GLM-5.3-Flash на четырёх (18,16 доллара в час). Обвязки запускали с настройками по умолчанию и без доработок, конфигурация движка инференса у всех трёх была одинаковой. Каждый «разработчик» в стенде представлял собой отдельный воркер обвязки с собственным окружением, ресурсами и доступом в веб. Набор из 64 задач тот же, что в первой статье серии. Его отобрали из SWE-Bench Pro, в котором, по описанию Scale, 1 865 задач из 41 репозитория.
Точность почти не двигается
На Qwen3.8-27B Claude Code решил 33 задачи из 64 (52%), Codex 31 (48%), Pi 28 (44%). На GLM-5.3-Flash Codex дошёл до 33 (52%), Claude Code и Pi до 32 (50%). Весь разброс уместился в 44-52%, а между прогонами разница составила две-три задачи. Авторы советуют не тратить время на бенчмаркинг, если обвязку выбирают только по доле решённых задач, и брать ту, что нравится. Оговорку они делают сами: это касается трёх проверенных обвязок, а у длинного хвоста остальных результат может быть другим.
Поводом для замера стала фраза С. Рашки (S. Raschka) из рассылки Ahead of AI: обвязка, по его словам, «часто оказывается тем, что отличает LLM, которая работает лучше, от той, что работает хуже». Авторы решили проверить, так ли это на самом деле.
Куда уходят токены
Большинство пар «обвязка плюс модель» сгенерировали за прогон 3-4 млн выходных токенов: от 3,33 млн у Codex на Qwen до 3,97 млн у Claude Code на GLM. Исключение одно: Codex на GLM-5.3-Flash уложился примерно в 2,1 млн при той же точности. Входные токены обрабатываются относительно быстро, а генерация выходных занимает заметную часть общего времени. Чем дольше генерация, тем дольше сессия держит слот на GPU и тем меньше задач то же железо решает за час.
По входу разрыв ещё больше. На Qwen3.8-27B Claude Code прогнал через модель около 445,8 млн входных токенов, Codex 330,5 млн, Pi 348,5 млн. Выходит в 1,35 раза больше контекста ради одной лишней решённой задачи. На GLM-5.3-Flash Claude Code отправил 480,2 млн против 192,1 млн у Codex, в два с половиной раза больше, и решил на одну задачу меньше. «Чем больше говоришь, тем умнее не становишься, Claude», - пишут авторы. В июле похожую картину показал другой замер: Claude Code отправлял около 33 тысяч токенов ещё до чтения промпта, OpenCode примерно 7 тысяч.
Больший контекст означает и больший KV-кеш, а значит, больше давления на память GPU. На Qwen3.8-27B при восьми параллельных сессиях Codex занимал в среднем 22,2% пула KV-кеша, Pi 24,6%, Claude Code 32,4%. Пики составили 59,8%, 72,1% и 78,8% соответственно, до 90% пула не дошёл никто. По словам авторов, разница начинает иметь значение, когда вы рассчитываете на более высокую параллельность или пропускную способность.
Почему время превращается в счёт
Арендованные или купленные GPU работают одинаково, рассуждает модель или ждёт выполнения вызова инструмента. Поэтому aistack считает стоимость как время прогона, умноженное на почасовую ставку. На GLM-5.3-Flash Codex закрыл все 64 задачи за 1,26 часа, Claude Code и Pi за 2,48 часа. Суммарное время агентов составило 6,6 часа у Codex против 15,25 часа у Claude Code и 15,9 у Pi. Пропускная способность у Codex 50,5 задачи в час и 26 решённых в час, у Claude Code 25,8 и 12,9.
Отсюда и двукратная разница в счёте: 22,8 доллара против 45. На Qwen3.8-27B с одной H200 разница почти пропадает: Codex стоил около 9 долларов, Claude Code 10,26, Pi 10,16. Авторы считают её заметной только в масштабе. Все варианты остаются дешевле API: в первой статье серии тот же объём работы через API Anthropic обошёлся примерно в 98 долларов.
Петля Pi
Помимо самих цифр, aistack наткнулась на две аномалии, которые заметно били по времени и стоимости. Первая связана с Pi: раз за разом один-два воркера застревали в так называемой doom loop, бесконечной петле. Так было и на Qwen3.8-27B (с уровнем рассуждений xhigh), и на GLM-5.3-Flash (max), причём задачи, на которых агенты застревали, каждый раз были разными. В итоге модели срывались в повторяющуюся бессмыслицу. В опубликованном логе воркер выводит одну и ту же пару строк, «Auto packing the repository in background for optimum performance. See "git help gc" for manual housekeeping.», пока оркестратор не убивает его по лимиту в четыре часа.
Чтобы не наказывать Pi за ошибку, которую, как рассчитывают авторы, скоро исправят, все цифры Pi в статье посчитаны по средним оценкам и по прогонам без зацикливания. С зацикленными прогонами общее время работы, по словам авторов, вырастает значительно.
Что сломалось в 2.1.233
Вторая аномалия касается префиксного кеширования. Неизменную начальную часть контекста, системный промпт и историю диалога, движок может не пересчитывать на каждом шаге, а брать KV-кеш для неё из памяти. Для длинных агентных траекторий от этого напрямую зависят задержка, пропускная способность и счёт. Сломать механизм легко: достаточно одного меняющегося элемента в самом начале контекста, например даты или UUID в системном промпте. Тогда префикс перестаёт быть статичным, и всё, что идёт после него, уже не кешируется.
Во время тестов вышла новая версия Claude Code, и после обновления aistack увидела резкое ухудшение времени до первого токена и скорости генерации. Главное, просела доля попаданий в префиксный кеш, и авторы считают это явным признаком того, что кеширование сломано. На Qwen3.8-27B у версии 2.1.233 средняя доля попаданий составила 29,84% (между 10-м и 90-м перцентилями от 23,4 до 37,8%), у пропатченного релиза 97,36% (от 95,9 до 98,6%). Ишью заведено в репозитории claude-code на GitHub. Все остальные цифры Claude Code в статье получены уже на исправленной версии.
Если не считать этого сбоя, по кешу обвязки почти не отличаются. На Qwen3.8-27B средняя доля попаданий у Codex 96,58%, у Pi 95,5%, у Claude Code 97,36%. На GLM-5.3-Flash это 94,17%, 94,43% и 96,72%.
Обе аномалии, по мнению авторов, временные и со временем будут исправлены. Сами результаты они называют снимком состояния: модели и обвязки меняются быстро, и через месяц лучшей может оказаться совсем другая связка. Для собственного стека совет у них практический: при каждом обновлении следить за временем прогона, токенами и долей попаданий в кеш, потому что «слепое обновление до новых версий может заметно отразиться на счёте в конце месяца, и не на пару процентов».
Дальше
Бюджет Anthropic можно потратить на Cursor и Vercel
Обязательство по расходам на Anthropic теперь можно тратить на чужие продукты. В Claude Marketplace добавили CrowdStrike, Cursor, Factory, Gamma и Vercel, а каталог вырос с шести партнёров до одиннадцати, по данным Crypto Briefing.
Читайте также
- PR от Claude принимают в 84% случаев, от Devin в 43%
- Pairmark судит гонку Claude Code и Codex вслепую
- Claude Code и две бесплатные модели не сошлись на Next.js
- Четыре модели Claude в связке дали 78% на Terminal-Bench
- Аудит сессии Claude: 7,5 млн токенов и 4038 вызовов
- Claude Code принёс адоптерам на 24% больше смерженных PR
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.