
ИИ-агенты провалили большинство медицинских тестов в США
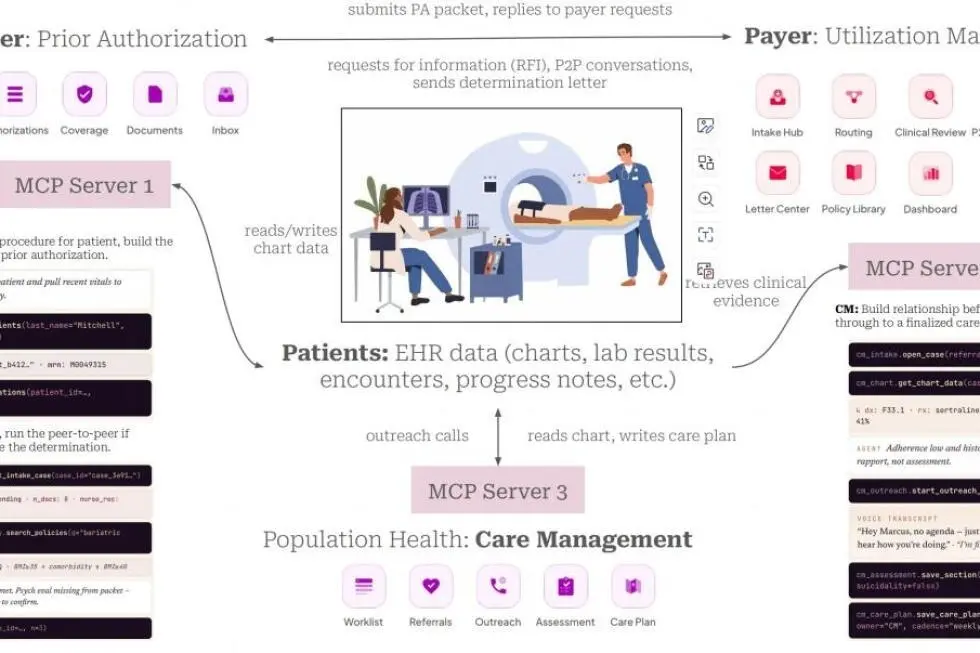
Новый бенчмарк CHI-Bench показал, что лучшие ИИ-агенты не справляются с 72 процентами реальных медицинских процессов. Исследователи протестировали 30 моделей в 75 сложных сценариях, включая согласование лечения и управление уходом.
Лучший результат показал Claude Code на базе Opus 4.6 с показателем успешности всего 28 процентов. На втором месте оказался GPT-5.5 от OpenAI с результатом 21 процент. При повторных запусках надежность падает еще сильнее, ни одна модель не преодолела порог в 20 процентов при троекратном прохождении одного теста.
Тестирование имитирует реальную работу клиник и состоит из десятков шагов. Результаты показывают, что готовность ИИ-агентов к автономной работе в медицине сильно преувеличена.
Дальше
Вышло обновление Claude Code v2.1.152
Claude Code стал еще агрессивнее в автоматизации. Теперь команда ревью не просто дает советы, а сама правит код в файлах, если добавить флаг fix. Это превращает инструмент из советчика в полноценного исполнителя, который берет на себя рутину по рефакторингу.
Читайте также
- Sonnet 5 выровняла более сильную модель Opus 4.8
- Шифр Уркварта поддался Claude Fable 5.1 за 44 минуты
- Модель Anthropic формализовала теорему Ферма в Lean
- PR от Claude принимают в 84% случаев, от Devin в 43%
- Автоисследователь Anthropic обгоняет людей за шесть часов
- Открытая обвязка на Strands и 99,95% у Claude Opus 5
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.