
Доля решённых задач падает до 0,5% к концу сессии
Точность моделей проседает задолго до заполнения окна. В тесте NoLiMa 11 из 13 моделей с заявленным контекстом от 128k на 32k токенов опустились ниже половины своего короткого базового результата: у GPT-4o 69,7% против 99,3%.
SlopCodeBench (arXiv 2603.24755, март 2026) заставил 11 моделей дорабатывать собственный код на 93 контрольных точках. Целиком задачу не решил ни один агент, лучший результат на контрольной точке 17,2%, к финальной строгие решения упали до 0,5% при росте стоимости в 2,9 раза. Структурная деградация видна в 80% прогонов.
Автор советует делать /clear на границах задач, а /compact запускать заранее, пока остаётся запас. В Claude Code 2.1.220 команда /context отдельной строкой показывает Autocompact buffer, зарезервированное место под будущее саммари.
Дальше
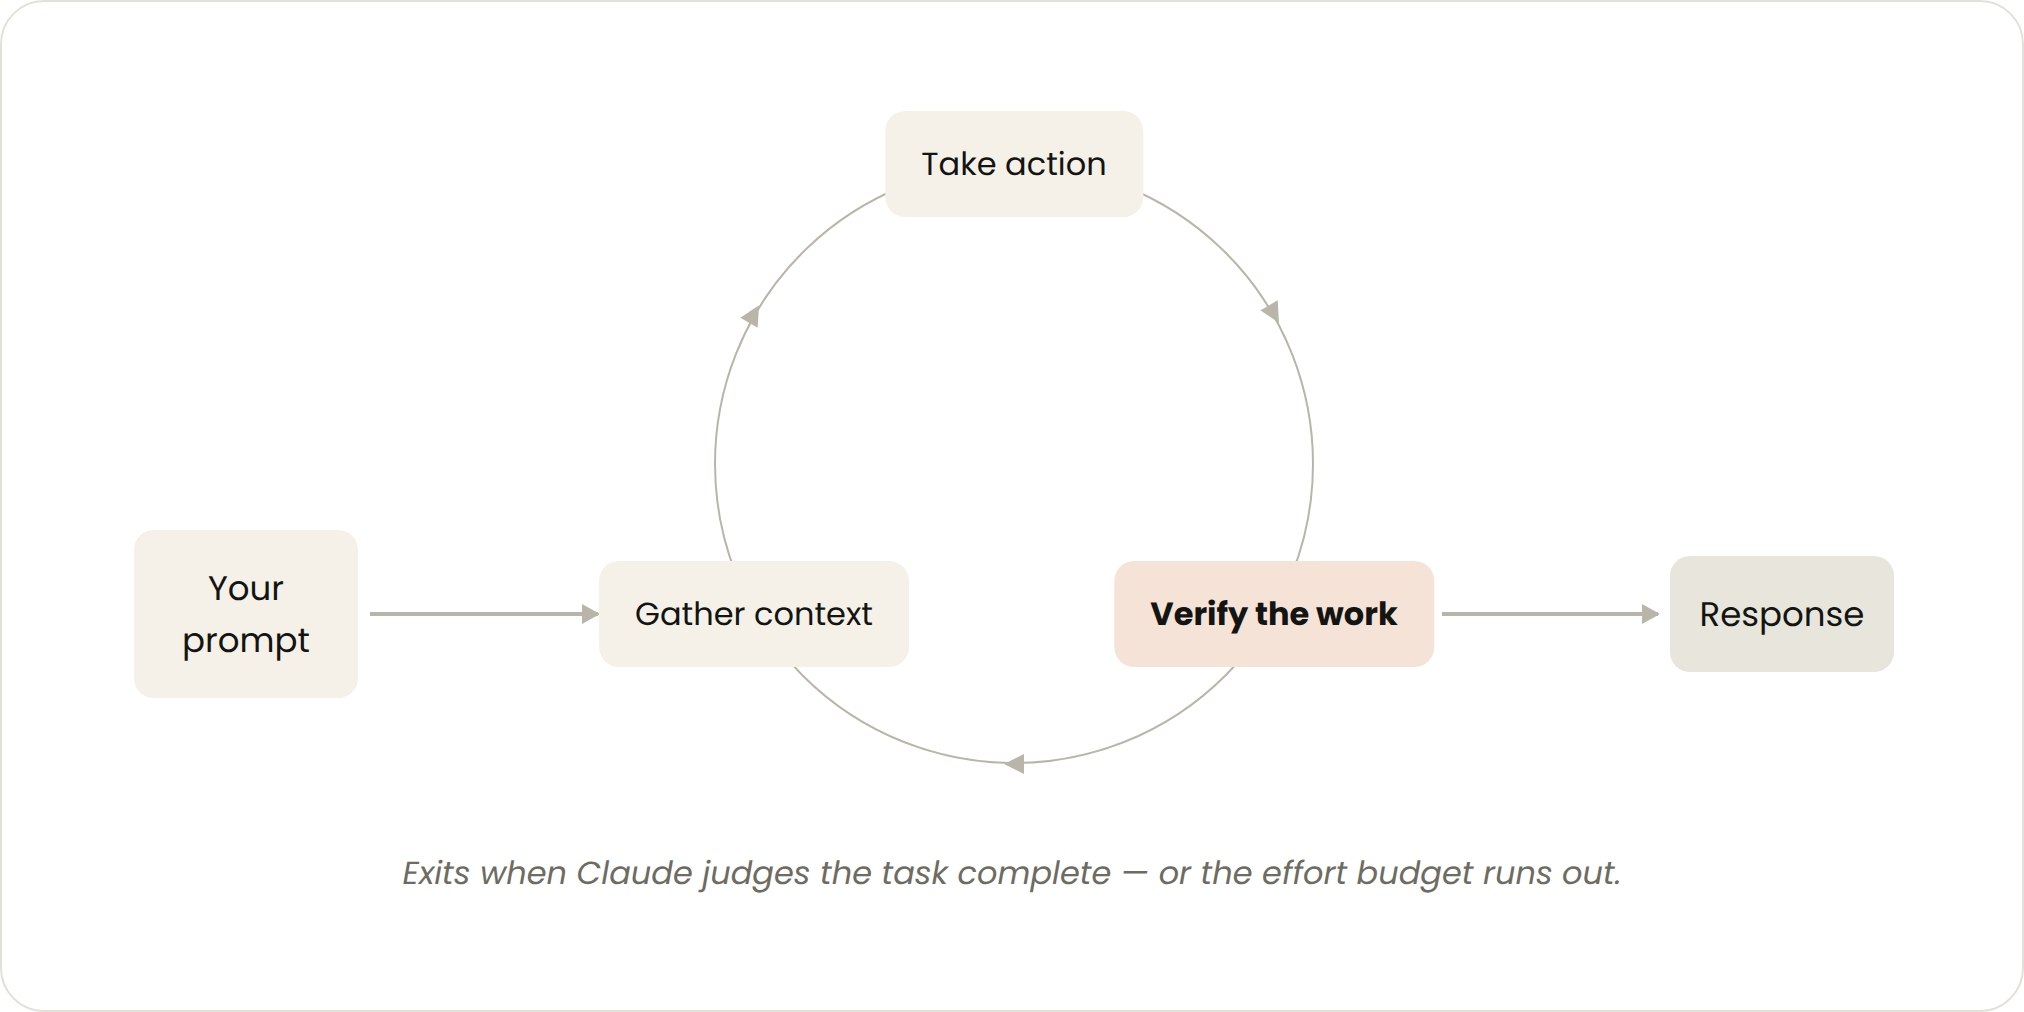
Четыре типа циклов в Claude Code: /goal, /loop, /schedule
«Доведи Lighthouse главной страницы до 90 и выше, остановись после 5 попыток»: такой критерий задаёт команда /goal в Claude Code. Каждый раз, когда Claude пытается остановиться, оценщик проверяет условие и возвращает его к работе.
Читайте также
- Вывод в Claude Code стоит примерно в 5 раз дороже ввода
- Claude Code шлёт 33k токенов до чтения промпта, у OpenCode 7k
- Замер ponytail: −10,3% к счёту вместо обещанных −20%
- Хакатон Claude Code в Японии ждёт и тех, кто не пишет код
- Из промпта Claude Code вырезали больше 80% текста
- Haiku 5.5 печатает быстро, но молчит 415 секунд
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.