
Claude Code отдал свой TypeScript вместе с source maps
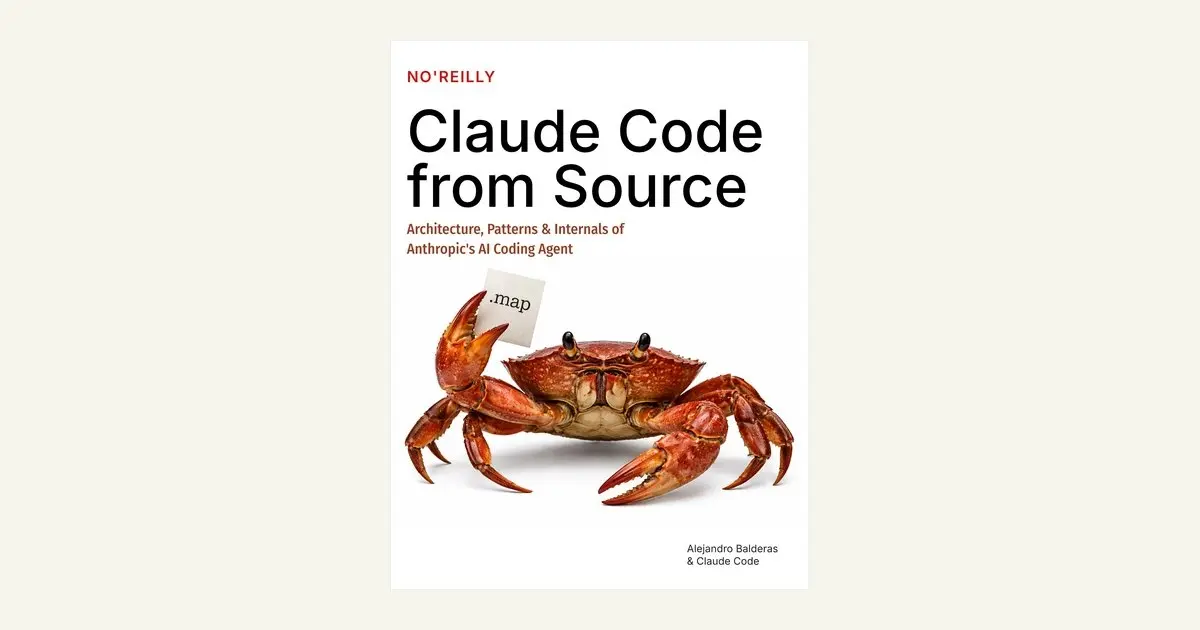
Когда Claude Code выложили в npm, вместе с бандлом уехали файлы .js.map, а в них поле sourcesContent с полным оригинальным TypeScript: почти две тысячи файлов. По ним собрали книгу-разбор на 18 глав об устройстве агента, и лежит она на сайте Claude-code-from-source.
Коротко
- Книгу собрали 36 ИИ-агентов в четыре фазы: шесть читали дерево исходников, двенадцать написали 494 КБ черновой документации, пятнадцать переписали всё главами, трое ревьюеров выдали 900 строк замечаний.
- Одна из находок про деньги: параллельные дочерние агенты-форки получают байт-в-байт одинаковый префикс промпта, переиспользуют кэш и экономят около 95% входных токенов.
- Кода Claude Code в книге нет: все примеры переписаны псевдокодом с другими именами переменных, а финальный аудит отдельно проверял, что дословных фрагментов не осталось.
Если вы не следили за тем, как устроена поставка: Claude Code ставится из npm обычным пакетом, и, как пишут на сайте книги, им пользуются сотни тысяч разработчиков. Собранный бандл минифицирован, читать его руками бессмысленно, поэтому вся история держится на отладочных артефактах сборки.
Почему в npm-пакете оказался весь исходный TypeScript?
Source map сопоставляет строки минифицированного бандла со строками оригинала, чтобы отладчик показывал вам нормальный код. У этого формата есть необязательное поле sourcesContent, куда сборщик складывает сами исходники целиком, чтобы отладчику не приходилось искать их отдельно. Именно оно и приехало в опубликованный пакет.
Внутри оказалась вся архитектура: почти две тысячи файлов на TypeScript, тех самых, из которых собирается агент. Авторы книги прочитали их и разложили в семь частей, от загрузки процесса и слоя работы с API до многоагентной оркестрации, памяти, интерфейса, сетевой части и производительности.
Восемнадцать глав написали 36 агентов примерно за шесть часов
Процесс расписан по фазам. Шесть параллельных агентов прочитали дерево исходников, двенадцать написали 494 КБ технической документации, пятнадцать переписали всё с нуля повествовательными главами, а трое ревьюеров выдали 900 строк замечаний, которые применяли ещё три агента. От извлечения исходников до готовой отредактированной книги ушло около шести часов.
Каждая глава заканчивается блоком «Apply This» с пятью переносимыми паттернами и советами, как их приспособить у себя. Отдельно оговорено, что книга чисто образовательная, проприетарный код она не воспроизводит, а обложка в стиле «NO'REILLY» сделана как пародия и к O'Reilly Media отношения не имеет.
Цикл агента крутит асинхронный генератор, а форки экономят 95% входных токенов
Весь агент держится на асинхронном генераторе: он отдаёт сообщения наружу, возвращает типизированный терминальный результат и получает естественный backpressure и отмену. Пока модель ещё стримит ответ, движок спекулятивно стартует инструменты только на чтение. Дальше запрос проходит конвейер из 14 шагов, а инструменты батчируются по классу безопасности: чтения параллельно, записи по очереди.
Кэш промпта работает как общий разогретый старт: одинаковое начало считается один раз на всех. Поэтому параллельные форк-агенты специально получают байт-в-байт совпадающий префикс, что даёт экономию около 95% входных токенов. Ради той же стабильности кэша сделаны sticky latches: если бета-заголовок один раз отправлен, посреди сессии его уже не снимают. Контекст сжимается в четыре слоя: snip, microcompact, collapse, autocompact.
Память лежит в файлах, а нужные записи выбирает отдельный запрос к Sonnet
Базы данных под памятью нет, есть файлы и четыре типа записей с предупреждениями об устаревании. Что именно вспомнить, решает боковой запрос к Sonnet, и авторы книги утверждают, что такой отбор обыгрывает поиск по эмбеддингам. Скиллы грузятся в две фазы: на старте только frontmatter, полное содержимое подтягивается в момент вызова.
Отдельная часть посвящена миллисекундам. Старт укладывается в 240 мс за счёт параллельного ввода-вывода, для нечёткого поиска используются битмап-префильтры, а лимит вывода по умолчанию держат на 8K токенов и поднимают до 64K только при упоре в потолок, что экономит контекст в 99% запросов. Конфигурация 27 хуков жизненного цикла замораживается на старте, чтобы её нельзя было подменить в рантайме.
Проверить книгу по оригиналу читатель не сможет: все фрагменты кода переписаны псевдокодом, и это сознательное решение авторов, а не побочный эффект. Утверждение про Sonnet вместо эмбеддингов на сайте не подкреплено ни одним измерением, как и цифра в 95% экономии. На наш взгляд, поле sourcesContent в опубликованном пакете обходится дороже любой другой строки в конфиге сборки.
Останется ли sourcesContent в пакете
Ближайшая проверка простая: распаковать следующий релиз Claude Code из npm и посмотреть, лежат ли рядом .js.map с полем sourcesContent. Меняла ли Anthropic конфигурацию сборки после выхода книги, на сайте не сказано, дат и планов там тоже нет. Открытый вопрос для читателя другой: сколько из десяти описанных паттернов переживут перенос в чужой агент, где нет ни того же кэша, ни того же конвейера инструментов.
Читайте также
- Разбор Claude Desktop: MCP-сервер работает вне песочницы
- Флот агентов для Claude Code собирает один HTML-файл
- Pairmark судит гонку Claude Code и Codex вслепую
- Oh My Subagents сохраняет работу команд Claude Code
- Agent-hop переносит живой чат Claude Code в Codex
- Плагин Pragma ведёт фичу в iOS от идеи до релиза
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.