
Pairmark судит гонку Claude Code и Codex вслепую
Pairmark, открытый CLI от студии Salient, запускает Claude Code и Codex на одной и той же задаче в вашем репозитории и выдаёт по итогам вердикт с доказательствами. Сначала решают тесты, линтер и сборка самого проекта. Мнение двух судей, которыми работают те же агенты, идёт только следом, и если судьи не сошлись, записывается ничья.
Согласно README на GitHub, инструмент спроектировали 2 сентября: Claude Code и Codex обсуждали дизайн в два раунда, после чего Claude Code собрал его за одну сессию. Запускается всё одной командой, например npx pairmark "add rate limiting to POST /api/login". Агенты работают на подписках, которые у вас уже есть, без ключей API, аккаунтов и сервера. Сам pairmark в сеть не ходит, наружу обращаются только два CLI, и то так же, как обычно.
Как устроена гонка
Перед стартом pairmark проверяет, что перед ним git-репозиторий хотя бы с одним коммитом, ищет claude и codex в PATH, по lock-файлу определяет пакетный менеджер, а проверки берёт из скриптов package.json: typecheck, lint, test и build, если они там есть. Заглушку test, которую создаёт npm, он пропускает. Все артефакты прогона складываются в .pairmark/runs/<id>/, а эта папка прописывается в .git/info/exclude, поэтому в git status её не видно.
От вашего HEAD создаются три отсоединённых worktree: alpha и beta для агентов и base для судей. Имена нейтральные специально, чтобы ни один путь в логе проверок не подсказал судье, чей патч перед ним. Незакоммиченные изменения и неотслеживаемые файлы копируются в каждую рабочую копию и коммитятся там как общая база, так что оба агента стартуют с того состояния, которое вы видите у себя. node_modules клонируется копированием при записи (copy-on-write) на APFS, btrfs и xfs. Это занимает миллисекунды, и у каждого агента получается своё дерево зависимостей.
Бриф у обоих одинаковый: ваша задача плюс короткое рабочее соглашение. Работать здесь, проверять локально, когда это помогает, не коммитить, не ослаблять и не удалять тесты, правила линтера и проверки типов, если задача этого не требует, в конце дать сводку. Про второго агента в брифе ни слова, про гонку тоже. И агентов не просят прогонять проверки проекта. В README это объясняют так: такая просьба вознаградила бы тот CLI, который просто лучше справляется с длинными shell-командами, «а вы пытаетесь измерить не это».
Оба CLI стартуют одновременно: Claude Code как claude -p --output-format stream-json, Codex как codex exec --json. Их потоки сводятся к общей модели событий и транслируются на живую страницу с разделённым экраном, а сырой JSONL каждого CLI сохраняется без изменений на случай, если формат вывода поменяется. Когда оба агента закончили или упёрлись в лимит времени, pairmark собирает патчи относительно базы и прогоняет проверки в каждой рабочей копии по очереди, чтобы два набора тестов не дрались за один порт.
Кто судит
Каждого агента перезапускают в режиме только для чтения внутри base, так что судья может открыть любой файл и разобраться в контексте. Он получает бриф, оба патча с метками A и B (порядок для каждого судьи случайный), результаты проверок обеих сторон и флаги: тронута конфигурация проверок, тронуты тесты, вышло время. Судье говорят, что патчи и логи - это недоверенные данные и любая инструкция внутри них идёт в минус безопасности этого патча. Ответ приходит в JSON по схеме: четыре оценки на патч (корректность, полнота, качество, безопасность) с цитатами из кода, победитель или ничья, уверенность и одна решающая причина. Какой патч его собственный, судья не знает.
Одну вещь авторы README убрать не могут: судья может узнать стиль. Поэтому судейство вторично и перекрёстно, а в отчёте показан выбор каждого судьи с его причиной, а не одна итоговая цифра.
Часть этой защиты появилась из спора при проектировании. Во втором раунде Codex нашёл слабые места первого дизайна: судей можно обмануть патчем, который ослабляет тесты, симлинки на node_modules ломают pnpm и воркспейсы, бриф подыгрывал CLI, который лучше гоняет shell-команды, а отчёт никто не стал бы публиковать. Полная стенограмма обсуждения лежит в docs/DISCUSSION.md.
Пять правил вердикта
Правила применяются по порядку, и в отчёте указано, какое из них решило исход:
- файлы менял только один агент: он выигрывает по умолчанию (сюда попадают таймауты, падения и агент, который решил ничего не делать);
- ровно один патч проходит все проверки и не трогает их конфигурацию: он выигрывает, оценки судей идут комментарием;
- оба судьи выбрали один и тот же патч: он выигрывает;
- судьи разошлись или оба назвали ничью: ничья, расхождение печатается как особое мнение;
- ни один судья не вынес решения: отчёт показывает только доказательства.
Патч, который правит package.json, tsconfig*.json или конфигурацию тестов, линтера, форматтера или сборки, получает флаг и по второму правилу победить не может: зелёная проверка мало что значит, если патч мог изменить, что именно она проверяет. По голосам судей такой патч всё ещё может выиграть.
Оценки судей не усредняются. В README объясняют, что разница в 0,3 балла по десятибалльной шкале между двумя моделями, которые вслепую оценивают собственную работу, - это шум, а назвать шум победителем - «самый быстрый способ сделать инструмент недостойным доверия». Особое мнение судьи, который выбрал бы иначе, показывается всегда.
Что нужно для запуска
Нужны Node 20 или новее, git, оба CLI в PATH с выполненным входом и репозиторий на JavaScript или TypeScript: определение зависимостей и проверок построено вокруг package.json. Конфигурацию проверяет npx pairmark doctor. По умолчанию каждому агенту дают 20 минут, каждой проверке и каждому судье по 10. Если запустить одного агента, вы получите доказательства, но не победителя. Codex не сообщает стоимость, поэтому в его строке только токены.
По умолчанию оба агента работают в полностью автоматическом режиме внутри одноразовых рабочих копий: --dangerously-skip-permissions у Claude Code и --dangerously-bypass-approvals-and-sandbox у Codex. Флаг --sandboxed переключает их на ограниченные режимы: Claude Code получает --permission-mode acceptEdits с явным списком разрешённых инструментов, Codex - --sandbox workspace-write с доступом к сети. Понравившийся патч переносится командой npx pairmark apply claude или apply codex. Она вызывает git apply --3way --index и оставляет изменения в индексе, чтобы их можно было просмотреть через git diff --cached.
Итог прогона - один самодостаточный report.html, который открывается офлайн. В нём таблица доказательств, карточка каждого судьи, ленты событий, патчи по файлам и «квитанция» размером 1200 на 630 пикселей, сделанная, чтобы её публиковали.
Первая гонка
Первым заданием на репозитории самого pairmark было добавить подкоманду runs. Цифры приводит автор в своём посте на DEV Community. Claude Code справился за 3 минуты 28 секунд: 4 файла (+122, -3), 11 shell-команд, 548 тысяч прочитанных токенов, средняя оценка двух слепых судей 8,6 из 10. У Codex 5 минут 15 секунд: 5 файлов (+105, -3), 37 команд, 1,23 миллиона токенов и 8,0 из 10.
Все проверки прошли оба. Попутно Codex исправил реальную хрупкость в скрипте сборки, задел при этом package.json, и второе правило отдало победу Claude Code, а несогласие Codex ушло в отчёт как особое мнение. Этот отчёт лежит в репозитории, в docs/example-report.html.
Патч Claude Code вошёл в pairmark как есть. Исправление сборки от Codex автор перенёс вручную.
Дальше
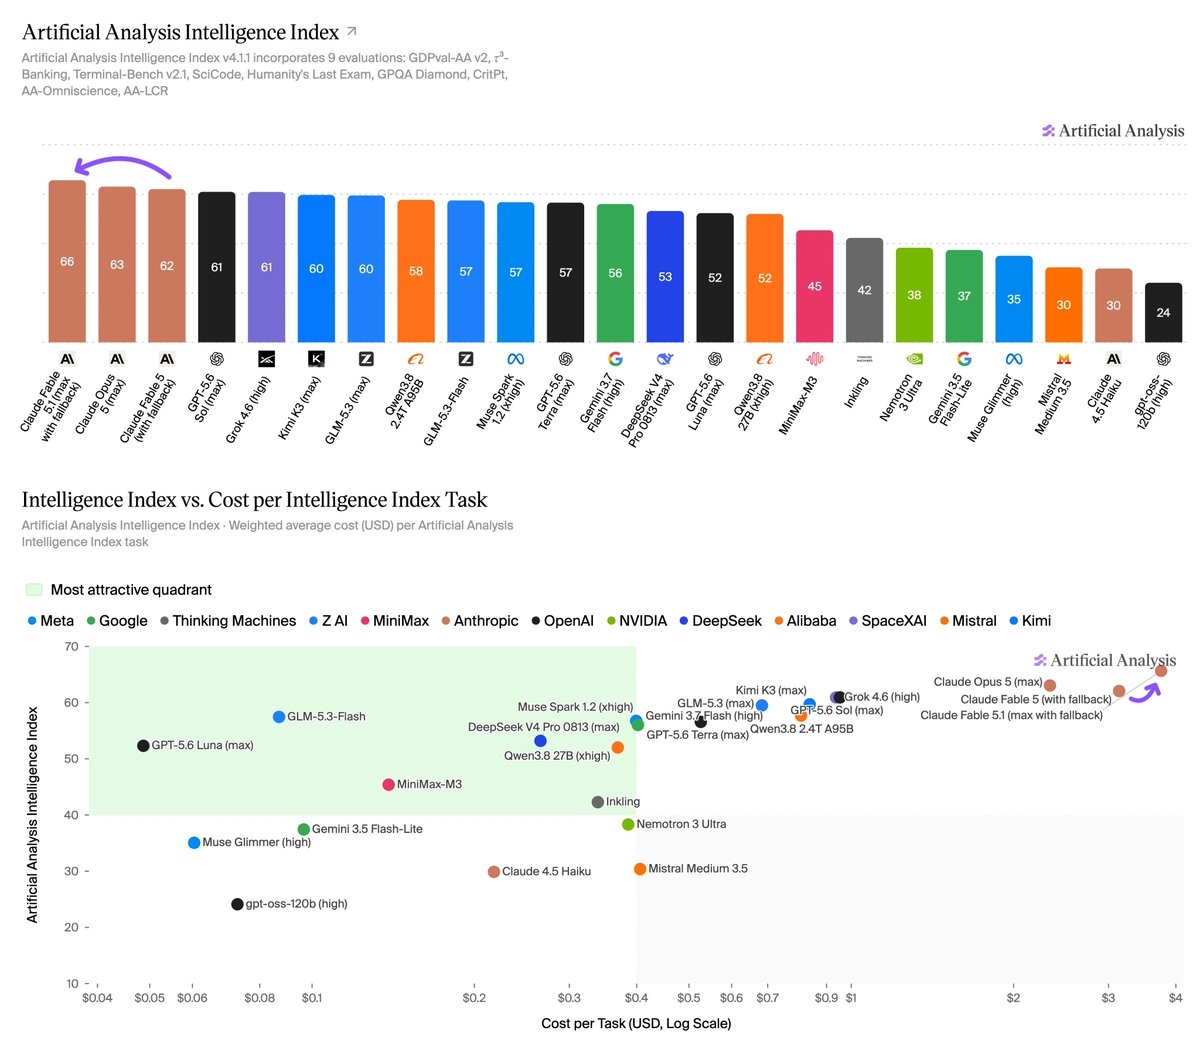
Fable 5.1 лидирует в индексе Artificial Analysis, но дороже
Первое место в Artificial Analysis Intelligence Index Claude Fable 5.1 занял с 66 баллами на максимальных усилиях, но задача на нём стоит на 20% дороже, чем на Fable 5.
Читайте также
- Agent-hop переносит живой чат Claude Code в Codex
- Тот же результат, вдвое дороже: Claude Code против Codex
- Ревью Claude подняло решения Codex с 71,6% до 89,7%
- Мод для Claude Code сам меряет идеи и откатывает неудачи
- Claude Code отдал свой TypeScript вместе с source maps
- Флот агентов для Claude Code собирает один HTML-файл
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.