
GLM-5.2 (max) сравнялась с Claude Opus 4.8 на Harvey LAB-AA
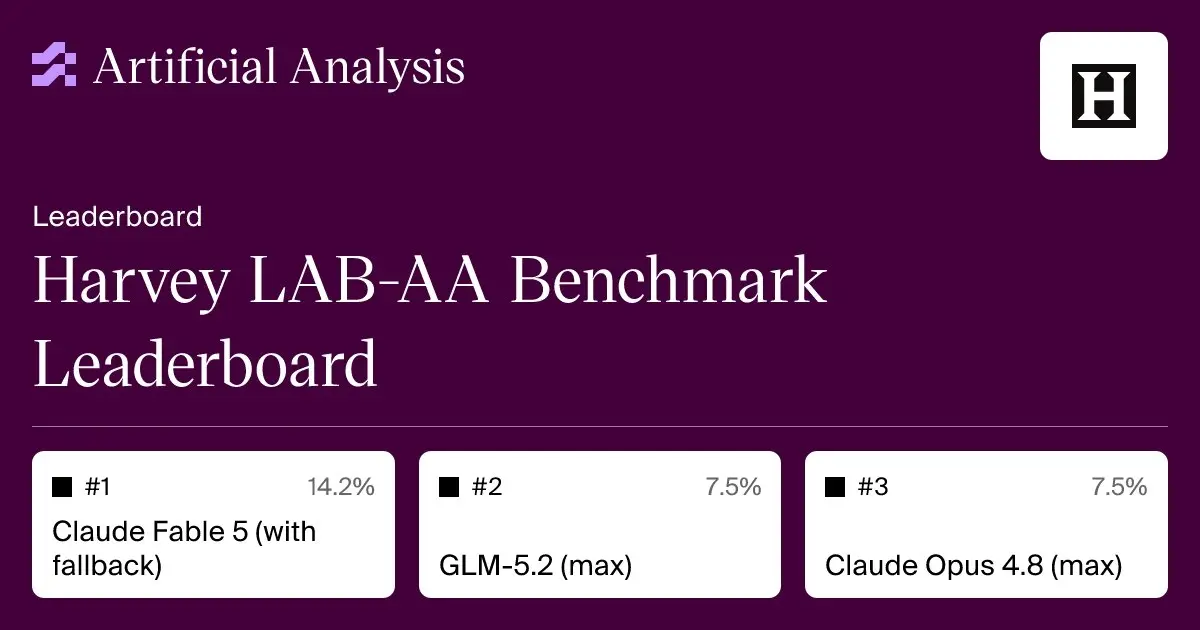
По независимому замеру Artificial Analysis, GLM-5.2 (max) вышла на уровень Claude Opus 4.8 по метрике all-pass rate в бенчмарке Harvey LAB-AA. Оценка идёт по строгой схеме Harvey: задача засчитывается, только если проходят все критерии рубрики, без частичного зачёта.
Бенчмарк построен на юридических задачах. Модель разбирает контракты из data room по сделкам M&A, ищет положения о смене контроля и уступке прав и готовит отчёт для команды сделки в формате coc-analysis-report.docx.
Помимо all-pass rate, Artificial Analysis замеряет стоимость задачи с разбивкой по input, cache hit, cache write, reasoning и answer токенам, число output-токенов на задачу, время декодирования и среднее количество ходов агента на задачу.
Дальше
В Claude Code сообщают об утечке чужих учётных данных между сессиями
Задача уходила на сервер 59.110.139.37, а ассистент по SSH подключился к чужому хосту 8.211.46.34. По отчёту пользователя от 29 июня, в сессию Claude Code попали чужие root-учётки, и он записал данные в продакшн-базу другого арендатора.
Читайте также
- Сравнение GLM-5.2 и Claude Opus 4.8
- Модели Anthropic не вышли на фронтир в PR-ревью на уязвимости
- Semgrep: GLM-5.2 обошёл Claude Code в поиске IDOR
- Пятичасовой таймаут объяснил разрыв в оценках Qwen 3.8-Max
- Kimi K3 против Fable 5: тот же код, треть цены, вчетверо дольше
- Haiku 5.5 печатает быстро, но молчит 415 секунд
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.