
Claude нашёл 29 000 возможных багов, исправлены пока 516
К 2 октября внешние фирмы проверили 6 123 находки моделей Anthropic и подтвердили 5 674 из них, а исправленных в апстриме уязвимостей на ту же дату было 516. Эти цифры с дашборда раскрытий приводит The New Stack.
Как пишет Anthropic в анонсе OSS Scanner, за полгода её модели нашли в важнейших опенсорсных проектах больше 29 000 кандидатов в уязвимости. Вручную разобрать удалось примерно 6 000. Компания прямо говорит, что упирается в людей, которые проверяют находки. Новый сканер этот этап обходит: отчёты уходят мейнтейнерам без проверки человеком.
Где застревают находки
Ручную проверку, как уточняет The New Stack, ведут шесть внешних фирм по исследованию безопасности: они воспроизводят баги и сортируют их по важности. Мейнтейнерам ушло 6 157 находок, выпущено 584 идентификатора CVE и GitHub Security Advisory, причём часть находок получила оба. Непросмотренными остаются примерно 23 000 кандидатов.
Проверенная находка в репозитории ещё не патч. Исправление нужно протестировать, бэкпортировать в поддерживаемые ветки и выпустить в релизе.
На академическом бенчмарке CyberGym языковые модели в начале прошлого года находили меньше 20% уязвимостей, а в этом году находят больше 85%. В Anthropic добавляют, что эксплойт теперь можно написать за минуты, поэтому выигрывают проекты, которые быстрее находят и закрывают дыры.
Как устроена быстрая дорожка
До сих пор Anthropic раскрывала уязвимости по своей политике скоординированного раскрытия. Там сказано, что каждый отправленный отчёт, как правило, проверен и подтверждён человеком, срок раскрытия стандартный, 90 дней, а темп отправки подстраивается под то, сколько мейнтейнеры успевают переварить. Этот канал сохраняется, особенно для проектов, у которых нет людей разбирать отчёты самостоятельно.
Быстрая дорожка выросла из просьб самих мейнтейнеров. Получив первые отчёты, всё больше проектов просили прислать сразу всё непроверенное вместе с предложенными патчами. Таких отчётов Anthropic, по её словам, отправила уже почти 5 000. Для сравнения, всего мейнтейнерам по дашборду ушло 6 157 находок.
OSS Scanner, запущенный 8 октября, делает из этого постоянный сервис по образцу OSS-Fuzz от Google, только вместо фаззеров (инструментов, которые бомбардируют программу случайными входными данными) работают языковые модели, включая Claude Mythos. Подключённые проекты бесплатно и регулярно получают сканы. Вывод целиком сгенерирован моделью, и Anthropic предупреждает, что отдельные отчёты могут оказаться неверными.
В каждом отчёте есть самодостаточный воспроизводящий пример, объяснение уязвимости и, когда модель может его предложить, кандидат в патч. Где получается, объяснение включает бисекцию: поиск по истории коммитов того места, где баг появился. Последние несколько недель конвейер обкатывали на десятках проектов. Эти первые раскрытия содержали сотни отчётов, и несколько уязвимостей удалось связать в цепочки до удалённого выполнения кода без аутентификации.
Подключиться могут основные мейнтейнеры подходящих проектов: для этого нужно отправить PR в GitHub-репозиторий сервиса по стандартному шаблону. Критерии похожи на критерии OSS-Fuzz: у проекта должно быть «критическое влияние на инфраструктуру и безопасность пользователей», решения принимают в каждом случае отдельно. Кроме того, Anthropic предлагает Claude for OSS с бесплатной подпиской Claude Max 20x для мейнтейнеров и Cyber Verification Program для проверенных специалистов по безопасности.
Сколько в отчётах шума
Раннюю версию сканера проверили пентестеры, которые обычно вычитывают находки для скоординированного раскрытия. Им дали 97 уязвимостей критической и высокой важности из 48 проектов. Планку раскрытия прошли 85, или 88%. Из оставшихся 12 одиннадцать оказались настоящими багами, но дублировали уже известные проблемы или другие находки того же скана. Ложным срабатыванием признали одну.
The New Stack отмечает, что эта выборка описывает только ранний вывод сканера и мало говорит о находках низкой важности и о работе в большом масштабе. Сама Anthropic признаёт, что мейнтейнеры жаловались на завышенную оценку серьёзности и на случаи, когда сканер не понял модель угроз проекта.
По сообщению Tech Times, 1 октября Google временно приостановила приём отчётов в программу вознаграждений за уязвимости в открытом ПО из-за «значительного роста автоматических отправок, подавляющее большинство которых невалидны».
Что говорят мейнтейнеры
У wolfSSL из 74 полученных отчётов валидными оказались все, кроме двух, а пять стали CVE. «С приложенными патчами отчёты легли прямо в наш обычный процесс проверки и исправления», говорит Тодд Ауска из wolfSSL. Ноа Миш из PostgreSQL рассказал, что несколько отчётов пришли с исправлениями, которые можно взять почти как есть, а быстрый доступ позволил закрыть свежие проблемы до того, как они попали в релиз.
Антон Арапов из OpenSSL Corporation вспоминает, что первые ИИ-отчёты около полутора лет назад были «ужасающими». По его словам, отчёты Anthropic, включая сырой вывод модели, были не хуже, а иногда и лучше присланных людьми. «Особенно когда к отчёту приложен настоящий эксплойт: для инженера это, по сути, готовая работа, проверить можно сразу», говорит он. Эдди Колер из HotCRP отметил, что отчёты показали хорошее понимание сложной модели прав доступа в проекте.
Даниэль Стенберг из curl говорит, что OSS Scanner помог найти в curl несколько проблем, которые стоило исправить, в том числе «одну из худших уязвимостей curl за последние несколько лет».
Дальше
Codex научился тратить сброс лимита по просьбе в чате
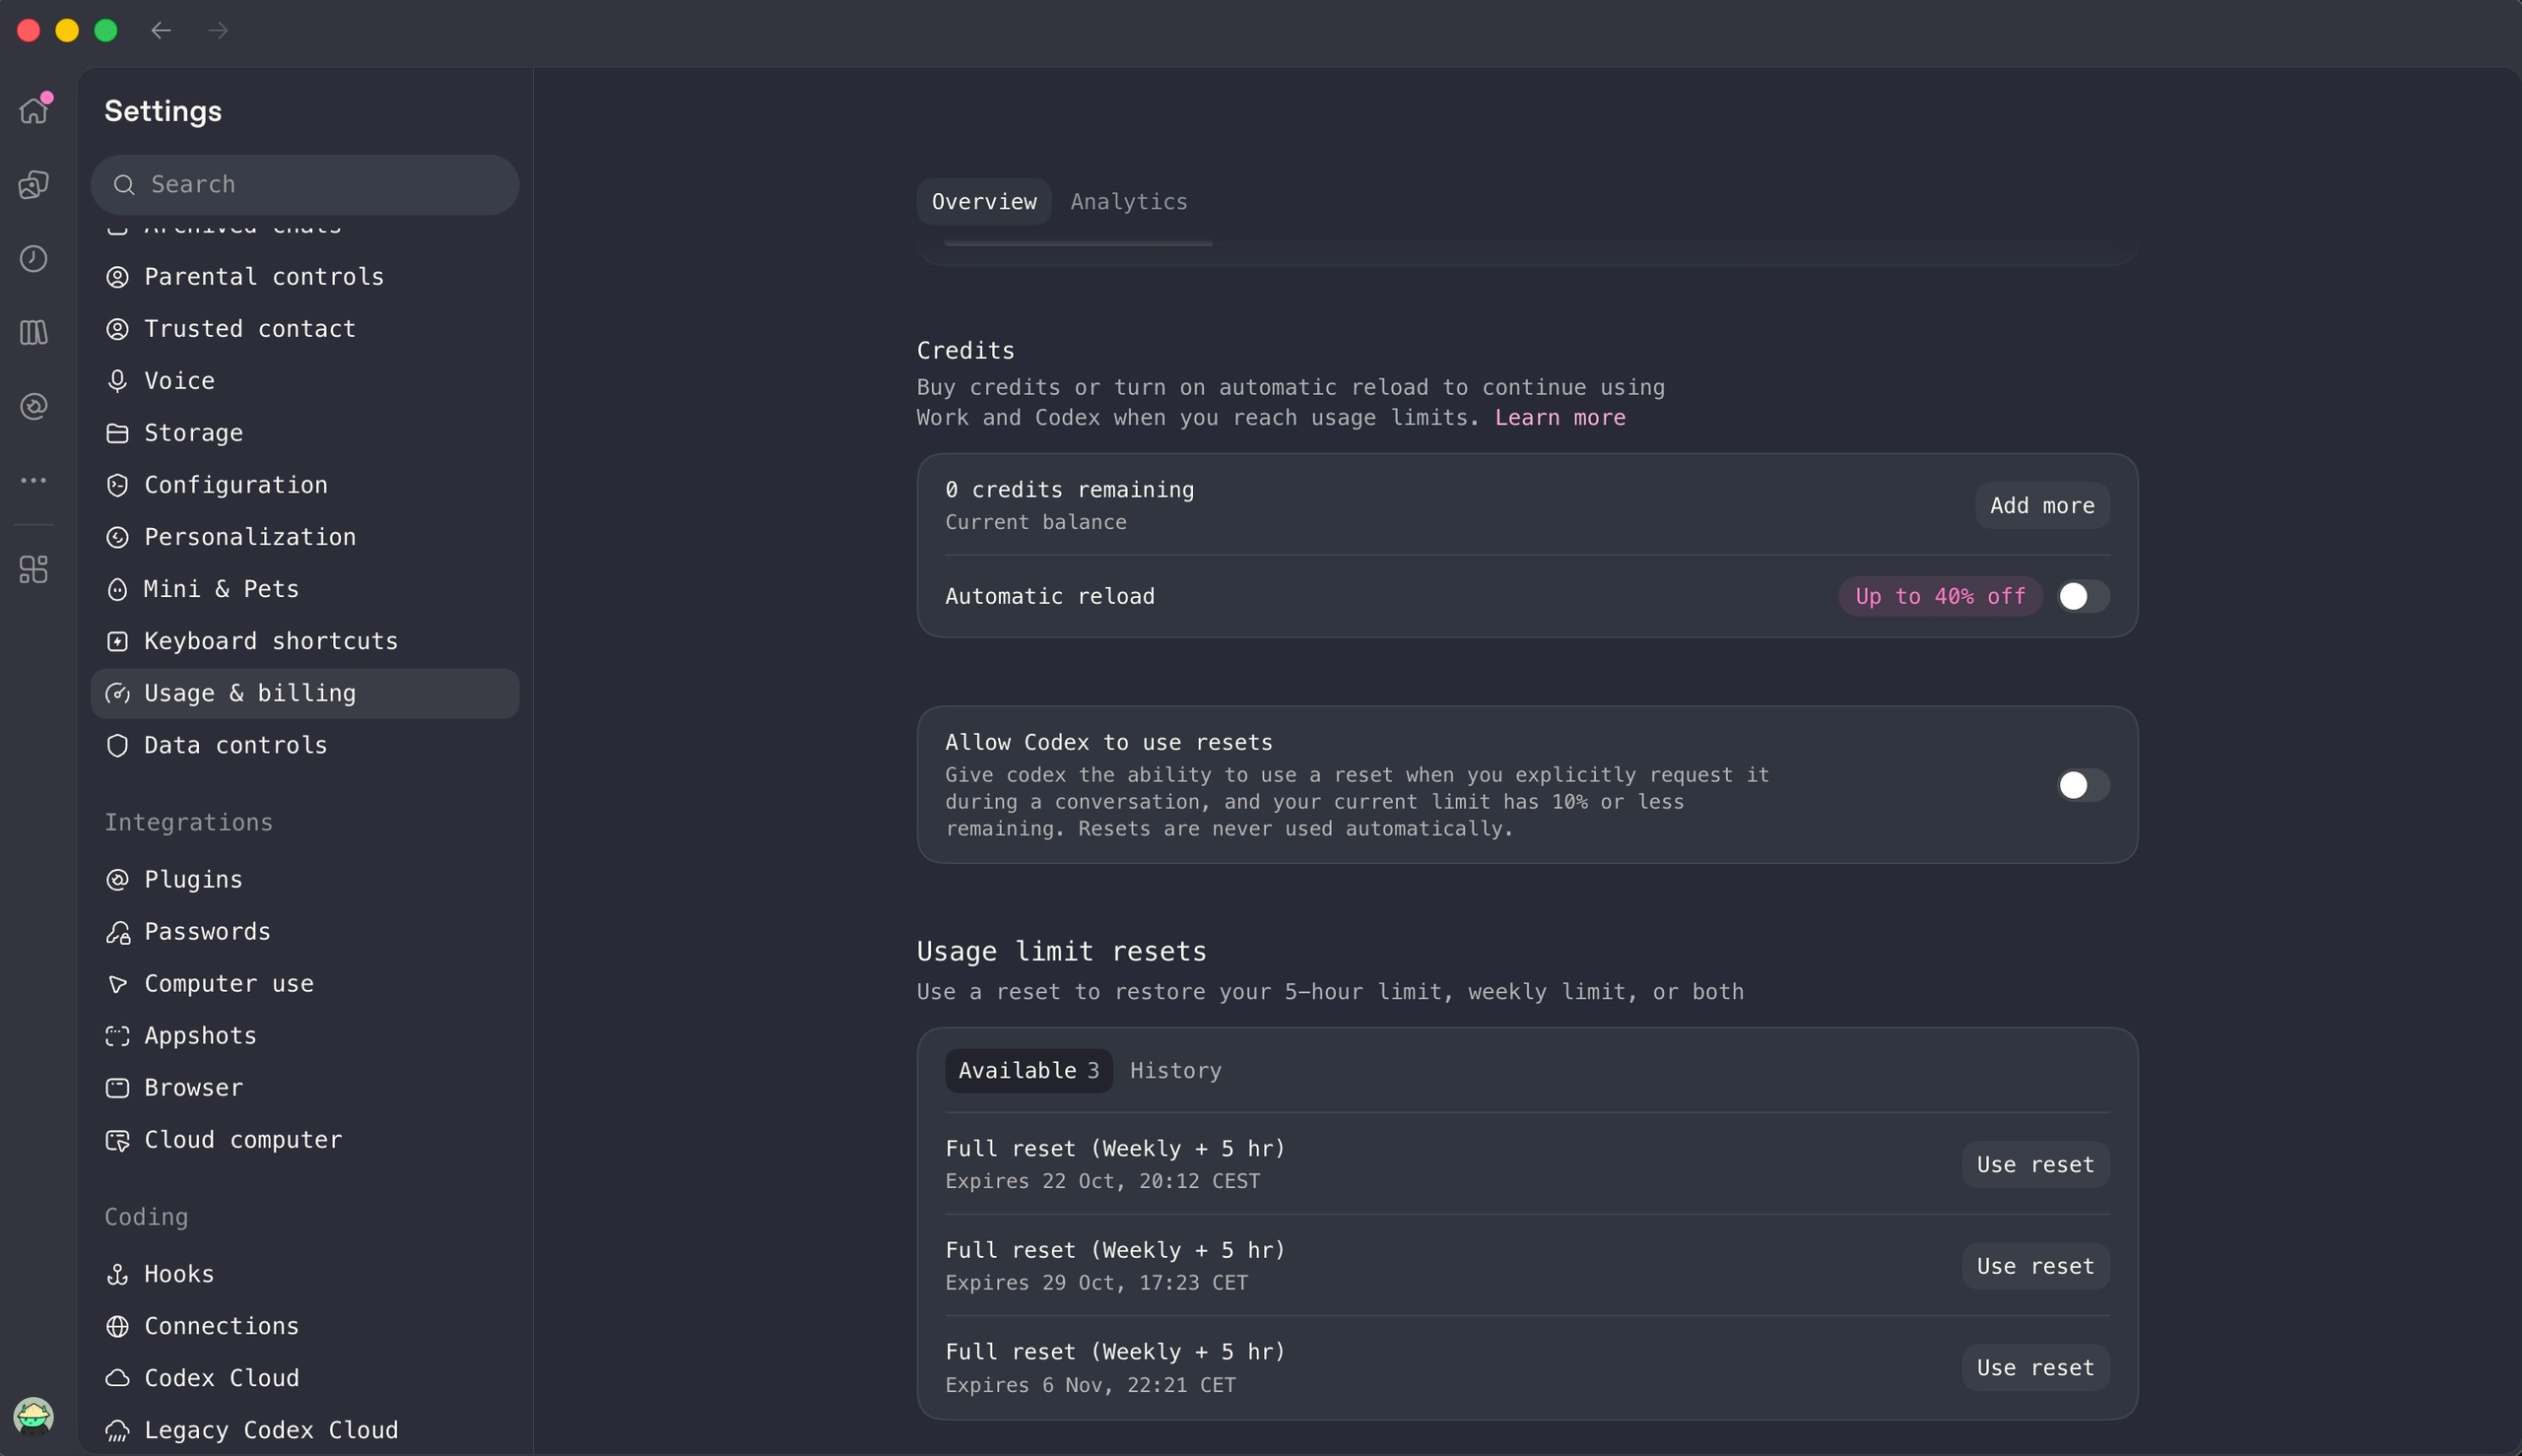
Агент в Codex дожигает последние 10% лимита посреди задачи, и вы пишете ему в чате: используй сброс. Новая настройка в разделе Usage & billing разрешает именно это, но сам Codex сбросы никогда не тратит. Как часто вы упираетесь в лимит Codex посреди задачи?
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.