
Claude, GPT и Gemini всегда ставят Sentry и Playwright
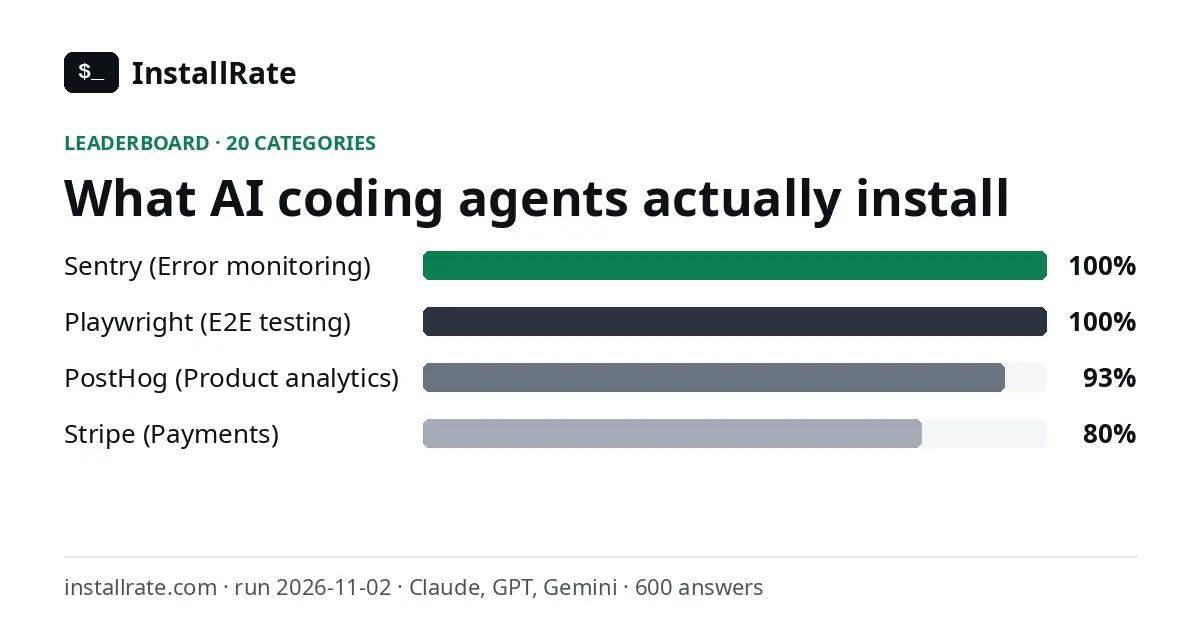
В 600 ответах на задачи сборки, где ни один продукт не назван, Claude, GPT и Gemini единогласно, в 100% случаев, выбрали два инструмента: Sentry для мониторинга ошибок и Playwright для E2E-тестов. Это следует из рейтинга InstallRate по прогону 2 ноября. Если стек выбирает модель, эти две строки в такой выборке предрешены, но речь идёт о разовых ответах через API, а остальные расхождения между моделями держатся примерно на 10 ответах на модель в категории: из 19 таких расхождений, которые мы проверили, за пределы выборочного шума выходит всего одно.
Где модели сходятся
Stripe в платежах первым ставят 80% ответов у каждой из трёх моделей. Postgres чаще всего уезжает в Neon: 67% в целом, у Claude 80%, у GPT и Gemini по 60%. PostHog в продуктовой аналитике набрал 93%, shadcn/ui среди UI-библиотек 63%, Drizzle среди ORM 53%. Долей InstallRate называет продукт, который ответ установил первым, от всех ответов в категории.
Datadog модели упомянули 9 раз и не установили ни разу. Radix UI назван 11 раз, а выбор уходит к shadcn/ui. Cloudflare R2 модели упоминают, а потом ставят AWS SDK: S3 идёт первым в 57% ответов про объектное хранилище. В деплое у Vercel 12 установок, у Netlify, Railway, Render и Fly.io ни одной, при этом каждую из четырёх платформ упомянули по два раза, и все упоминания от Claude. Эти счёты мы сверили с сырыми данными, и они сходятся. «Упомянут» здесь значит, что продукт встретился где угодно в ответе, включая альтернативы и комментарии в коде.
Где модели расходятся
По таблице рейтинга Claude в логировании первым ставит OpenTelemetry (50%), а GPT берёт связку Grafana, Loki и Prometheus (60%). Во флагах функций таблица показывает у Claude Vercel Flags, у GPT LaunchDarkly, у Gemini PostHog (50%). В наблюдаемости LLM-приложений Gemini выбирает LangSmith (50%), Claude и GPT - Langfuse.
Такие пары мы прогнали через точный тест Фишера, стандартную проверку того, не случайна ли разница между двумя маленькими выборками. OpenTelemetry у Claude в 5 ответах из 10 против 1 у GPT дал p = 0,141, PostHog во флагах у Gemini, 5 из 10 против 2 у Claude, дал p = 0,350. Единственное расхождение вне шума касается pgvector: 6 из 10 у GPT и 0 из 10 у Gemini, p = 0,011.
Тест исходит из того, что ответы независимы, а дизайн прогона выполняет это условие не полностью. «Около 10 ответов на модель» складываются из пяти промптов, каждый из которых прогнан дважды, и в 264 парах из 300 (88%) оба прогона одного промпта дали одинаковый первый выбор. Реальная выборка на модель ближе к пяти промптам, поэтому почти все счёты в данных чётные.
Что значит «установил»
Каждый ответ получен одним запросом к API с системным промптом «You are a coding agent…», температурой 1,0 и лимитом 2000 токенов на выход. Отвечали anthropic/claude-sonnet-5.5, openai/gpt-5.6-terra и google/gemini-3.1-pro-preview. Код никто не запускает: выбор извлекается из текста. Из 600 выборов 494 взяты из команды установки, 19 из CLI-команды, 6 из импорта, 24 разметила «небольшая модель», один взят из прозы, а в 56 ответах выбора нет вовсе. Чаще других ничего не ставит Claude: 26 таких ответов против 16 у GPT и 14 у Gemini. Сам InstallRate пишет, что ответы API «не то же самое, что полноценный агент в вашей IDE» вроде Claude Code, Cursor или Codex, и обещает следующими агентные прогоны.
Авторский разбор
Что мы проверили
5 ноября мы пересчитали первый выбор каждой модели по сырым ответам прогона и сверили результат с таблицей рейтинга и страницами категорий.
Общие доли и счёты «назван, но не установлен» подтвердились. Но колонки моделей показывают одно имя там, где в данных ничья: так в 9 категориях из 20, и в четырёх из них чаще всего модель не ставила ничего. Поэтому расхождение между моделями в одной клетке сводной таблицы может оказаться ничьей, которая видна только на странице категории.
| Где | В таблице рейтинга | В сырых данных |
|---|---|---|
| Фоновые задачи, все три модели | BullMQ / Bull 40% | BullMQ и Celery по 4 из 10 у каждой модели, по 12 из 30 в целом |
| Флаги функций, GPT | LaunchDarkly 30% | ничья: LaunchDarkly 3, PostHog flags 3 |
| Realtime, Claude | Ably 20% | пятеро по 2 из 10: Ably, ws, Socket.IO, Django Channels и «ничего» |
| Векторные базы, Gemini | Pinecone 20% | чаще всего ничего (3 из 10), Pinecone, Chroma и Qdrant по 2, pgvector ни разу не упомянут |
| Supabase | упомянут, не установлен | верно только для хостинга Postgres (4 упоминания, 0 установок); Supabase Auth стоит в 3 ответах про авторизацию, Supabase Realtime в 4 ответах GPT, где делит первое место с Socket.IO |
| Почта | Resend 16, Postmark 4, Mailgun 0 | второе место у Nodemailer, 7 |
Celery и BullMQ разводит стек промпта: на промптах для Node и TypeScript первым всегда шёл BullMQ, на промптах для Django и FastAPI всегда Celery. В октябре похожее было и на другом табло, где Heroku появлялся только на Python-промптах: в 14 из 30 запусков против 0 из 29 на Next.js.
Любую клетку рейтинга лучше читать вместе с интервалом со страницы категории. При 3 ответах из 10 интервал Уилсона, диапазон, где с уверенностью 95% лежит настоящая доля, тянется от 11 до 60%.
Дальше
OpenAI покупает Pierre, чьи Trees и Diffs уже стоят в Codex
Файлы и правки в приложении Codex давно показывают библиотеки стартапа Pierre, и OpenAI покупает его целиком вместе с сервисом Code Storage для хранения кода в Git. Axios вписывает сделку в гонку за место GitHub. Код у вас живёт на GitHub или уже переехал на другую платформу?
Читайте также
- Claude Code и две бесплатные модели не сошлись на Next.js
- Microsoft обещает в MAI Code 2 почти Opus за 5% цены
- GPT-6.1 Sol переносит COBOL с точностью 86,6% вместо 5,4%
- Scion по чертежам Anthropic собрали в открытом коде
- Copilot первый в тесте GitHub и четвёртый у Martian
- Токены рассуждений Luna 6 в Codex зависят от способа входа
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.