
GPT-6.1 Sol переносит COBOL с точностью 86,6% вместо 5,4%
Новые модели OpenAI резко прибавили в COBOL, Fortran, Visual Basic и других языках, на которых мало кода для обучения. Это следует из замеров OpenAI от 19 октября. На MultiLangBench, где модель с нуля пишет совместимый с SQLite движок базы данных, GPT-6.1 Sol на максимальном уровне рассуждений набирает почти столько же, сколько флагманская GPT-6 Astra: 87,0% тестов против 87,4%, а прогон обходится в среднем в 7,53 доллара против 32,18. В переносе программ с COBOL GPT-6.1 Sol на низком уровне рассуждений сохраняет их поведение в 86,6% случаев, у GPT-5.6 Sol на том же уровне было 5,4%.
Astra или GPT-6.1 Sol
Главная цифра поста - 87,4% у GPT-6 Astra на максимальном уровне рассуждений в среднем по 20 языкам, против 26,8% у GPT-5.6 Sol, причём рост есть в каждом языке. Astra выше 83% в 19 языках из 20, слабее всего у неё COBOL с 72,1% (у GPT-5.6 Sol было 10,9%). Fortran вырос с 21,4% до 83,5%, Visual Basic с 27,5% до 89,4%.
Результаты GPT-6.1 Sol на MultiLangBench есть только на графиках поста. На максимальном уровне она обгоняет Astra в 7 языках из 20, в том числе в COBOL (72,6% против 72,1%) и Fortran (84,1% против 83,5%), а средние у двух моделей расходятся всего на 0,35 пункта. Один прогон Astra на COBOL стоит 54,72 доллара.
GPT-6 Luna, которую в сентябре поставили рядом с Astra как более дешёвую модель, на максимальном уровне набирает 40,3%. Прогон стоит у неё 0,77 доллара против 3,48 у GPT-5.6 Sol, примерно на 78% дешевле, и GPT-5.6 Sol она обходит в каждом языке.
Миграция COBOL
Во втором тесте модели переводят программы с COBOL на C++, Java, Kotlin, Python или Rust. Проверяют их скрытыми тестами: видимый вывод должен совпасть побайтово, и миграция засчитывается, только если прошли все тесты. OpenAI приводит пример ловушки: арифметика с фиксированной точкой в COBOL отбрасывает лишние десятичные знаки, если округление не запрошено явно. Переписанная программа, которая их округляет, работает без ошибок, но выдаёт другие финансовые результаты. На кону банковский код: по оценке IBM, на которую ссылается OpenAI, COBOL обслуживает больше 40% систем онлайн-банкинга, 80% очных операций по картам и 95% транзакций в банкоматах.
GPT-6.1 Sol на низком уровне рассуждений даёт 86,6% при средней стоимости 0,31 доллара против 0,51 у GPT-5.6 Sol на том же уровне, на 39% дешевле. Максимум в 97,9% по графику OpenAI достигается уже на уровне xhigh за 0,70 доллара, уровень max за 0,98 к нему ничего не добавляет. Кривая при этом неровная: medium даёт 96,9%, high 95,9%. GPT-6 Astra доходит до 96,8% на xhigh и max за 3,26 и 4,51 доллара, GPT-6 Sol до 95,8% на max за 1,92, GPT-5.6 Sol останавливается на 65,2%.
Для продакшена, оговаривает сама OpenAI, всё равно нужны экспертная проверка и тесты на бизнес-правилах и зависимостях конкретной системы. Тесты и данные этой оценки компания не публикует, так что 97,9% снаружи не воспроизвести.
Авторский разбор
Что мы проверили
20 октября мы скачали репозиторий MultiLangBench, прогнали его проверку хешей, запустили заглушку, которая передаёт запросы настоящему SQLite 3.40.1, и извлекли данные из графиков поста.
OpenAI пишет, что выложила на GitHub среду оценки, тесты и результаты по каждому языку. В репозитории есть тесты и генератор эталонных ответов, но нет ни программы, которая запускает решение модели, ни результатов: данные по языкам лежат только в графиках поста. Цифры поста при пересчёте сходятся, но чужой балл на MultiLangBench будет зависеть от раннера, который каждый напишет сам.
- Тестов 23 939, официальное подмножество из 272 совпадает с README. Заглушка на эталонном SQLite проходит все 272 за 13,9 секунды на одном CPU, так что дорога в оценке сессия модели, а проверка дешёвая.
- На срезе из 1 516 тестов та же заглушка провалила один:
degrees(acos(0.5))на нашей машине aarch64 дал 60.00000000000001 при эталоне 59.99999999999999. Прогон один, архитектура одна, подмножество из 272 не затронуто, но в полном наборе как минимум один эталон зависит от платформы. - Таймаут 60 секунд, провал при падении и ноль за код не на целевом языке описаны только в README, код этого не проверяет. Язык решения README предлагает проверять другой языковой моделью.
Дальше
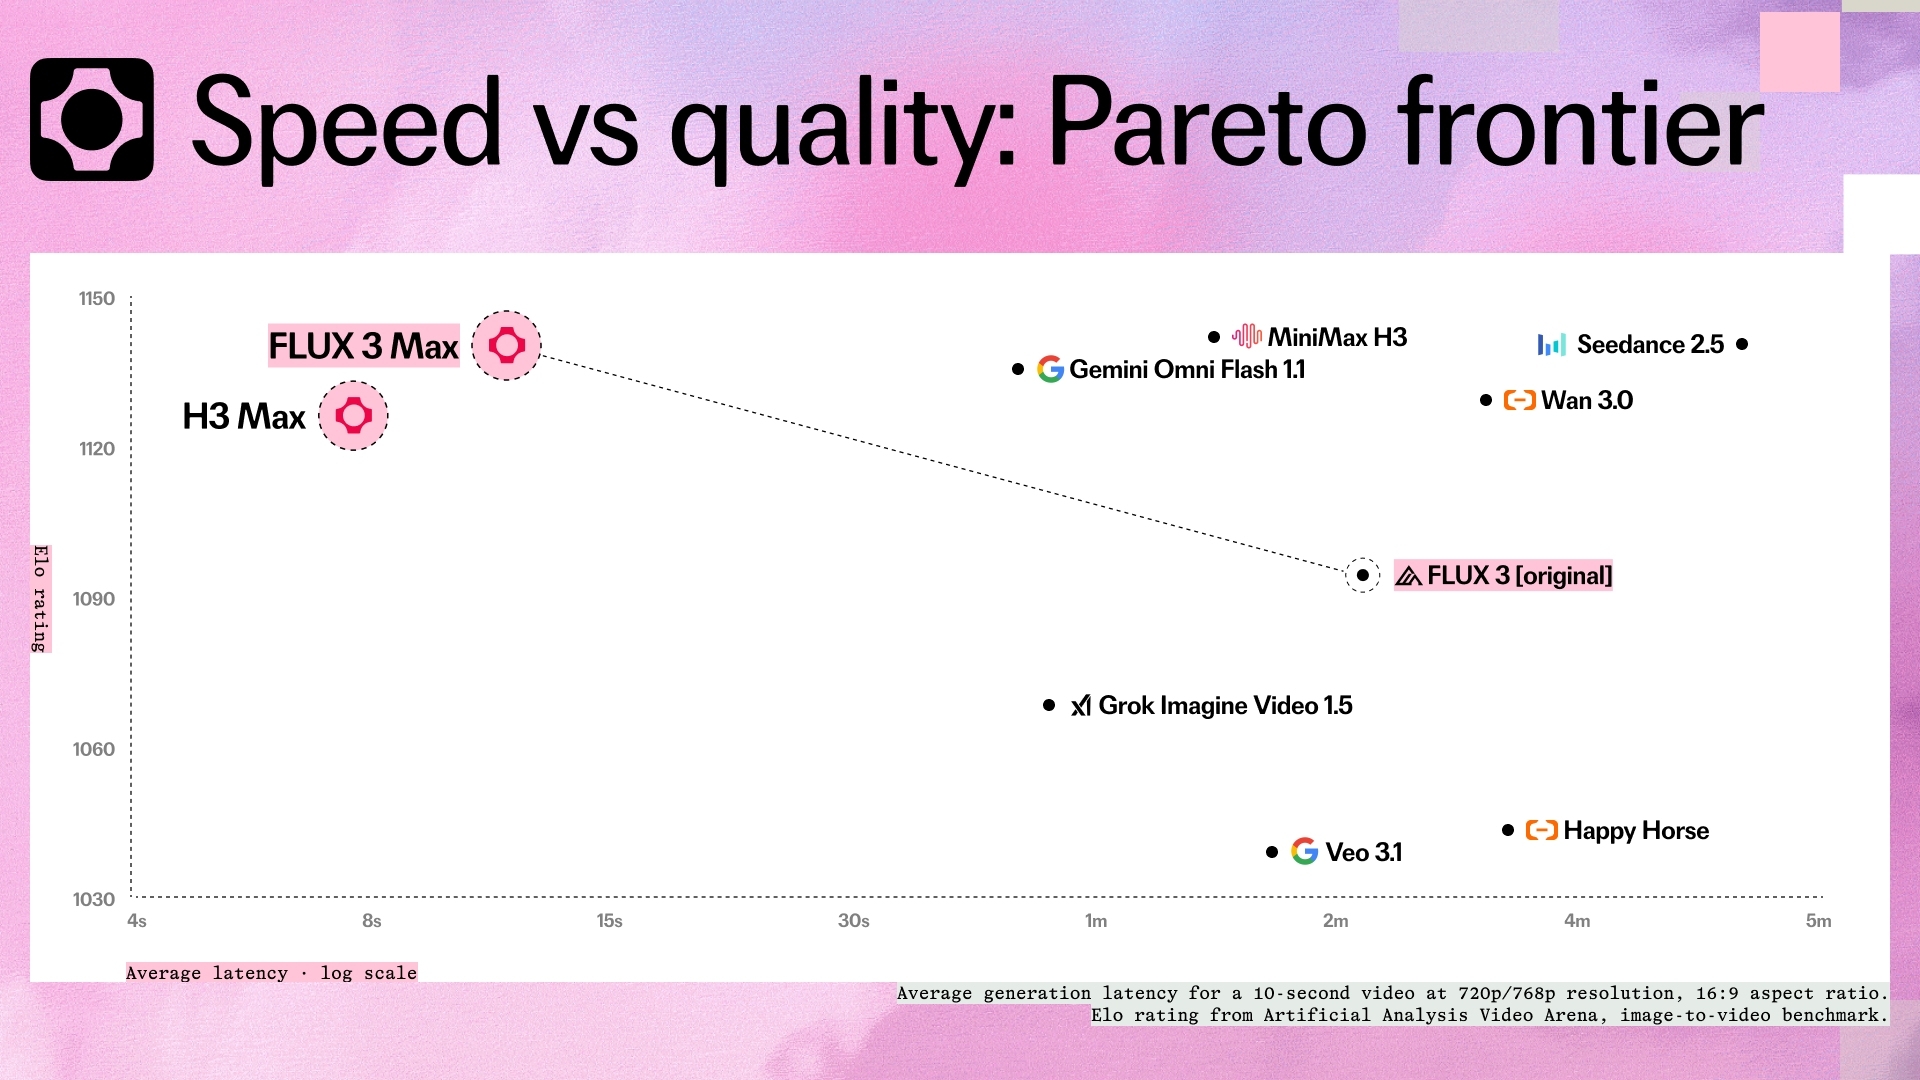
FLUX 3 Max делает 10-секундное видео примерно за 11 секунд
Десятисекундный ролик FLUX 3 Max собирает примерно за 11 секунд, а Seedance 2.5 в том же тесте fal тратила 277,8 секунды. Цифра снята в тестовой конфигурации, и fal прямо пишет, что реальное время зависит от настроек. Сколько секунд вы готовы ждать одну генерацию видео?
Читайте также
- Цены за токен у GPT-6 Sol и Luna упали вдвое и больше
- Независимый трекер меряет Codex на SWE-Bench-Pro ежедневно
- Fast-режим отваливается в десктопном Codex с API-ключом
- Sol переписала ядра OpenAI и срезала 20% стоимости
- ChatGPT Work и Codex достигли 10 млн активных пользователей в неделю
- В Codex нашли подозрительную кластеризацию reasoning-токенов у GPT-5.5
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.