
Anthropic советует Opus 5.5 и дешёвый прогон на low
Anthropic в гайде по выбору моделей, опубликованном 9 ноября в блоге Claude, советует начинать большинство задач по коду и работе со знаниями с Opus 5.5 на среднем effort: за токен он вдвое дешевле Fable 5.2 и стоит моделью по умолчанию в Claude Code. Если результат проверяется автоматически, гайд предлагает гнать всё на low и перезапускать на high только провалы. На подмножестве SWE-bench Pro такая схема у Opus 5.5 дала около 97% решённых задач по 0,17 доллара за задачу против 95,3% и 0,29 доллара, когда всё шло на high.
Сначала effort, потом модель
Effort задаёт, как долго модель думает, сколько инструментов вызывает и насколько тщательно перепроверяет себя. Anthropic называет его более тонкой ручкой, чем смена модели, и предлагает, когда модель не справляется, идти по шагам. Сначала убедиться, что модель может проверить свою работу тестом, сборкой или скриптом, который дёргает эндпоинт. Потом поднять effort на один уровень. И только затем перейти на модель старше, начав с effort ниже, чем был на младшей.
Цена каждого уровня видна по SWE-bench Pro. Opus 5.5 на medium набрал примерно на 2,5 пункта меньше, чем на high, при 70% стоимости. На low он отстал примерно на 8 пунктов, зато обошёлся в треть цены. На xhigh прибавил около 1,4 пункта, но стоил в 2,5 раза дороже, чем на high. Самопроверка, по словам Anthropic, часто выходит дешевле и медленнее не делает, в отличие от подъёма effort.
Выше high один дополнительный уровень может стоить как модель старше. На FrontierCode 2.0 Fable 5.2 на high набрала 45,3%, а Opus 5.5 на max 45,5%, при этом Fable обошлась примерно вдвое дешевле за задачу. Отсюда правило гайда: прежде чем поднимать Opus 5.5 выше high на трудной задаче, попробуйте Fable 5.2. При этом effort не добавит модели знаний или навыков, которых у неё нет. Для этого всё равно нужна модель старше.
Какая модель под какую задачу
От Opus 5.5 гайд предлагает двигаться в обе стороны:
- Sonnet 5.5 - для чётко очерченной работы: багфикс, фича по спецификации, чат на low или medium, документы и слайды, повторяющиеся агентные задачи вроде ревью.
- Haiku 5.5 - для классификации, маршрутизации, извлечения данных на больших объёмах и для сабагентов, которые ищут по файлам, читают логи и делают выжимки.
- Fable 5.2 - для крупных рефакторингов и миграций, проектирования архитектуры, управления множеством сабагентов, глубоких исследований, а также для длинных прогонов без присмотра и случаев, когда Opus 5.5 на high не хватает.
Чёткая спецификация ещё не повод брать Sonnet: миграция или оптимизация производительности могут быть хорошо описаны и всё равно требовать Opus 5.5, а крупная миграция - Fable 5.2. Для ревью кода у этой схемы есть внешняя цифра: в CodeRabbit на Sonnet 5.5 в сентябре вышло около 60% экономии на задачу против Sonnet 5.
Прайс по списку Claude API, за миллион токенов на входе и выходе: Haiku 5.5 - 0,10 и 0,50 доллара для промптов до 100 тысяч токенов и 0,50 и 2,50 доллара для более длинных, Sonnet 5.5 - 2 и 10 долларов, Opus 5.5 - 4 и 20, Fable 5.2 - 8 и 40. У всех четырёх контекст в 1 миллион токенов и до 128 тысяч токенов на выходе. Fast mode, более быструю генерацию за повышенную плату, предлагают только Opus 5.5 и Fable 5.2. Effort по умолчанию в API у Opus 5.5 и Haiku 5.5 medium, у Sonnet 5.5 и Fable 5.2 high, но в Claude Code у последних двух medium; свой уровень показывает /effort status.
Где на самом деле уходят деньги
Чтение из кэша у Fable 5.2 и Opus 5.5 стоит одинаково, 0,20 доллара за миллион токенов. Поэтому в длинном прогоне, где большая часть входа идёт из кэша, разница между ними сводится к некэшированному входу и выходу, где Fable вдвое дороже. У Haiku 5.5 цена зависит от длины промпта: свыше 100 тысяч токенов тариф впятеро выше, хотя всё ещё в четыре раза ниже, чем у Sonnet 5.5. На коротких промптах вход Haiku обходится в двадцать раз дешевле Sonnet, а если каждый вызов требует длинного промпта, гайд советует сравнивать эти две модели по цене готовой задачи, а не по прайсу.
Размер основного контекста тоже бьёт по счёту на каждом ходу. У Opus 5.5 чтение кэша за ход стоит около 0,03 доллара при 150 тысячах токенов контекста и около 0,004 доллара при 20 тысячах. Anthropic предлагает держать в контексте дорогой модели только решения, а объёмное чтение отдавать дешёвым сабагентам. И при сравнении моделей считать отдельно самые трудные задачи: в одном поисковом бенчмарке из 20 задач две забрали 43% всех трат.
Что теряется при смене модели
Кэш промпта принадлежит модели, которая его записала, поэтому первый ход на новой модели оплачивает запись кэша для всего разговора. Чтобы удешевить этот ход, в Claude Code перед переключением запускают /compact или начинают новую сессию с коротким письменным планом, а в API открывают разговор с новой моделью выжимкой проделанной работы вместо полной истории.
С рассуждениями сложнее. Модель никогда не читает блоки размышлений модели уровнем выше, так что переход вниз теряет прежнее рассуждение. API в таком случае молча отбрасывает эти блоки, запрос проходит успешно, а новая модель работает без них. Переход с Fable 5.2 на любую другую общедоступную модель тоже сбрасывает её рассуждения.
Сабагент работает в своём контекстном окне, возвращает выжимку и тарифицируется по ценам своей модели. В Claude Code модель для него задаётся строкой model: haiku или model: sonnet в определении сабагента.
Дальше
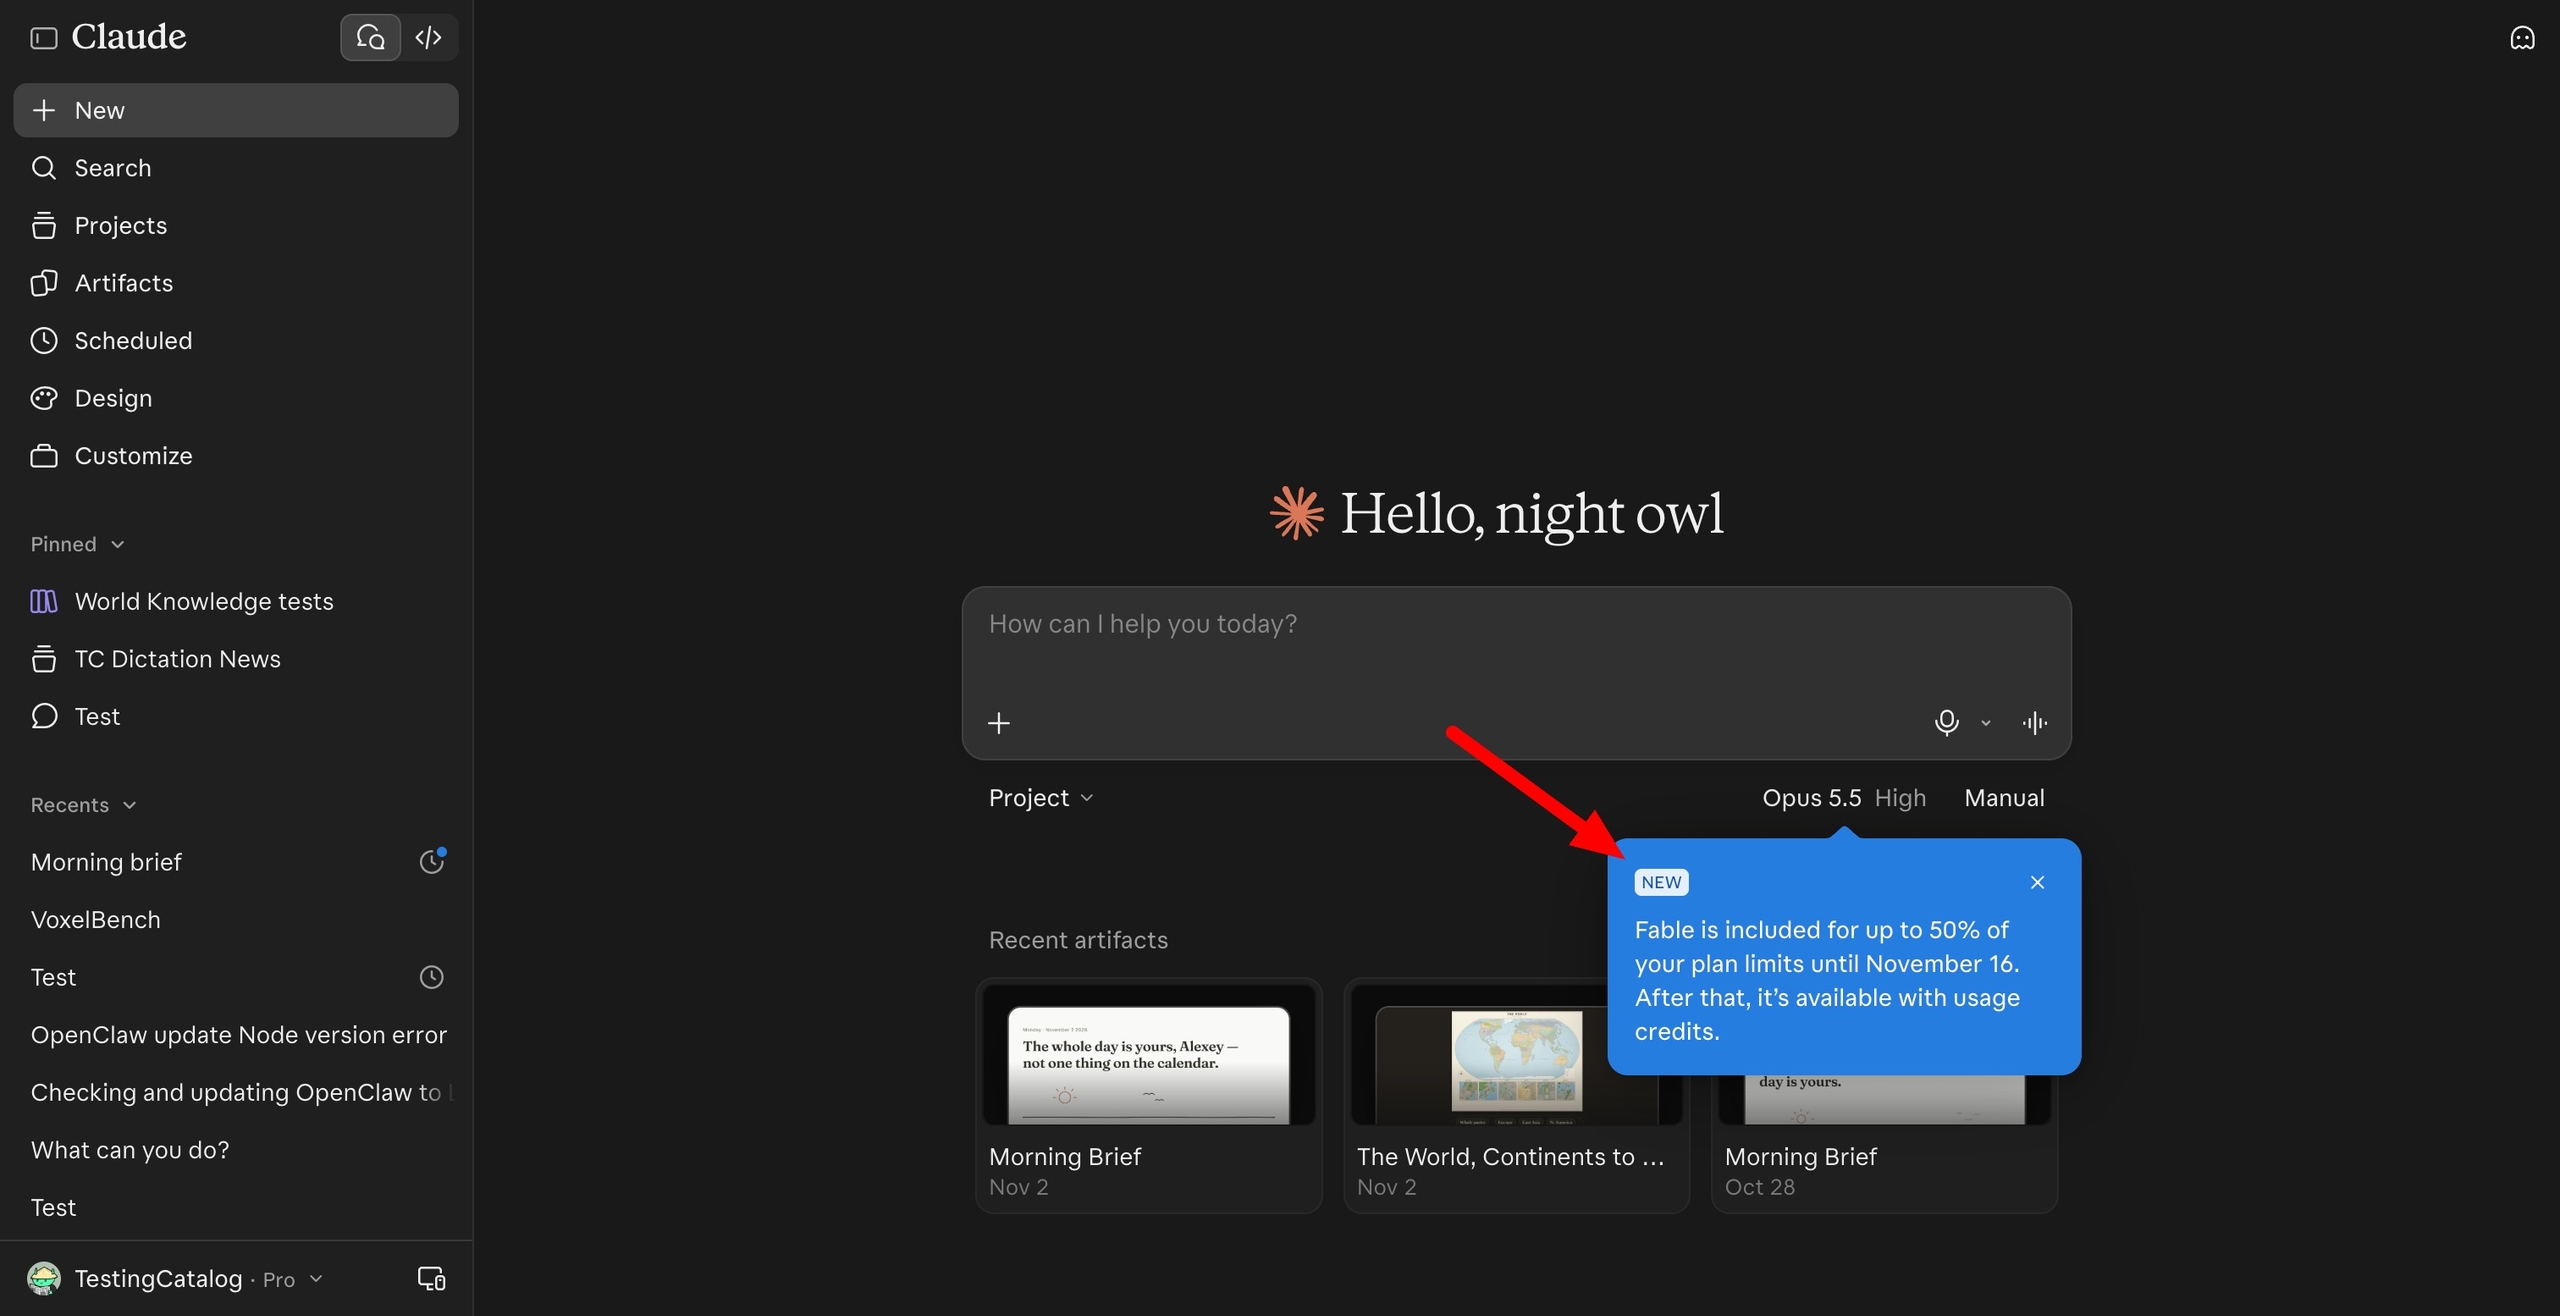
На Claude Pro модель Fable 5.2 входит в лимит до 16 ноября
Подписчики Pro сейчас гоняют Claude Fable 5.2 в счёт подписки, и модель может забрать до 50% недельного лимита. Окно закрывается 16 ноября, дальше Fable 5.2 доступна только через usage credits. Новую модель гоняете на лимите подписки или готовы докупать кредиты?
Читайте также
- Opus 5.5 стала моделью по умолчанию в Claude
- Fable 5.2 подешевела, но правка ходов в API даёт ошибку
- Opus 5.5 на уровне Fable 5.1, но на 40% дешевле Opus 5
- Fable 5.2 думает даже над приветствием на effort high
- Claude в Linear и Ramp можно оплачивать без API-ключа
- Claude API принимает запросы до 128 МБ вместо 32 МБ
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.