
Haiku 5.5 заметила утечку, которую пропустил GPT-6.1 Sol
Компания Surge AI, автор бенчмарка sudo L7, сравнила пять моделей: три Claude 5.5 и две GPT. Бенчмарк проверяет, справляются ли ИИ-агенты с работой старшего инженера. По замерам Surge, все три Claude, в том числе самая маленькая Haiku 5.5, набрали больше, чем GPT-6 Astra и GPT-6.1 Sol. Главный пример из разбора Surge, опубликованного 13 ноября, такой. Агентов попросили открыть второму клиенту функцию, которую компания недавно сделала для первого. Sol скопировал готовый код и доложил, что всё можно выкатывать. Haiku заметила то, что Sol пропустил: первая версия была сделана на скорую руку и только под одного клиента. Если просто её скопировать, первый клиент увидит конфиденциальные данные второго.
Рабочий код написали оба агента, но риск заметила только Haiku. Surge считает, что именно здесь сейчас проходит граница возможностей: писать правильный код модели уже умеют, а понимать, что на самом деле нужно пользователю, ещё учатся.
Что за тест
Большинство тестов для ИИ-программистов проверяют одно: может ли агент сделать задачу по готовому описанию так, чтобы прошли тесты. Surge называет это полезным, но недостаточным. Задачу можно выполнить ровно так, как просили, и всё равно навредить: в описании бывает ошибка, безобидная правка настроек может положить сервис.
В sudo L7, по описанию Surge, 60 задач, написанных профессиональными инженерами. Почти все они взяты из настоящего кода реальных компаний, и сформулированы так же расплывчато, как обычные рабочие просьбы: «Сделай быстрее», «Можно ли это безопасно закэшировать?». Ответы оценивают по восьми направлениям, от правильности кода до умения объяснить пользователю последствия его решений. Все модели работали на максимальных настройках рассуждения.
Где Claude сильнее
По правильности кода семьи моделей почти равны, пишет Surge. Разрыв появляется там, где от инженера ждут здравого смысла. В коде одного финтех-сервиса агентов попросили ускорить работу за счёт кэша, то есть хранить готовые ответы вместо того, чтобы каждый раз считать заново. В кэш предлагалось класть и данные счёта клиента, включая остаток. Тогда клиент мог бы пополнить счёт, спросить баланс и получить старую цифру. Все GPT это пропустили, все Claude предупредили.
В другой задаче нужно было исправить опечатку в настройках Terraform, инструмента, который описывает серверную инфраструктуру кодом. Sol исправил её и отчитался. Claude заметили, что из-за этой правки часть инфраструктуры будет удалена и создана заново, а пользователи на это время останутся без сервиса.
Самый большой разрыв Surge нашла в том, как агенты отчитываются. Итоговые отчёты Claude примерно в 10 раз длиннее, и в них есть риски и оговорки, которых нет у GPT. У GPT в целом меньше неверных утверждений, но в пересчёте на слово их примерно вчетверо больше.
Sol дешевле: 0,91 доллара за задачу против 1,68 у Haiku. Но Surge перечисляет его промахи: например, он пропускал повторные запросы, из-за чего деньги списывались дважды. По словам авторов, один пропущенный риск может съесть экономию от тысяч дешёвых прогонов.
Авторский разбор
Что мы проверили
17 ноября мы сверили текст поста Surge с его графиками и с таблицей лидеров sudo L7 на сайте компании.
Отрыв Haiku совсем небольшой. В тексте поста баллов нет, они есть только на главном графике: Sonnet 5.5 62,2%, Opus 5.5 57,9%, Haiku 5.5 49,3%, GPT-6 Astra 47,7%, GPT-6.1 Sol 47,4%. Получается, Haiku опережает Astra на 1,6 пункта, а Sol на 1,9. Что именно измеряет график, не подписано: по нашему выводу из подписи соседнего графика, это доля выполненных критериев оценки. Погрешности и числа прогонов в посте нет. В легенде графика Claude стоит рядом с Claude Code, а GPT рядом с Codex. Мы понимаем это так: каждая семья работала в фирменной оболочке своего разработчика, и сравнивались модель вместе с оболочкой. В тексте поста об этом ничего нет. А в другом эксперименте самой Surge, на другом наборе задач, одна только смена настроек запуска подняла оценку на 11,3 пункта.
Фраза «все Claude обошли GPT», которая была и в нашем коротком посте, верна только для трёх моделей 5.5 из сравнения. В таблице лидеров sudo L7, где считается доля полностью решённых задач, Claude Fable 5.1 с 32,2% стоит ниже GPT-6.1 Sol с 33,9%. Первое место там у Claude Fable 5.2 с 52,2%, но в сравнение она не вошла. Haiku 5.5 в таблице нет, и её долю решённых задач мы нигде не нашли.
Наконец, мы пересчитали отчёты целиком. Если отчёт Claude примерно в 10 раз длиннее, а ошибок на слово в нём примерно вчетверо меньше, то в одном отчёте Claude ошибок примерно в 2,4 раза больше, чем в отчёте GPT. Цифра приблизительная, потому что «в 10 раз» у Surge округлено.
Дальше
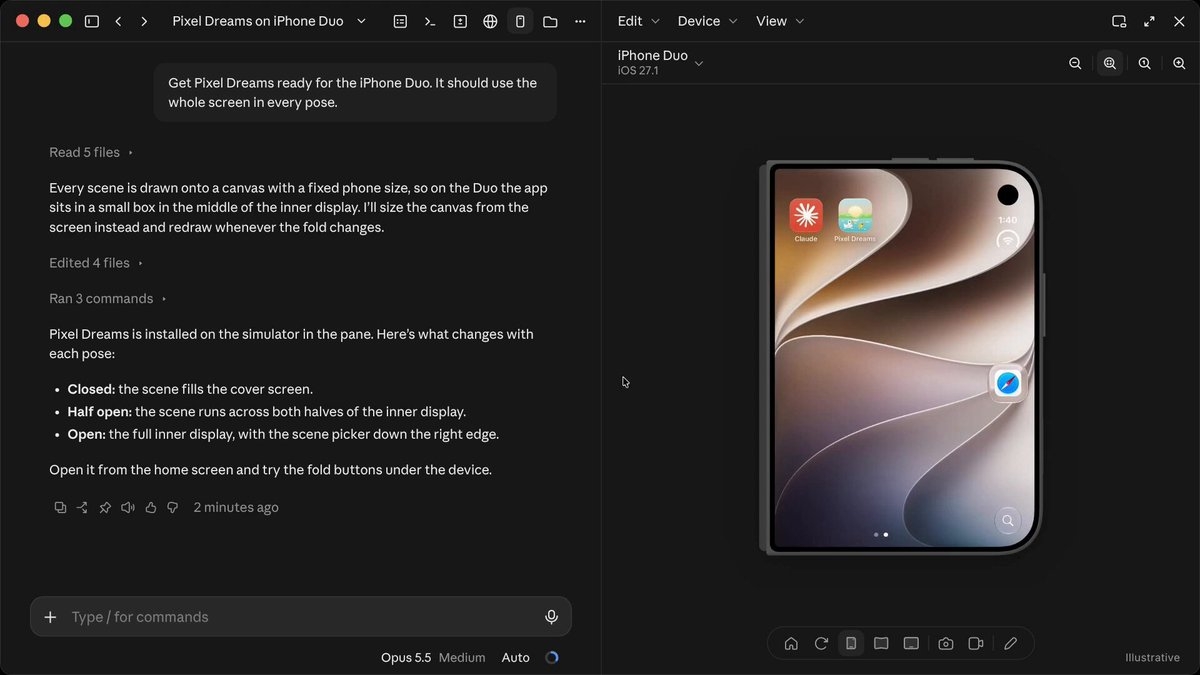
Claude Code научился складывать iPhone Duo в симуляторе, Видео
Claude Code на десктопе сгибает iPhone Duo в симуляторе на любой угол от 1 до 179 градусов и проверяет, как приложение выглядит сложенным, полураскрытым и открытым. Раскладку под разные экраны вы проверяете сами или отдаёте это ИИ?
Читайте также
- Fable 5.2 обошлась в 13,39 доллара против 3,99 у Astra
- Ответ Opus 5.5 стоил в 3,4 раза больше, чем у GPT-6 Sol
- Opus 5.5 обошёл GPT-6 Astra в тесте на стабильность
- Opus 5.5 обошёл GPT-6 Astra в индексе v5: 58 против 57
- В Vending-Bench GPT-6 Astra впервые обошёл Claude Fable 5.1
- GPT-6 Astra опередил Claude Fable 5.1 на 35 баллов
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.