
Fable 5.2 обошлась в 13,39 доллара против 3,99 у Astra
Claude Fable 5.2 стоит дешевле по прайсу, но на трёх задачах по коду обошлась в 13,39 доллара против 3,99 у GPT-6 Astra. Такую оценку дал автор The New Stack, который прогнал обе модели через API и описал результаты 14 ноября. Если ваша работа похожа на исправление багов и написание кода с нуля, Astra набрала в этих задачах те же баллы примерно за 41% оценочной стоимости Fable, а Fable 5.2 вышла вперёд только на ревью кода: 49 баллов из 50 против 45.
Замер узкий: каждая модель прошла каждую задачу один раз на настройках по умолчанию, ответы оценивал скрипт, а стоимость автор считал сам. Он же предупреждает, что разрыв в четыре балла на другом прогоне может сдвинуться. По сумме трёх задач у Fable 5.2 149 баллов из 150, у Astra 145, а времени Fable потратила 2 157 секунд против 832.
Куда уходят токены
Прайс у Fable 5.2 такой: 8 долларов за миллион некэшированных входных токенов и 40 за миллион выходных. У Astra, которую OpenAI выпустила в сентябре, 10 и 50. Но в тесте The New Stack Fable 5.2 прочитала 4 400 139 токенов и выдала 226 917, а Astra 884 143 и 39 494, примерно в пять раз меньше. Обе компании берут за токены рассуждений (скрытый ход мысли модели перед ответом) по выходной ставке, поэтому лишние размышления сразу попадают в самую дорогую строку счёта.
На исправлении багов автор подбросил 10 ошибок в биллинговый код на 2 600 строк, причём тикет с жалобами клиентов указывал на неверные причины, а два теста в самом коде были ошибочными. Обе модели закрыли все 10 ошибок, прошли 50 скрытых проверок и уложились в 12 ходов. При этом Fable 5.2 израсходовала 17 387 токенов рассуждений, 326 секунд и около 2,51 доллара, а Astra всего 819 токенов рассуждений, 122 секунды и около 98 центов.
На написании кода с нуля (проверка номеров плательщика НДС для 27 стран, IBAN для 34 стран, платёжный календарь, длинные даты) обе модели набрали 50 из 50 без сторонних библиотек и почти за одинаковое число ходов: 24 у Fable 5.2 и 23 у Astra. По подсчёту автора, Fable всё равно вышла в 2,3 раза дороже, 4,83 доллара против 2,06, и работала в 1,7 раза дольше.
Президент OpenAI Грег Брокман на запуске Astra говорил: «Значение имеет цена за задачу». На двух задачах с ничейным счётом в этом тесте Fable 5.2 обошлась в 7,34 доллара, Astra в 3,04.
Ревью кода
Единственная задача с разными баллами - ревью пакета для выставления счетов в ЕС, куда автор The New Stack заложил 45 дефектов: в проверках номеров НДС для 27 стран, правилах IBAN, платёжном календаре Европейского центрального банка и форматах дат для 50 локалей. Каждый дефект модель должна была доказать входными данными, на которых код ошибается, и назвать правильный ответ, а за ложные тревоги снимали баллы.
Fable 5.2 доказала 44 дефекта из 45 и не подняла ни одной ложной тревоги на 71 находку. Astra в этом прогоне доказала 41, пропустила ошибки в правилах контрольных цифр для Испании, Ирландии и Люксембурга и один испанский номер ошибочно признала валидным. Обе модели споткнулись на одном и том же испанском дефекте: две переставленные буквы в таблице из 23 букв.
За эту дотошность Fable 5.2 заплатила 6,05 доллара против 0,95 у Astra, 993 секунды против 227 и 26 ходов против 12. Автор рассуждает так: если ваш код работает со счетами, одно пропущенное правило валидации может привести к тому, что реальные счета отклонят, и тогда четыре лишних балла Fable могут оправдать цену. Для рутинного ревью, по его подсчёту, Astra нашла 91% дефектов за 16% стоимости.
При чём тут effort
По умолчанию Fable 5.2 в Claude API работает на effort High, и на нём в собственных замерах Anthropic она набирает 45,3% на FrontierCode 2.0. В анонсе от 9 ноября компания выносила вперёд другую цифру, 49,1% против 42,8% у Astra, но она получена на X high. На FrontierSWE v2 у Anthropic 69,9% против 65,5% у Astra. Все эти результаты - собственные оценки Anthropic, а не независимый аудит, отмечает Lumien.
На high и выше Fable 5.2 думает почти перед каждым ответом, даже перед приветствием, и гайд Anthropic советует понижать effort для лёгких запросов. Тест The New Stack шёл как раз на дефолтном уровне.
Похожую картину внутри самой линейки описывает CloudZero: токены Fable 5.2 подешевели на 20% относительно Fable 5.1 с её 10 и 50 долларами, но на максимальном effort независимые тесты, по словам компании, дают Fable 5.2 примерно вдвое большую цену за задачу, чем у Fable 5.1.
Сама Anthropic советует большинству пользователей начинать с Claude Opus 5.5 для большинства задач по коду и работе со знаниями, а Fable и Mythos позиционирует для самой амбициозной открытой технической работы.
Дальше
OpenAIОткрытые моделиразбор
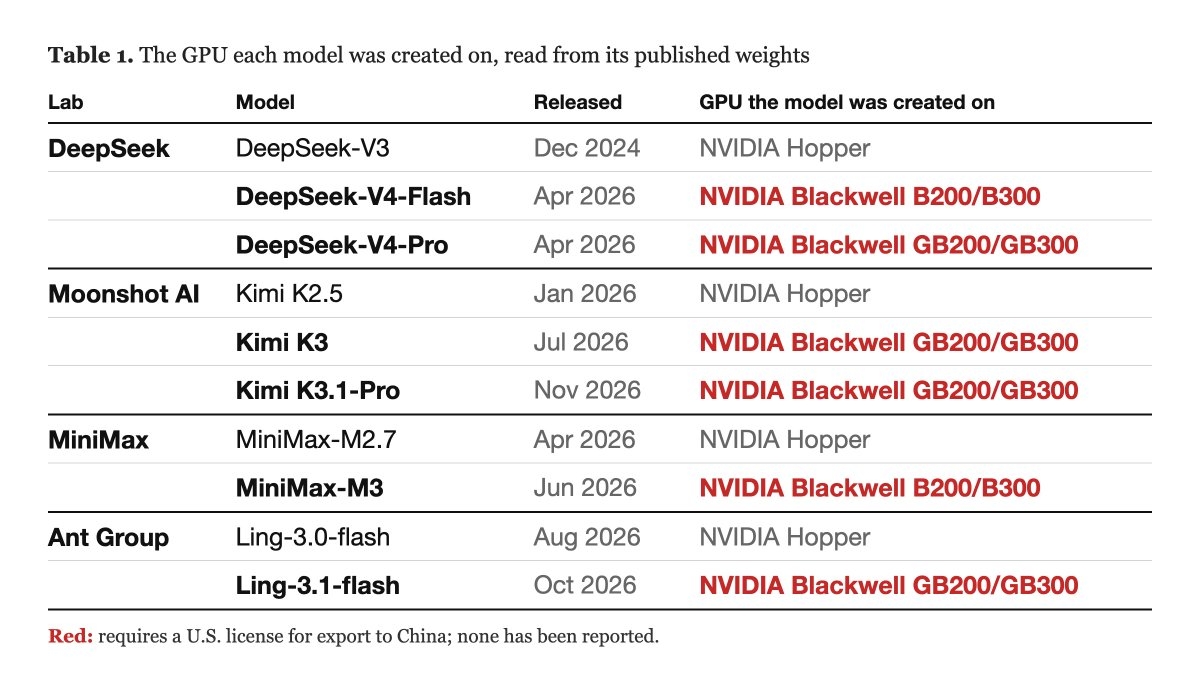
Веса моделей DeepSeek и Kimi указали на чипы Blackwell
Исследователь берёт опубликованные веса DeepSeek-V4-Flash, подбирает зерно и чип, и Blackwell B300 повторяет их стартовые значения бит в бит. По отчёту Unemployment Labs, такой след нашёлся в шести китайских моделях. Зная, что веса выдают железо, вы бы выкладывали модель открыто или держали закрытой?
Читайте также
- Haiku 5.5 заметила утечку, которую пропустил GPT-6.1 Sol
- В Vending-Bench GPT-6 Astra впервые обошёл Claude Fable 5.1
- Ответ Opus 5.5 стоил в 3,4 раза больше, чем у GPT-6 Sol
- Fable 5.2 думает даже над приветствием на effort high
- Fable 5.2 подешевела, но правка ходов в API даёт ошибку
- На Claude Pro модель Fable 5.2 входит в лимит до 16 ноября
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.