
lcc сжимает сессии Claude Code, не пересказывая их
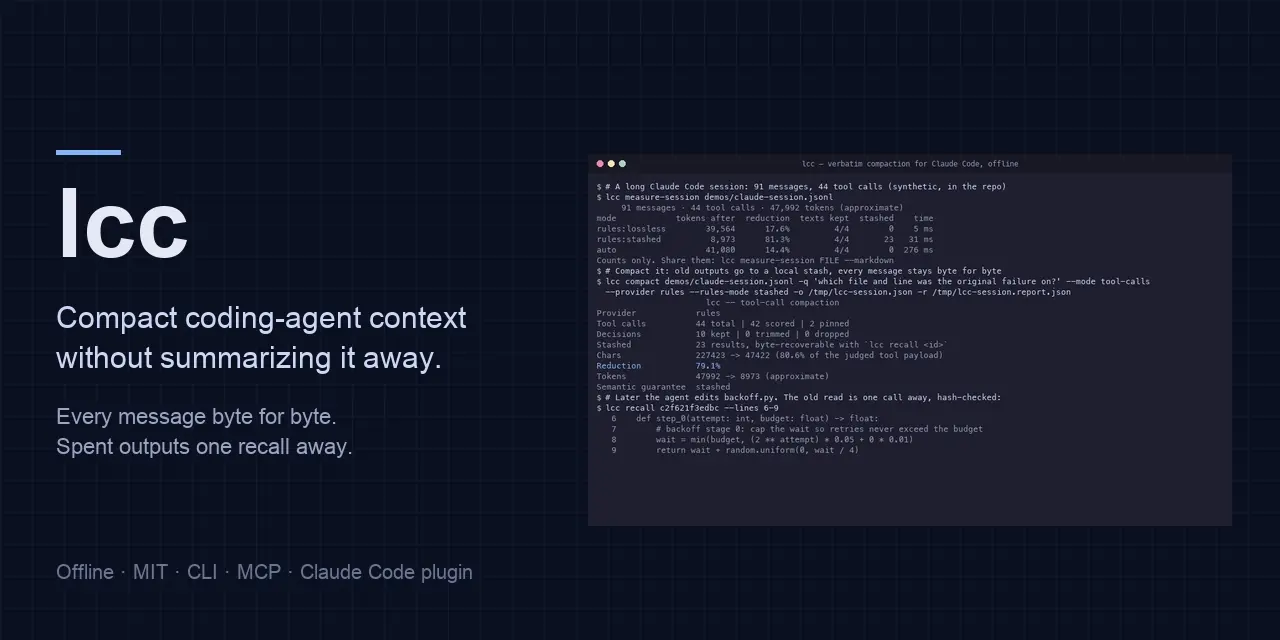
Автор утилиты lcc 23 октября выложил на Hacker News способ сжимать сессии Claude Code без пересказа: старые выводы инструментов уходят из контекста в локальное хранилище, а сообщения пользователя и ассистента остаются байт в байт. Если вы собираетесь поставить её вместо штатного /compact, сначала прогоните офлайн-замер на своих сессиях: на 299 длинных сессиях автора медиана сокращения всего 21,8%, а когда выигрыш меньше 25%, плагин сам отдаёт работу встроенному резюме.
Механика описана в README проекта на GitHub. Штатное сжатие заменяет историю резюме, которое пишет модель, и Anthropic в руководстве по сессиям описывает автосжатие так же: у края окна задача сводится к короткому описанию, и модель продолжает в новом окне. Резюме, по словам автора lcc, теряют «ту самую ошибку, путь или строку, которые понадобятся агенту через два хода». На месте убранного вывода lcc оставляет метку вида [removed: 120 lines, 4.3 KB · lcc recall <id>], а сам вывод кладёт в ~/.cache/lcc/stash, где каждый файл назван по хешу своего содержимого. Вызов recall возвращает его и при чтении сверяет хеш.
Пример в README: сессия из 193 сообщений и 75 вызовов инструментов сжалась с 57 083 до 28 807 токенов (-49,5%), 33 вывода ушли в хранилище, все 43 сообщения пользователя и ассистента на месте. Сам автор называет её одним из лучших случаев. По всем его сессиям от 100 сообщений (36,3 млн токенов) средняя половина результатов легла в 15-31%, лучший дал 65%, потерянных сообщений ноль.
Замер на своих сессиях
Замер ничего не меняет и никуда не отправляет. Вторая команда берёт вашу последнюю сессию Claude Code, прогоняет все режимы офлайн и печатает только счётчики: сообщения, вызовы инструментов, токены до и после, сколько сообщений сохранилось, время.
pip install "local-context-compiler[tiktoken]"
lcc measure-session "$(ls -t ~/.claude/projects/*/*.jsonl | head -1)"
Пакет на PyPI называется local-context-compiler, пакет с именем lcc к проекту отношения не имеет. Для точного счёта токенизатор o200k_base нужно один раз закэшировать командой python -c "import tiktoken; tiktoken.get_encoding('o200k_base')": сам lcc ничего не скачивает, а без кэша отчёт помечает цифры как приблизительные. Если передать каталог проекта целиком, вы получите медиану и p90 сокращения по каждому режиму, а выгрузки Codex CLI распознаются автоматически. Флаг --input-map показывает, куда уходит оплачиваемый вход: чтение и запись кэша, доля результатов инструментов, системного промпта и схем инструментов. «Это все мои сессии: прогоните на своих и выложите результат», - просит автор и собирает отчёты в Discussions → Results.
Плагин встаёт на место резюме /compact. Ставится он командами claude plugin marketplace add lucasmartins-ai/lcc и claude plugin install lcc@lcc --config provider=rules --config rulesMode=stashed, а агенту нужно разрешить инструмент mcp__plugin_lcc_lcc__recall, иначе он не достанет убранный вывод. Когда проход падает или убирает слишком мало, плагин передаёт работу встроенному резюме и сообщает об этом всплывающим уведомлением. Для Cursor, Claude Desktop и любого stdio-клиента есть MCP-сервер lcc mcp с инструментами compact, recall, explain и другими.
73 и 98 процентов
Главный довод README - тест на 172 реальных запросах, протокол которого зафиксировали заранее. На вопросах, где нужно вспомнить содержимое файлов, агент со сжатым контекстом и recall показал разницу +0,006 с полным контекстом (95-процентный доверительный интервал от -0,023 до +0,034), а контекста потратил на 36,6% меньше. Про убранное содержимое он вызывал recall в 90% вопросов.
Резюме в стиле /compact на тех же сессиях дало 73% верных точных значений, полный дословный контекст - 98%. Как читать эту пару, видно из протокола, его мы разобрали ниже.
Чего lcc не гарантирует
Проверки, что модель ответит правильно, lcc не делает: структурный PASS в отчёте ничего не говорит о качестве ответа. Правила защиты и ограниченное восстановление, по словам автора, снижают риск потерять нужное, но не исключают его. Ранжировщик specialist-v3, который выбирается по умолчанию для транскриптов, обучен на транскриптах Claude Code, и сессии других агентов и обычные документы для него вне обучающих данных; простой текст по умолчанию идёт через mechanical. Удалённый судья Jev отправляет цель и блоки контекста в TypeSafe API и включается только явно: наличие ключа автор согласием на отправку не считает.
Авторский разбор
Что мы проверили
25 октября мы прочитали код и документацию репозитория, сверили релизы на PyPI, попробовали поставить пакет на Python 3.10 и сопоставили требования плагина с документацией Claude Code и реестром npm.
Сравнение с резюме сделано при куда более жёстком сжатии, чем даёт lcc, а тест показывает неухудшение в пределах допуска, без доказательства равенства. Флаг из инструкции к плагину на свежем Claude Code не нужен, зато нужен Python не старше 3.11.
- Тест проверял неухудшение с допуском -0,05, и интервал от -0,023 до +0,034 в него укладывается. README же пишет, что агент справился так же, как с полным контекстом.
- Резюме в стиле /compact - собственная реализация авторов, написанная Claude Opus 5.5, а не сжатие самого Claude Code. По странице протокола, у него было 0,98 млн токенов контекста против 9,41 млн у полного: примерно 90-процентное сокращение против 36,6% у lcc. Сырые данные закрыты, ссылки на публичную запись протокола мы не нашли.
- README требует Claude Code 2.1.274+ и
export CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1. По документации Claude Code, с v2.1.287 mods включены по умолчанию, а флаг игнорируется, так что реальный минимум - 2.1.287. Событие session.compact, на котором стоит плагин, всё ещё помечено как ранний доступ и может меняться между релизами без предупреждения. - Все релизы пакета требуют Python 3.11+, а на 3.10 pip отвечает только «from versions: none».
- Порог 25%, по коду и документации (без замера), в библиотеке лишь помечает проход и байты не меняет. К встроенному резюме переключает плагин, с уведомлением вроде
lcc: built-in summary (below the 25% minimum (4.2%)). - По коду, без прогона: recall сверяет SHA-256 и при несовпадении байты не отдаёт, а режим auto выбирает удалённый Jev только при
LCC_AUTO_REMOTE=1и безLCC_DISABLE_NETWORK=1.
Дальше
ClaudeОткрытые моделиразбор
Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
«По замыслу ниже того, что способен выдать наш конвейер»: так Kimi описывает хакерские навыки открытой K3.1 Pro. Без чистки данных модель решала 90,5% задач на взлом, после неё 81,0%. Вы бы выложили такую модель в открытый доступ или оставили бы её только за API?
Читайте также
- Tokendoctor обещает тот же Claude Code до 38% дешевле
- С плагином catnap Claude Code сжимает контекст после задачи
- Память и навыки Claude Code получили git-историю в memsaga
- intent-lens объясняет команды Claude Code до их запуска
- Codedict срезал токены Claude Code на 63%, а счёт на 26%
- Дерево файлов покажет, что читает и правит Claude Code
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.