
Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
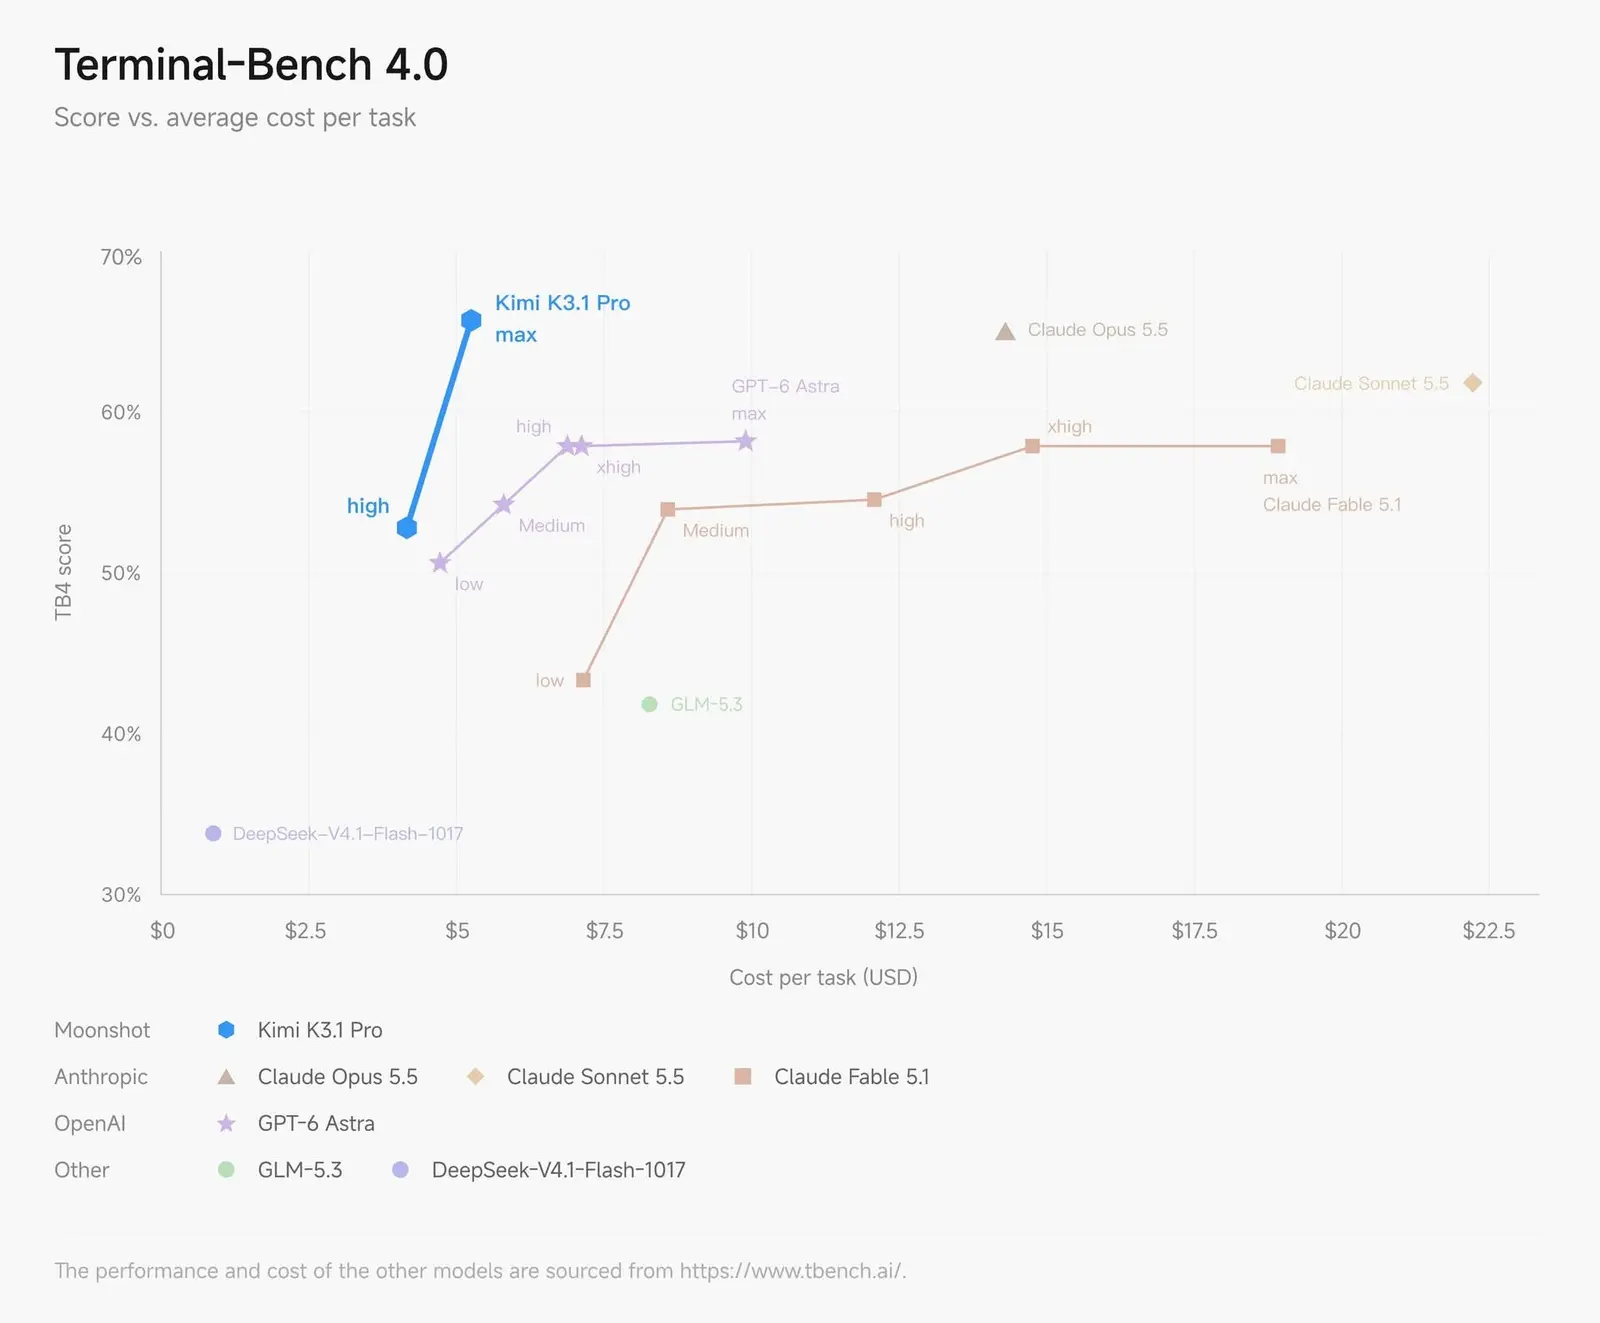
K3.1 Pro, которую Kimi открыла 23 октября, стоит в API 2 доллара за миллион входных токенов и 10 долларов за миллион выходных, вдвое меньше, чем у Claude Opus 5.5 по прайсу Anthropic, а по тестам из анонса Kimi идёт с ним почти вровень. Ускоренная Highspeed, в 2-3 раза быстрее базовой версии, по прайсу совпадает с Opus 5.5, а паритет держится на таблице самой Kimi, где из 42 общих с Opus 5.5 тестов K3.1 Pro выигрывает 21 и столько же проигрывает. Открытые веса Kimi обещает выложить до 4 ноября.
K3.1 Pro - дообученная версия Kimi K3, модели класса 3T с 2,8 трлн параметров, из которых на каждый токен работают 104 млрд. Контекст у неё 1 миллион токенов, а дообучение Kimi провела с заметно большим бюджетом вычислений, чем у K3, обучая модель с подкреплением сразу в сотнях прикладных областей. Модель доступна в Kimi.ai и мобильных приложениях Kimi, в Kimi Work, Kimi Code и через Kimi API.
Две версии и их цены
В API модели называются kimi-k3.1-pro и kimi-k3.1-pro-highspeed. Вторая стоит 4 доллара за миллион входных токенов и 20 за выходные, и те же цифры у Opus 5.5 в прайсе Anthropic. Чтение из кэша у обеих версий Kimi и у Opus 5.5 одинаковое, 0,20 доллара за миллион токенов. GPT-6 Astra в стандартном тарифе OpenAI обходится в 10 долларов на входе, 50 на выходе и 1 доллар за кэш, впятеро дороже kimi-k3.1-pro по всем трём статьям.
Сама K3 16 июля вышла в API по 3 доллара за миллион входных токенов и 15 за выходные, и K3.1 Pro по прайсу дешевле предшественницы на старте. Всё это цены за токен, и стоимость задачи зависит от того, сколько токенов модель на неё потратит.
В Kimi Code модель выбирается командой /model, для Kimi Work нужна версия 3.1.0 или новее под Windows или Mac на Apple silicon. Клиентам API доступен режим Zero Data Retention. В Kimi Enterprise K3.1 Pro на старте выключена, и включает её для организации администратор.
Тесты из анонса
Все результаты K3.1 Pro в анонсе получены на максимальном уровне рассуждений. На Terminal-Bench 4.0, где агентов проверяют реальными задачами в терминале с ограниченными ресурсами и строгими тестами, модель в обвязке Claude Code набрала 65,7%, а Opus 5.5 и GPT-6 Astra у Kimi записаны с 66,4% и 58,2%. На внутреннем Kimi Code Bench 3.0 Long-horizon, где агент решает многошаговые инженерные задачи с инструментами, K3.1 Pro поднялась до 61,2% с 55,95% у K3.
В финансах Kimi заявляет лучший результат на OfficeQA Pro v2, 64,4, а на внутреннем стресс-тесте Kimi Hallu Bench Hard доля выдуманных утверждений в ответах снизилась с 23,4% у K3 до 8,3%. Примеры для этого теста, как оговаривает сама Kimi, подобраны под ситуации, где модели склонны ошибаться, и эти доли не равны частоте ошибок в обычной работе.
Что вычистили перед открытыми весами
Для открытого релиза Kimi убрала данные о кибербезопасности из двух этапов обучения, из mid-training, промежуточного этапа на большом общем корпусе, и из набора сред для обучения с подкреплением, оставив общие задачи по программированию. Такие данные попадали туда попутно, вместе с широким корпусом, и в предварительных опытах на внутренних моделях без их удаления атакующие навыки заметно росли.
Эффект Kimi измеряла на собственном xdev-bench-hard. Большинство его задач воспроизводит недавно раскрытые уязвимости в ядре Linux, Node.js, JavaScriptCore, Exim и VirGL с включёнными защитами, и агент должен написать эксплойт, выполнить произвольный код в отдельной песочнице и достать секретную строку. Чекпойнт без чистки решает 90,5% задач с трёх попыток, итоговая K3.1 Pro 81,0%. При этом она заметно сильнее предшественницы, и Kimi объясняет это тем, что общие навыки кода и долгой отладки переносятся на атаки и после чистки.
По словам Kimi, по атакующим возможностям K3.1 Pro уступает передовым закрытым моделям, которые публично доступны хотя бы три месяца. Компания обещает не выкладывать открытые веса, которые раздвигают абсолютную границу таких возможностей, и поднимать их уровень в открытом доступе постепенно.
Авторский разбор
Что мы проверили
24 октября мы разобрали таблицу из 47 тестов и шести моделей со страницы анонса, сверили Terminal-Bench 4.0 с официальным лидербордом, сравнили прайсы трёх компаний и посчитали объём весов K3 на Hugging Face.
Уровень Opus 5.5 и GPT-6 Astra таблица Kimi подтверждает по общему счёту и сужает по разделам. Лучшей из шести моделей K3.1 Pro бывает в основном в агентных тестах, а при половине цены Opus 5.5 отстаёт от него больше чем на 20 пунктов в ProgramBench, HLE-Diamond и Terminal-Bench Science. Отставание на Terminal-Bench 4.0 из анонса по официальному лидерборду оборачивается перевесом в пределах погрешности, хотя K3.1 Pro в этом рейтинге нет.
K3.1 Pro лучшая или делит первое место в 16 тестах из 47, из них в 13 из 25 агентных и в 2 из 10 кодинговых. Против GPT-6 Astra счёт 23 на 19 по 42 общим тестам. На внутреннем Kimi Code Bench 3.0 Long-horizon у GPT-6 Astra 66,5 против 61,2 у K3.1 Pro.
| Тест | K3.1 Pro (max) | Opus 5.5 (max, with fallback) | GPT-6 Astra (max, with fallback) |
|---|---|---|---|
| ProgramBench | 31,5 | 65,0 | 50,0 |
| HLE-Diamond | 39,4 | 60,9 | 65,8 |
| Terminal-Bench Science 0.1 | 38,1 | 63,3 | 68,1 |
| ExploitBench | 74,7 | 91,0 | 100 |
| ExploitGym | 20,7 | 34,5 | 42,4 |
На лидерборде Terminal-Bench 4.0 у Opus 5.5 (max, Claude Code) 64,8% ± 3,1%, у GPT-6 Astra (max, Codex) 58,2% ± 2,8%, а K3.1 Pro в нём нет. Свои 66,4% для Opus 5.5 Kimi взяла как максимум из блога разработчика и лидерборда. Заявленные без доверительного интервала 65,7% K3.1 Pro на 0,9 пункта выше строки Opus 5.5, в пределах её погрешности.
Если запускать у себя
До выхода весов K3.1 Pro ориентиром служат веса K3, дообученной версией которой Kimi называет новую модель. Такая оценка идёт по документации, не по замеру, и формат файлов K3.1 Pro можно будет проверить только после публикации.
Веса K3 на Hugging Face занимают 1,56 ТБ в 96 файлах, в 4-битном формате MXFP4 с частью слоёв в bf16, в среднем 4,46 бита на параметр. Одни только веса не помещаются ни в узел из восьми H200 с 1,13 ТБ памяти, ни в узел из восьми B200 по 180 ГБ с 1,44 ТБ, а в восемь B300 или GB300 с 2,30 ТБ помещаются.
Рецепт vLLM для K3 требует как минимум восемь GB300 и несколько узлов под реальный рабочий трафик, а в таблице SGLang для B300 хватает одного узла на восемь GPU, для B200 и H200 нужно по два таких узла, для H100 четыре.
Дальше
OpenAIБезопасность ИИразбор
OpenAI нашла в Brotli дыру с удалённым выполнением кода
Февральская правка в исходниках Brotli, по словам OpenAI, закрыла ошибку, которую тогда никто не счёл уязвимостью, и релиза не вышло. Через неё подделанные сжатые данные дают выполнить чужой код в Node.js, Bun и Envoy без авторизации. Сколько дней у вас проходит от выхода патча Node.js до деплоя в прод?
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.