
ARC-AGI-3 пройден целиком, 100,00 балла RHAE
Кодинг-агент общего назначения NVIDIA AVO прошёл все 183 уровня в 25 средах ARC-AGI-3 и набрал 100,00 балла RHAE, сообщила NVIDIA 21 августа в блоге для разработчиков (цитату из него приводит публикация в Threads). В марте, на старте бенчмарка, передовые модели набирали на нём меньше процента.
Две предыдущие версии ARC-AGI были статичными головоломками на сетке: на входе картинка, на выходе картинка. В третьей агента помещают в пошаговые игры, которые вручную собрали геймдизайнеры, и не дают ему ни инструкций, ни правил, ни цели. Агент сам исследует среду, выясняет, как она устроена и что считается победой, и переносит выученное на следующие уровни, каждый сложнее предыдущего. Простого «прошёл или не прошёл» здесь нет: счёт зависит от того, сколько действий агент потратил по сравнению с человеком, а блуждание, откаты и перебор вариантов штрафуются. Человеческую базу собрали заранее: за период предварительного доступа больше 1 200 игроков сыграли больше 3 900 партий, говорится в статье авторов бенчмарка.
Поэтому вторая цифра NVIDIA весит не меньше первой: AVO обошёлся на 12% меньшим числом действий в средах, чем VISTA. Для сравнения, базовый результат Claude Opus 5 на ARC-AGI-3 около 30%.
От запуска до полного прохождения прошло меньше пяти месяцев:
- 29 января: вышел инструментарий для разработчиков. Среды запускаются локально со скоростью до 2 000 кадров в секунду, пакет
arc-agiставится через pip, лицензия MIT, нужен API-ключ ARC. - 24 марта: статья с описанием ARC-AGI-3 появилась на arXiv, вторая версия вышла 17 апреля.
- 25 марта: бенчмарк и конкурс ARC Prize 2026 представили в штаб-квартире Y Combinator в Сан-Франциско, на сцене беседовали Франсуа Шолле и Сэм Альтман. Призовой фонд превышает 2 миллиона долларов, в него входит соревнование на Kaggle, где участники собирают агентов для этих игр. В анонсе ARC Prize стояло: «Люди набирают 100%. Передовой ИИ - 0,51%».
- 21 августа: NVIDIA сообщила о 100,00 балла у AVO.
При этом ARC Prize описывает ARC-AGI-3 как сотни оригинальных сред, а зачёт AVO собран на 25 из них.
Главный спор вокруг ARC-AGI-3 до AVO шёл про обвязку вокруг модели. Слабые результаты GPT-5.6 Sol на бенчмарке OpenAI объясняла тем, что обвязка для запуска не давала модели помнить уже выученное. После включения двух настроек Responses API, сохранения рассуждений между ходами и сжатия контекста, результат вырос втрое, а выходных токенов уходило вшестеро меньше. AVO построен вокруг того же: памяти и обратной связи от исполнения.
В NVIDIA цикл агента описывают так: AVO «непрерывно изучает задачу, планирует, реализует и оценивает результат, используя память, инструменты и обратную связь от исполнения, чтобы развивать то, чему научился по ходу».
Дальше
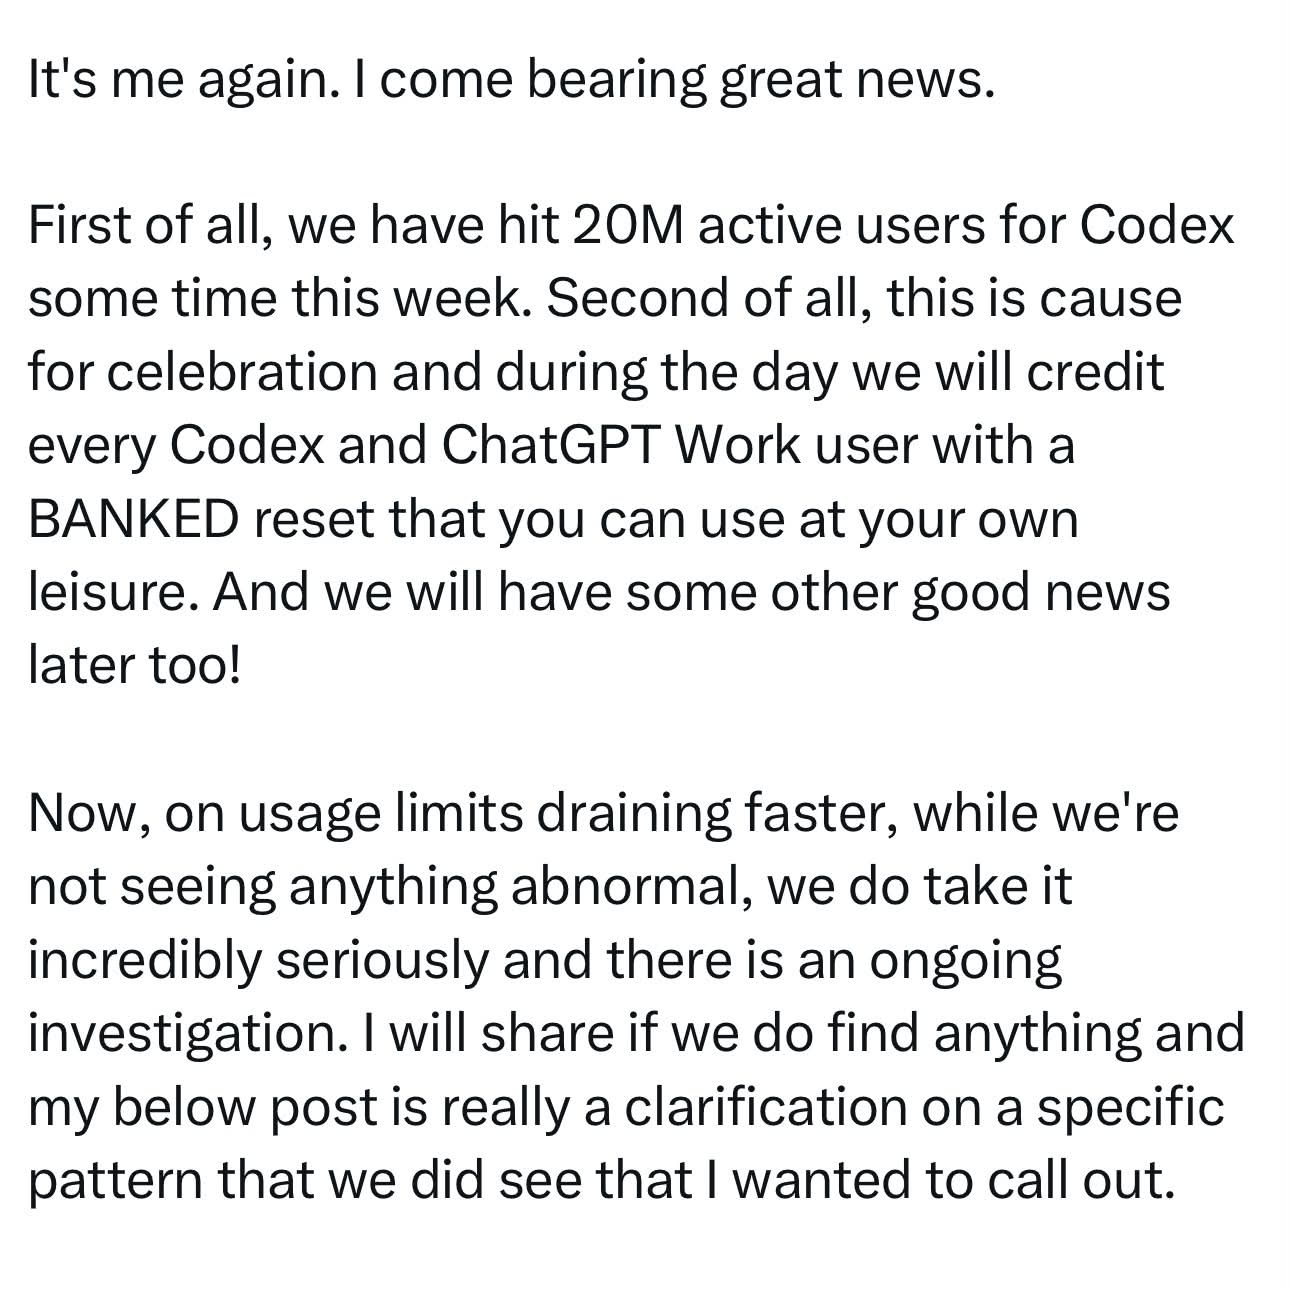
Сброс лимитов обещают под цифру в 20 миллионов
«Codex hit 20M active users milestone», говорится в посте о сбросе лимитов сегодня для пользователей ChatGPT Work и Codex. Подтверждений цифре нет, последняя проверяемая отметка держится на 15 миллионах от 13 августа.
Читайте также
- 73% на OSWorld 2.0 и две трети цены конкурентов
- Открытая обвязка на Strands и 99,95% у Claude Opus 5
- Две настройки API утроили результат GPT-5.6 на ARC-AGI-3
- Две настройки API утроили результат на ARC-AGI-3
- PR от Claude принимают в 84% случаев, от Devin в 43%
- Ревью Claude подняло решения Codex с 71,6% до 89,7%
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.