
Текст Opus 5 вычисляют подсчётом четвёрок букв
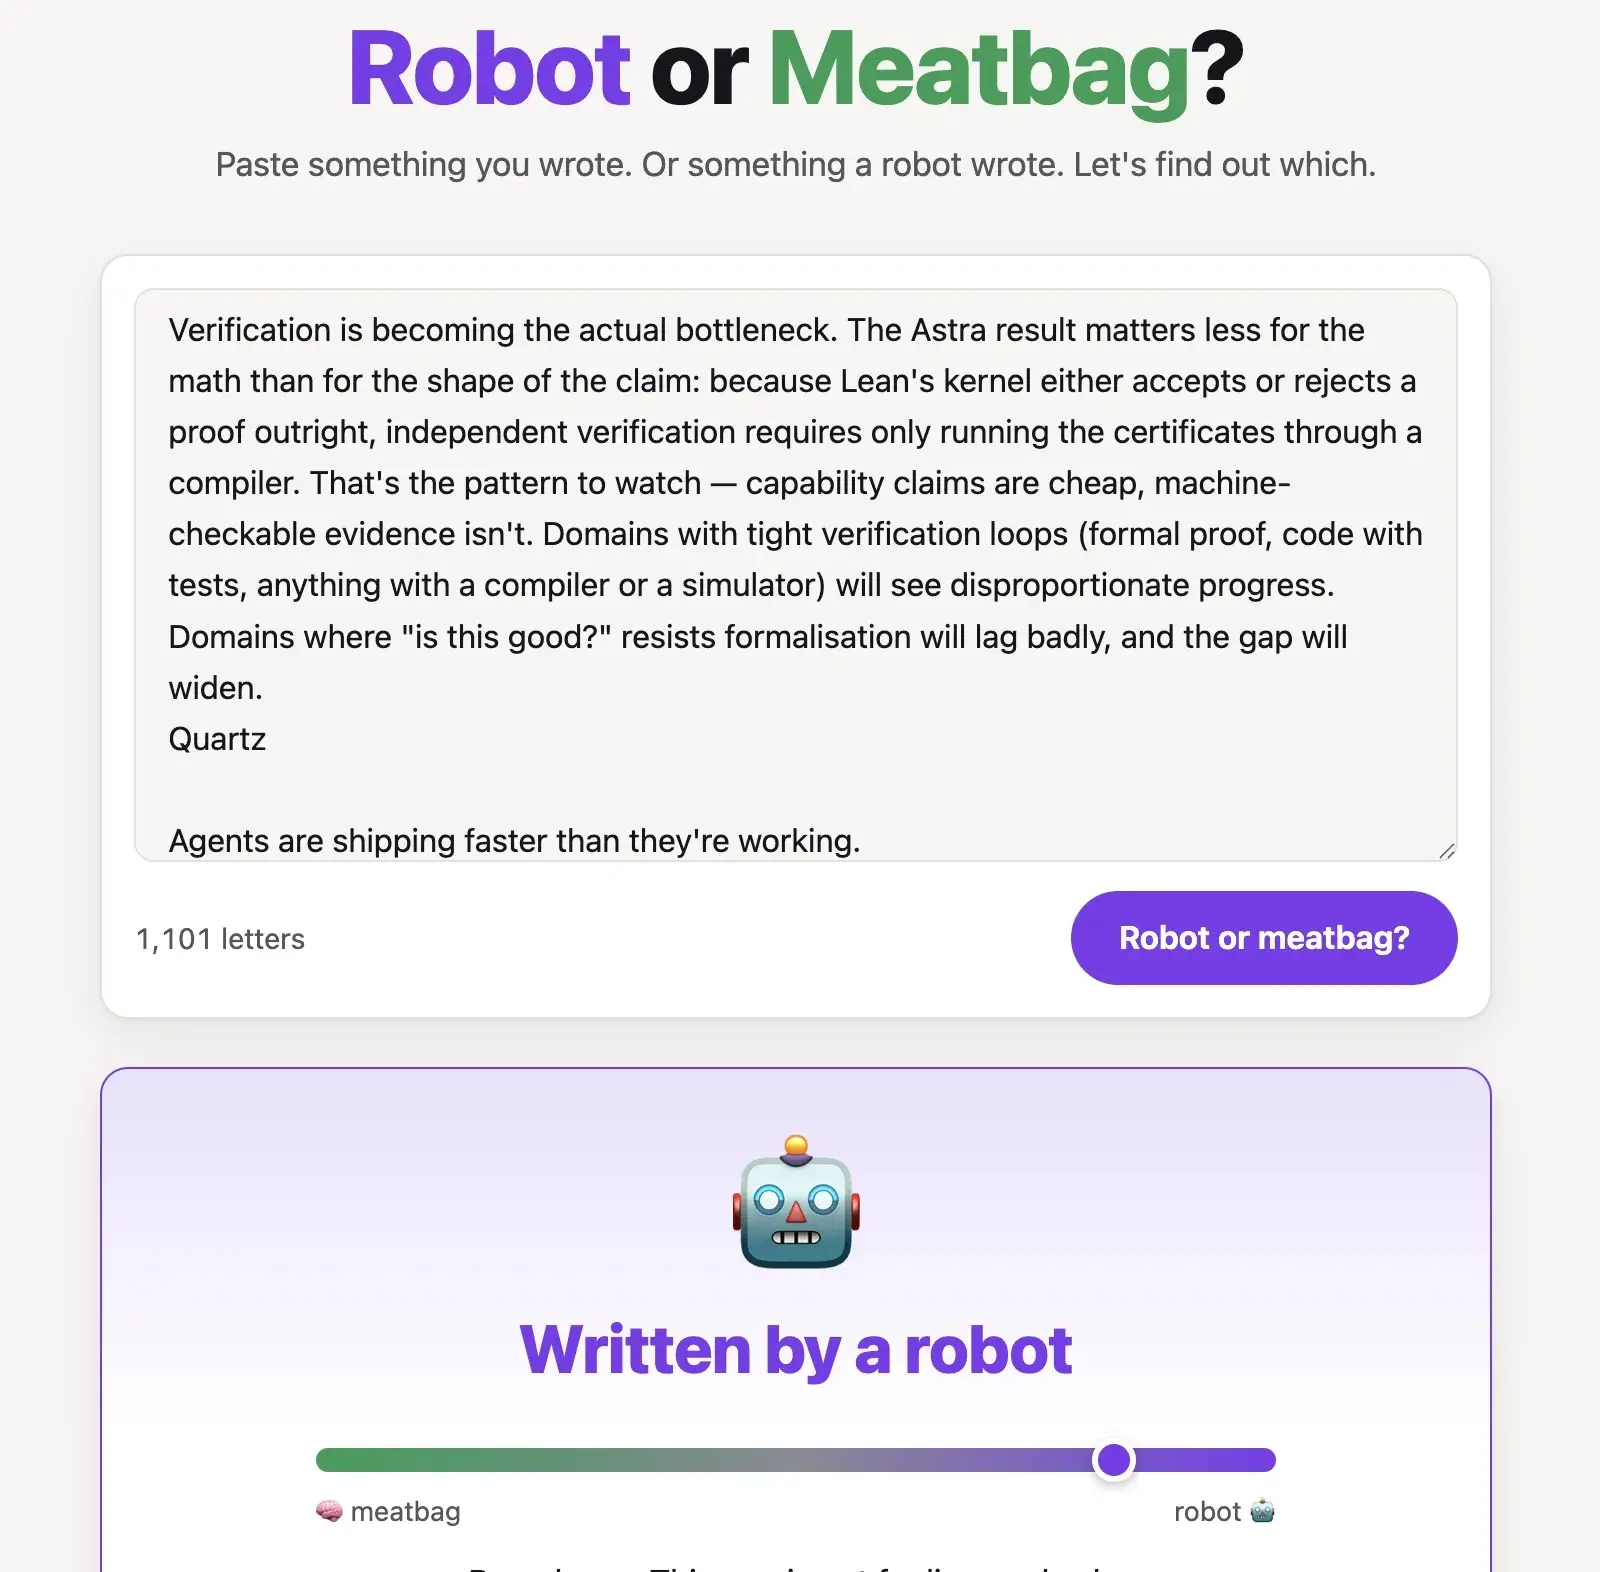
Автор блога Atomic14 собрал детектор текстов Claude Opus 5, которому не нужен ключ Anthropic. Детектор не читает слов. Он считает, как часто в тексте встречаются цепочки из четырёх букв, и по этим долям отделяет человека от Claude: на авторах, которых модель ни разу не видела, ROC AUC выходит 0,925. Разбор с цифрами и рабочей веб-версией вышел в посте Atomic14 от 18 августа.
Поводом стал водяной знак, который Anthropic со 2 августа ставит на текст новых моделей Claude. Метка статистическая: как объясняет Anthropic, там, где модели одинаково подходят два слова, выбор между ними решает секретный ключ вместе с несколькими предыдущими словами, а не обычный генератор случайных чисел. Проверить текст может только владелец ключа. Детектор Anthropic открыт в закрытом режиме для организаций, которым такой доступ положен по закону ЕС: регуляторов, правоохранителей, СМИ, фактчекеров, независимых исследователей, учебных заведений и гражданских объединений ЕС, говорится в справке Claude. Там же сказано, что метка переживает копирование и вставку и «может сохраняться после некоторых правок». А полное переписывание стирает такие метки почти целиком. Детектор Atomic14 устроен иначе: он ищет не метку, а почерк.
Как устроен детектор
Метод автор взял из своей давней диссертации о криминалистической экспертизе документов, где по тексту выясняют, кто его написал: Шекспир ли автор пьесы, кто из федералистов написал какую статью, кто прислал письма с угрозами. Один из простых приёмов этой области - считать короткие цепочки символов, n-граммы, не обращая внимания на слова и синтаксис. Из фразы «the quick brown fox» после удаления пробелов, знаков и заглавных остаётся thequickbrownfox, и окно в четыре символа, сдвигаясь на одну позицию, даёт theq, hequ, equi и так далее до nfox. Текст превращается в таблицу частот, и дальше детектор видит только её.
Конвейер целиком такой. Из текста выбрасывается всё, кроме букв, включая пробелы, остальное приводится к нижнему регистру. Считаются все четырёхбуквенные цепочки, и каждый отрывок становится вектором из 60 211 чисел. Числа нормируются в доли, чтобы длина текста не влияла на результат. Вектор уходит в линейный SVM, который учится, какие цепочки у Claude встречаются чаще, а итог переводится в оценку от 0 до 1. И подсчёт, и классификатор - стандартные компоненты scikit-learn. Пунктуации, длины предложений, абзацев, заглавных букв и отдельных слов детектор не видит.
Человеческие тексты автор брал только опубликованные до 2021 года, до появления ChatGPT: книги с Project Gutenberg старше 1929 года, записи из Blog Authorship Corpus не позже 2004-го и новости из CC-News за 2016-2019 годы. Вышло 519 отрывков от 26 авторов: 180 из книг, 179 из новостей и 160 из блогов. Каждый отрывок Claude Opus 5 переписал трижды, с сохранением смысла, детализации и примерно той же длины, по трём инструкциям: «ясным естественным английским», «простым прямым современным английским» и «в формальном, точном регистре». Через batch API получилось 1 557 переписанных версий. Внутри каждой пары тема, факты и длина совпадают, так что различается только манера письма. Отдельно Claude написал с нуля тексты на те же темы, их в обучение не пустили и оставили для проверки.
Качество автор меряет ROC AUC: берётся случайный человеческий и случайный машинный отрывок, и считается доля пар, где машинный получил оценку выше. 0,5 соответствует подбрасыванию монеты, 1,0 значит, что детектор ни разу не перепутал порядок. Четырёх авторов из 26 отложили до начала работы, остальное оценивали кросс-валидацией, где авторы тестовой части не встречаются в обучающей. Разбивка по авторам, а не по отрывкам, тут принципиальна: иначе классификатор учится узнавать конкретных писателей, что он делает очень хорошо, но задача другая.
Почему не пять
Длину цепочки автор перебрал от одной буквы до восьми, ничего больше не меняя:
- 1 буква: 28 признаков, ROC AUC 0,651
- 2: 673 признака, 0,757
- 3: 8 590, 0,857
- 4: 60 211, 0,906
- 5: 214 949, 0,912
- 6: 444 691, 0,907
- 7: 668 979, 0,890
- 8: 843 596, 0,863
Всего 28 признаков, частоты отдельных букв, уже дают 0,651, заметно лучше монеты. Дальше точность круто растёт до четырёх, достигает пика на пяти и падает: длинные цепочки несут больше информации, пока для них хватает данных. Автор предполагает, что неплохо сработали бы и счётчики слов, но им, возможно, нужно больше данных. Цепочки с пропусками, из каждого второго или третьего символа, сделали результат намного хуже.
Пятёрки автор всё же отверг. Прибавка составляет шесть тысячных AUC при примерно втрое с половиной большем числе признаков, и проявляется она только на длинных текстах. Причина в разреженности: возможных четырёхбуквенных цепочек 457 тысяч, пятибуквенных 11,9 миллиона. В типичном отрывке корпуса на 2 259 букв 81% найденных четырёхбуквенных цепочек встречаются ровно один раз, у пятибуквенных таких 89%. На 200 буквах однократных уже 90% среди трёхбуквенных и 97% среди пятибуквенных.
Проверка на 320 ответах Claude на промпты из публичного бенчмарка против 320 исходных человеческих документов, с обрезкой текста, подтвердила выбор: четвёрки выигрывают на любой длине. На 100 буквах у них 0,645 против 0,630 у пятёрок, на 200 буквах 0,740, на 432 буквах 0,783, на 1 000 буквах 0,867 против 0,866. Короткие фрагменты остаются слабым местом: на сотне букв детектор ненамного лучше случайного.
Проверка на чужих текстах
Четыре отложенных автора дали 0,925, кросс-валидация 0,906. Близость этих чисел автора порадовала больше всего: значит, классификатор не выучил тайком конкретных писателей. Тексты с нуля, написанные Claude на темы тех же четырёх авторов и не попавшие в обучение, получили 0,977.
Затем детектор проверили на текстах, никак не связанных с обучающими данными. 175 записей из блога самого автора за 2006-2022 годы получили медианную оценку 0,09, выше 0,8 набрали 2% из них. Восемь отрывков Claude получили медиану 0,85, выше 0,8 оказались 63%, пять из восьми. Выборка на стороне Claude здесь крошечная.
Тест сложнее - RAID, публичный бенчмарк для детекторов машинного текста: шесть миллионов отрывков от 11 генераторов в восьми предметных областях. Автор взял 320 его промптов, получил на них ответы Claude Opus 5 и сравнил с 320 человеческими документами, из которых промпты выросли. Корпус другой, задача другая: тексты написаны с нуля, а не переписаны. Результат 0,889. Подсчёт четырёхбуквенных последовательностей без всякого понимания текста, подводит итог автор, примерно в 93% случаев отделяет человеческое письмо от его переписанной Claude версии на авторах, которых детектор никогда не читал. «Я не ожидал, что это сработает так хорошо», - признаётся он.
Что выдаёт Claude
Модель настолько простая, что её признаки можно прочитать. Для наглядности автор взял трёхбуквенные цепочки на «ясных» переписываниях. В сторону Claude тянут окончания -ing, наречия на -ly (ely, tly и ctl из entirely, directly, exactly), that, though и through, а ещё Ive, сокращение I've с выброшенным апострофом. В сторону человека тянут which, not, but, will, was, существительные на -tion и -ation, сочетания of the и of a, а также Iam и Iwi, I am и I will, написанные полностью.
На уровне отдельных букв сравнение каждой версии Claude с её исходником показывает, что меняется именно манера. В «ясных» и «прямых» версиях чаще встречаются g, h, l, y, а в «прямых» ещё w и k. Реже - i, c, f, s, m. По объяснению, которое автор получил у самого Claude, первая группа - буквы старого германского ядра английского (think, though, work, know, high), вторая - буквы слов, заимствованных из латыни и французского (consideration, significance, specific). Проверка на уровне слов это подтверждает: слов с латинскими окончаниями становится меньше, а средняя длина слова в «ясных» версиях почти не меняется. Claude выбирает другие слова, а не более короткие.
С инструкцией о формальном регистре картина зеркальная. Чаще становятся c, e, r, i, n, p, реже - h, w, k, l, o, g. Латинских окончаний больше, средняя длина слова растёт.
Формальный регистр
Отсюда главное ограничение. Автор собрал детектор дважды: на всех трёх инструкциях и только на «ясной» и «прямой», без формальной. Результаты (первое число - без формальных текстов в обучении, второе - со всеми тремя стилями):
- «ясные» переписывания: 0,827 и 0,899
- «прямые» переписывания: 0,879 и 0,900
- формальные переписывания: 0,153 и 0,977
- тексты с нуля, не входившие ни в одно обучение: 0,881 и 0,977
- отрывки RAID: 0,794 и 0,889
- восемь отрывков Claude против блога автора: 0,986 и 0,981
Версия без формальных текстов на них набирает 0,153 и уверенно считает их более человеческими, чем человеческие оригиналы рядом. Автор подчёркивает, что детектор не сломан и не запутался: он выучил правило «текст стал проще - значит, ИИ», получил текст, ставший формальнее, и ответил согласно этому правилу. Признаки, которые он ловит, выходит, привязаны к направлению правки, а не к Claude как таковому.
Обратный эффект любопытнее. Третий стиль в обучении поднял тексты с нуля с 0,881 до 0,977, хотя таких текстов не было ни в одном обучающем наборе, а RAID - с 0,794 до 0,889. Автор считает, что новые стили, вероятно, сделали бы детектор ещё более универсальным. Но тот же результат, по его словам, показывает, как детектор обмануть: попросить Claude писать в стиле, на котором детектор не обучался.
Детектор целиком работает в браузере, текст не покидает машину пользователя. Собственный пост автора, хоть он и заметно его правил, детектор относит к Claude.
Дальше
Непрямые продажи Anthropic бьют по марже лаборатории
Больше 40% ARR Anthropic во втором квартале 2026 года пришло через Bedrock, Foundry и Gemini Agent Enterprise, подсчитали аналитики рынка токенов. Гиперскейлер берёт с этих продаж долю, и лаборатория списывает её в маркетинг.
Читайте также
- Отказ в разговоре о суициде Anthropic считает провалом
- У Anthropic 94,2% верных находок, а curl отверг 19 из 34
- Открытый FlashProve доказывает, какая модель написала ответ
- Claude по просьбе отдал дамп памяти своей песочницы
- Невыпущенный Claude написал root-эксплойт для ядра Linux
- Claude после каждого ответа проверяет диалог на злоупотребления
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.