
Gemini Decisions API берёт до 1 000 вопросов за вызов
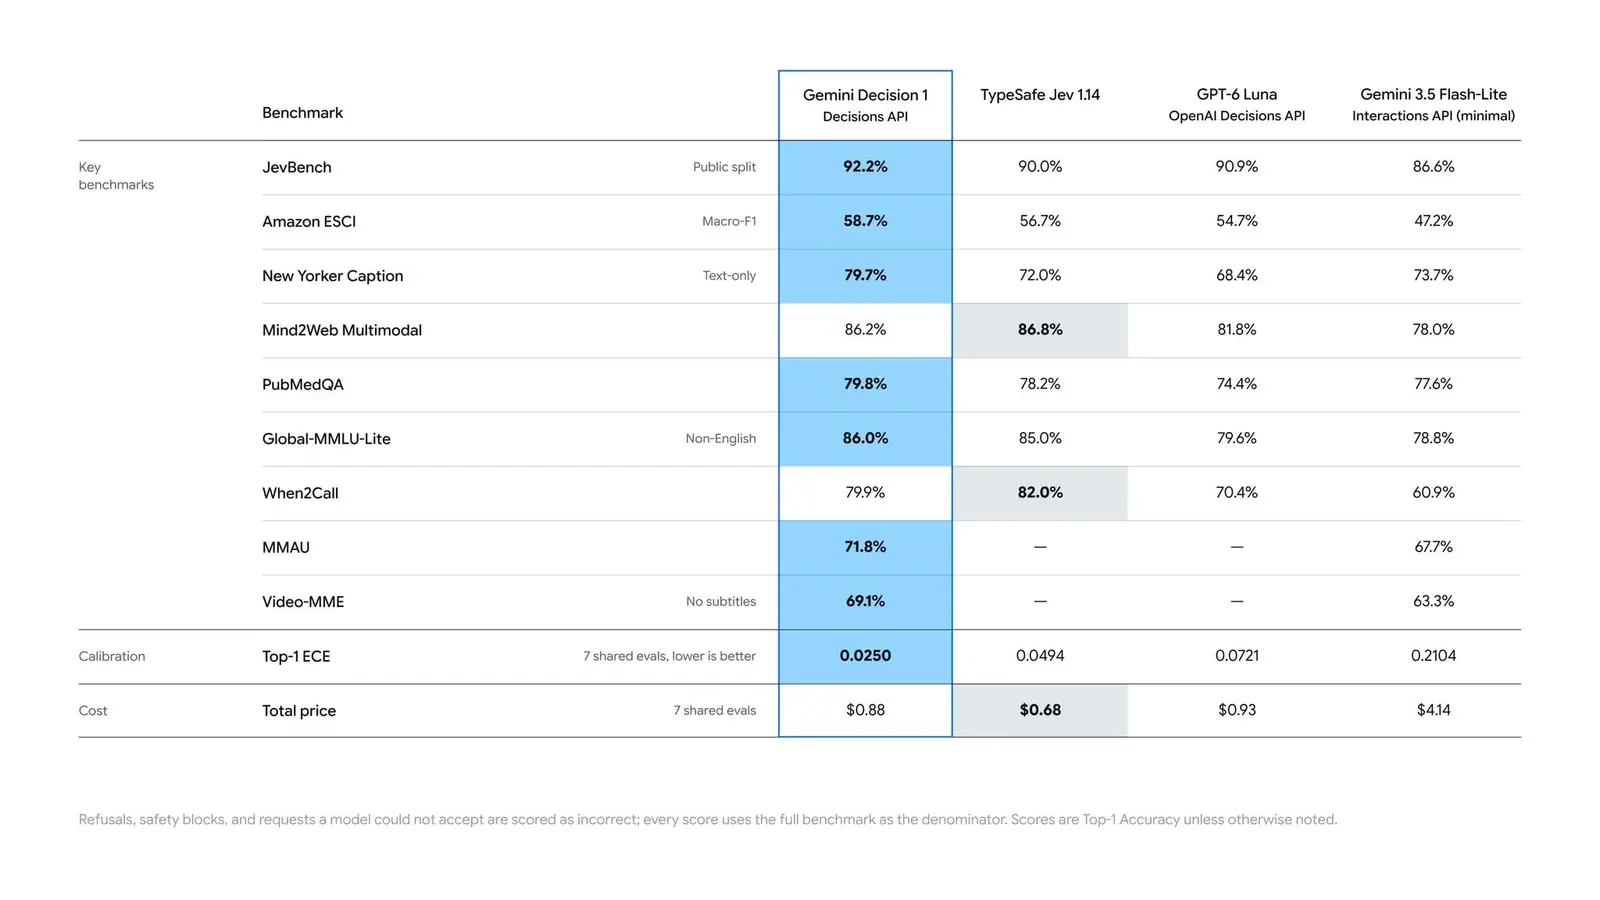
Google DeepMind 11 ноября открыла в Gemini API и Google AI Studio Decisions API на новой модели Gemini Decision 1. Модель не пишет ответ токен за токеном, а за один проход оценивает заданные варианты и возвращает вероятности: до 1 000 вопросов за запрос, 0,10 доллара за 1 млн входных токенов, выходные токены бесплатны. Если маршрутизация моделей, выбор инструментов или проверки политик у вас сейчас идут через генеративные вызовы, Google обещает счёт почти в 5 раз меньше, чем у Gemini 3.5 Flash-Lite. Но это замер самой Google на её наборе тестов, а по нашему расчёту из прайс-листа гарантирована лишь трёхкратная разница во входной цене.
Как описывает Google, запрос состоит из общего входа (текст, картинки, аудио, видео и PDF вперемешку) и набора независимых вопросов к нему. Вопросы бывают трёх типов, и их можно смешивать: да/нет (тип называется noul, и это не опечатка), выбор из 2-255 вариантов с нормированной вероятностью для каждого и оценка по упорядоченной шкале, начиная с нуля, с весовым баллом и вероятностями по уровням. Для вопроса да/нет вероятность по документации лежит в пределах 0,01-0,99. К каждому ответу прилагается уверенность, по которой код может отправить спорный случай на запасной путь или живому проверяющему.
Медианная задержка, по словам Google, составляет 50-100 мс вычислений модели и 150-250 мс от запроса до ответа. Обе цифры даны для контекстов до 16K токенов, и при росте числа вопросов в запросе с 1 до 100 задержка почти не меняется. Общий вход оплачивается один раз за запрос, а каждый вопрос добавляет только токены своей инструкции и критериев. Отдельных счетов за размышления, расшифровку аудио или OCR нет.
Внутри Google API уже работает как слой быстрых решений. Gemini Notebook через него раскидывает запросы по уровням моделей и глубине размышлений, и обычные запросы, как утверждает компания, обслуживаются с задержкой до 40% ниже. CC из Google Labs выбирает реакцию из палитры в 200 с лишним эмодзи, а Google Search поставил его защитным слоем для MCP-инструментов.
Авторский разбор
Что мы проверили
11 ноября мы сверили анонс с документацией и прайс-листом Google, посчитали стоимость по прайсу, прогнали запросы из google-genai 3.2.0 для Python и JS через тестовый сервер и без ключа опросили маршруты API.
Цена, лимит вариантов и условия замера задержки совпали с документацией. Две формулировки анонса шире неё. Окно в 262 144 токена одно на вход и все вопросы вместе: вход на 256K и 1 000 вопросов поверх него в запрос не помещаются. Уверенность для вопроса да/нет по формуле из документации держится между 0,5 и 0,99, хотя в анонсе обещана шкала от 0 до 1. Выигрыш «почти в 5 раз» зависит от того, сколько выходных токенов тратит Flash-Lite.
- При вопросах по 50 токенов вход на 256 000 токенов и 1 000 вопросов дают 306 000 токенов. Даже с пустым входом на каждый из 1 000 вопросов в среднем остаётся не больше 262 токенов.
- Пять раз получается, когда выход Flash-Lite вместе с размышлениями составляет 8% её входа. Против пакетного тарифа Flash-Lite та же нагрузка дешевле в 2,5 раза, а пакетного режима у Decisions API нет. Это наша арифметика: какие токены были в бенчмарке Google, компания не публиковала.
- Кэширования контекста, а также Batch, Flex и Priority нет, и повторяющийся вход каждый раз оплачивается полностью. На таких токенах Decision обходится в 3,33 раза дороже кэшированного чтения Flash-Lite по 0,03 доллара за 1 млн (без платы за хранение кэша, 1 доллар за 1 млн токенов в час). У OpenAI в октябре Decisions API вышел из беты с той же входной ценой 0,10 доллара, кэшированным чтением по 0,01 доллара и лимитом 400 вопросов за вызов.
| Общий вход, токенов | Вопросов | Выигрыш против одного пакетного вызова Flash-Lite | Против вызова Flash-Lite на каждый вопрос |
|---|---|---|---|
| 16 000 | 1 | 3,01x | 3,0x |
| 16 000 | 100 | 3,60x | 229,9x |
| 16 000 | 1 000 | 4,89x | 731,4x |
В расчёте для таблицы мы приняли 50 токенов на вопрос и 5 выходных токенов на ответ.
Перед первым запросом
Для прототипов в AI Studio есть бесплатный уровень. Интеграции с OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit и OpenCode Google называет раскатывающимися; листинг на OpenRouter во время нашей проверки уже работал, остальные мы не смотрели. Поддержку в Gemini в Google Cloud компания пока только обещает.
Методы для Decisions появились в google-genai 3.2.0. Её выложили в npm и PyPI 11 ноября, за считаные минуты до поста, документация требует SDK не ниже 3.2, а пакет для Python требует Python 3.11 или новее. Лимиты SDK на стороне клиента не проверяют: в наших прогонах запрос с 1 001 вопросом, выбор из 256 вариантов или из одного и запрос без вопросов ушли в сеть. По документации нарушения возвращает сервер с ошибкой HTTP 400, так что каждое стоит сетевого запроса. Python-клиент отбивает тип bool вместо noul ещё до отправки, а JS-клиент отправляет его как есть.
Строку api_version="v1beta" из примера Google лучше не убирать. Клиент по умолчанию в обоих SDK шлёт decisions.create на /v1/decisions, и без ключа этот маршрут вернул нам 404. /v1beta/decisions ответил 403 с требованием авторизации, значит, маршрут существует. С настоящим ключом мы это не проверяли, но по этим ответам выходит, что клиент без явной версии получит 404.
Дальше
Через задачу на GitHub Depi добралась до npm-пакета Codex
Цепочка, которая вела к публикации официального npm-пакета Codex, начиналась с обычной задачи на GitHub, текст которой шёл прямо в промпт агента. Исследователи Depi прошли её до конца, и OpenAI уже закрыла дыру. Текст чужих задач на GitHub вы отдаёте агенту напрямую или сначала читаете сами?
Читайте также
- Decider от Perplexity гоняет модель на Mac без счёта за API
- Decisions API от OpenAI вышел из беты с 400 вопросами за раз
- Jev обогнал OpenAI Decisions и Clef: 195 против 208 и 344 мс
- Модель выбора SubQ Snap берёт 384K токенов вместо 32K
- Decisions API от OpenAI вышел в публичную бету для всех
- В Agent Studio на GCP открыли доступ к Gemini 3.8 Flash
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.