
Microsoft переводит свои ИИ-сервисы на собственные чипы Maia
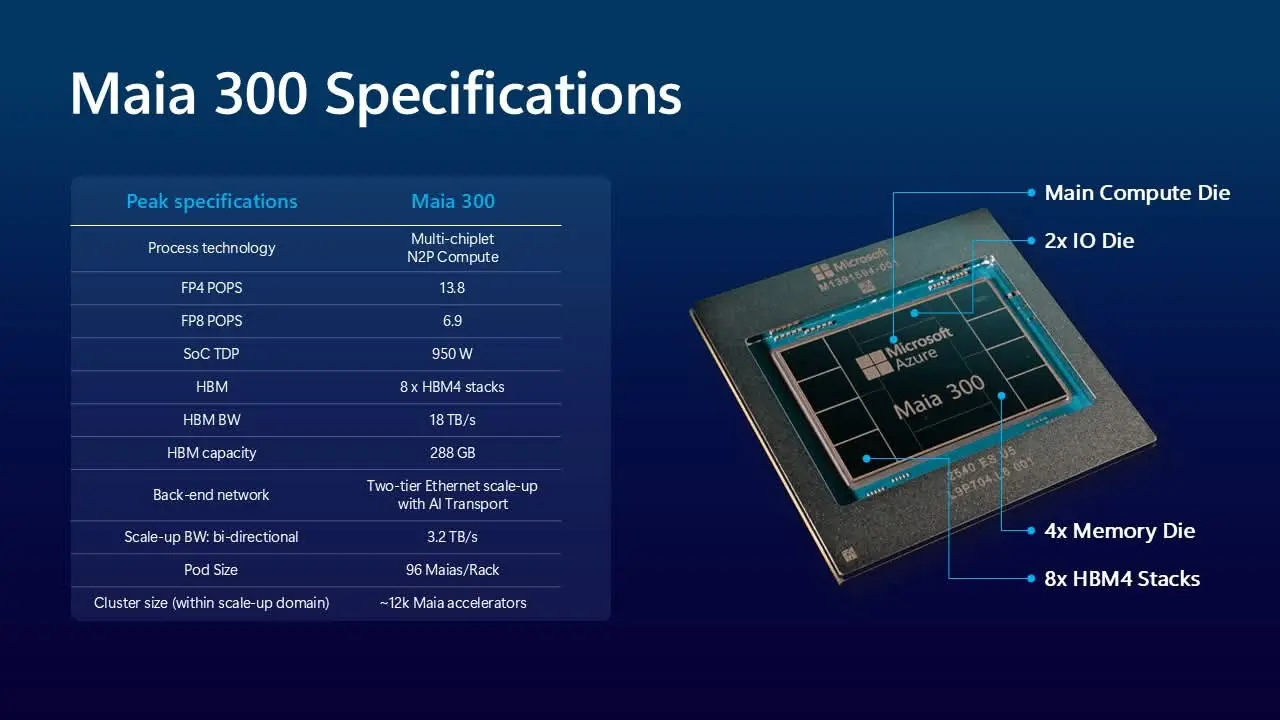
Microsoft с 2027 года начнёт разворачивать собственные ускорители Maia на мощностях в несколько гигаватт и сделает их основной системой инференса для своих продуктов и сервисов. Об этом глава облачного направления Скотт Гатри написал 12 октября в блоге Microsoft, там же компания впервые описала Maia 300.
Maia 300 - третье поколение программы, его промышленное развёртывание начнётся в 2027 году. Microsoft ожидает от него на 40% больше токенов на мегаватт, чем у ведущих GPU-систем, а полная стойка из 96 ускорителей, по оценке компании, выдаёт до 7 раз больше токенов, чем стойка на Maia 200. Какие именно GPU взяты для сравнения, Microsoft не уточнила.
Восемь стопок HBM4 на 950 ватт
Чип собран из нескольких чиплетов: вычисления, контроллеры памяти и ввод-вывод разнесены по отдельным кристаллам. Вычислительные чиплеты делает TSMC по техпроцессу N2P. Рядом стоят восемь стопок HBM4 с пиковой пропускной способностью 18,0 ТБ/с, и всё это укладывается в TDP 950 Вт.
Для сравнения, Maia 200, представленная 26 января, выпускается по 3-нанометровому процессу TSMC: 750 Вт, 216 ГБ HBM3e с пропускной способностью 7 ТБ/с и 272 МБ памяти SRAM на кристалле. У первой Maia 100, анонсированной в ноябре 2023 года, было 64 ГБ HBM2E на 1,8 ТБ/с. На ватт мощности Maia 300 даёт около 19 ГБ/с пропускной способности памяти против примерно 9 ГБ/с у Maia 200, примерно вдвое больше. Именно этот показатель Microsoft называет лучшим в индустрии.
Упор на память в компании объясняют так: «В крупных системах инференса узким местом всё чаще становится эффективное перемещение данных, а не голая вычислительная мощность». Отсюда архитектура, которую Microsoft называет программно-определяемым потоком данных: компилятор и ядра, которые подбираются в том числе с помощью ИИ, стараются держать данные ближе к месту вычислений и реже гонять их между памятью, вычислителями и сетью. Встроенная SRAM работает как программно управляемый буфер, чтобы снять часть нагрузки с HBM.
Второй рычаг - низкая точность. Maia 300 рассчитана на форматы вроде доработанного MXFP4, которые сокращают объём данных и в вычислениях, и в KV-кэше, где модель хранит промежуточные результаты по уже обработанному контексту. По словам Microsoft, в том же энергобюджете это даёт более длинные окна контекста и более высокую пропускную способность. Целевые нагрузки компания перечисляет сама: рассуждения на длинном контексте, чувствительные к задержке диалоги и многошаговые агентные задачи, где основное время уходит на генерацию токенов одного за другим.
Стойка на 167 киловатт
В стойке Maia 300 стоят 96 ускорителей в пределах 167 кВт. Вместе они дают 27,6 ТБ HBM и 1,7 ПБ/с суммарной пропускной способности памяти внутри одного домена масштабирования, где все чипы общаются как одна система. На один ускоритель приходится около 288 ГБ HBM, у Maia 200 было 216 ГБ.
Связь между ускорителями оптимизирована под тензорный параллелизм, а между стойками работает собственный транспортный протокол Microsoft поверх обычной Ethernet-инфраструктуры. Компания обещает единую топологию от одной стойки до масштаба дата-центра. Подход тот же, что и в предыдущем поколении: Maia 200 тоже использует стандартный Ethernet со своим транспортным уровнем, 2,8 ТБ/с двунаправленной пропускной способности на ускоритель и поддерживает коллективные операции в кластерах до 6 144 устройств.
С чем сравнивает Microsoft
Все три сравнительные цифры дала сама компания, и условия у них разные. 40% больше токенов на мегаватт - это ожидание для Maia 300 против «ведущих GPU-систем». До 7 раз больше токенов на стойку - сравнение Maia 300 в полной конфигурации на 96 ускорителей с Maia 200. А до 1,7 раза больше токенов на ватт - уже измеренный результат Maia 200 на встроенных ИИ-функциях Microsoft Teams, Copilot и Cowork против «ведущей GPU-инфраструктуры».
Архитектурные детали Maia 300 Microsoft вынесла в отдельную техническую статью, а о стратегии обещает рассказать в ноябре на Ignite 2026 в Сан-Франциско.
Где Maia 200 уже работает
Maia 200 разворачивается в США, Европе и Австралии. Она обслуживает рабочие нагрузки Microsoft, включая Microsoft Copilot, и помогает команде MAI разрабатывать модели следующего поколения. На этих чипах крутятся модели OpenAI, собственные модели MAI и популярные открытые семейства.
Дальше два поколения Maia должны взять на себя агентные сценарии GitHub для работы с кодом, развёртывание моделей разных архитектур в Microsoft Foundry, инференс и генерацию данных для MAI, а также чувствительные к задержке диалоги в Dragon Copilot, который снимает с врачей часть бумажной работы.
GitHub Copilot и Microsoft Foundry перейдут на Maia 200 до конца этого года.
Дальше
Под вывеской Opus 5.5 пользователи ловят новую модель
За выходные Claude Opus 5.5 заметно прибавил, и пользователи X подозревают, что часть запросов тихо уходит на новую модель. Один из них получил 3D-сцену с нуля по промпту в одно предложение, через Blender MCP и два часа работы. Бывало, что Opus 5.5 вдруг отвечал вам заметно лучше обычного?
Читайте также
- Google собрала TPU 8i Max из двух чипов под длинный контекст
- Copilot на Copilot+ PC начнёт считать часть задач локально
- MAI-Base-2 в 4–12 раз экономнее DeepSeek на предобучении
- MAI-Transcribe-2 получил потоковую версию для голосовых агентов
- Mythos поднял Claude на AMD за 3 дня вместо 6-12 месяцев
- Колетт Кресс временно сменила Хуанга во главе NVIDIA
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.